





CI/CD 개발 가이드라인
GitLab v19.4요약
CI/CD 파이프라인은 GitLab 개발 및 배포 프로세스의 핵심 구성 요소로, 코드 변경 사항의 빌드, 테스트, 배포와 같은 작업을 자동화합니다. 이 문서는 CI/CD 파이프라인을 안전하고 효과적으로 사용하는 기능을 개발하는 데 도움이 되는 가이드라인을 제공합니다.
CI/CD 파이프라인은 GitLab 개발 및 배포 프로세스의 핵심 구성 요소로, 코드 변경 사항의 빌드, 테스트, 배포와 같은 작업을 자동화합니다. 파이프라인과 상호작용하거나 파이프라인을 트리거하는 기능을 개발할 때는 이러한 동작이 시스템의 보안과 운영 무결성에 미치는 광범위한 영향을 반드시 고려해야 합니다.
이 문서는 CI/CD 파이프라인을 안전하고 효과적으로 사용하는 기능을 개발하는 데 도움이 되는 가이드라인을 제공합니다. 파이프라인 실행이 미치는 영향을 이해하고, 인증 토큰을 책임감 있게 관리하며, 개발 프로세스 초기부터 보안 고려 사항을 반영하는 일의 중요성을 강조합니다.
일반 가이드라인#
- 파이프라인을 쓰기 작업으로 인식합니다: 파이프라인 트리거는 시스템 상태를 변경하는 쓰기 작업입니다. 이 쓰기 작업은 배포를 시작하거나, 테스트를 실행하거나, 구성을 변경할 수 있습니다. 무단 변경이나 시스템 오용을 막기 위해 파이프라인 트리거를 다른 중요한 쓰기 작업과 같은 수준으로 신중하게 다룹니다.
- 파이프라인 실행은 명시적인 동작이어야 합니다: 사용자 컨텍스트에서 파이프라인을 생성하는 동작은 그 동작을 수행할 때 파이프라인(또는 단일 job)이 시작된다는 점을 사용자가 명확히 알 수 있도록 설계해야 합니다. 사용자는 파이프라인에서 실행되는 변경 사항을 실행 전에 인지해야 합니다.
- 원격 실행과 격리: CI/CD 파이프라인은 job이 광범위한 동작을 수행하는 스크립트를 실행할 수 있는 원격 실행 환경으로 동작합니다. job이 충분히 격리되어 있고 민감한 데이터나 시스템이 의도치 않게 노출되지 않도록 보장합니다.
- AppSec 팀 및 Verify 팀과 협업합니다: Application Security (AppSec) 팀과 Verify 팀의 구성원을 설계 프로세스 초기와 제안서 작성 단계에 참여시킵니다. 이들의 전문 지식은 잠재적인 보안 위험을 식별하고 기능 초기부터 보안 고려 사항이 반영되도록 하는 데 도움이 됩니다. 또한 취약점을 식별하고 보안 표준 준수를 확인하는 전문 지식을 활용할 수 있도록 코드 리뷰 프로세스에도 참여시킵니다.
- 파이프라인 행위자를 파악합니다: 파이프라인을 트리거하는 기능을 만들 때는 어떤 사용자가 파이프라인을 시작하는지 고려해야 합니다. 이벤트의 행위자가 누구여야 하는지 결정합니다. 사용자가 직접 파이프라인을 트리거하는 의도적인 실행인지(예: 리포지터리에 변경 사항을 푸시하거나 "Run pipeline" 버튼을 선택하는 경우), 아니면 GitLab 시스템이나 정책이 시작한 실행인지 구분합니다. 파이프라인을 생성하는 사용자가 변경 사항의 작성자가 아닌 시나리오는 피합니다. 두 사용자가 다르면 변경 사항의 작성자가 파이프라인 사용자의 컨텍스트에서 코드를 실행할 수 있는 위험이 있습니다. 행위자를 파악하면 권한을 관리하고 파이프라인이 올바른 실행 컨텍스트에서 실행되도록 하는 데 도움이 됩니다.
- job 실행 사용자의 가변성: 특정 job을 실행하는 사용자가 파이프라인을 생성한 사용자와 다를 수 있습니다.
대부분의 경우 사용자는 동일하지만, 수동 job을 실행하거나 job을 재시도하는 경우처럼 job의 사용자가 바뀌는
시나리오도 있습니다. 이러한 가변성은 job 실행 컨텍스트의 권한과 접근 수준에 영향을 줄 수 있습니다.
CI/CD job 토큰(
CI_JOB_TOKEN)을 사용하는 기능을 개발할 때는 항상 이 가능성을 고려합니다. job 사용자가 바뀌어야 하는지, 그리고 그 동작의 행위자가 누구인지 검토합니다. - 작업 범위를 제한합니다: CI/CD job 토큰과 함께 사용할 새 엔드포인트를 활성화할 때는 보안 강화를 위해 작업을 동일한 job, 파이프라인 또는 프로젝트로 제한하는 방안을 적극적으로 검토합니다. 더 넓은 범위(프로젝트)보다 더 좁은 범위(job)를 우선합니다. 예를 들어 파이프라인 데이터 접근을 허용한다면 프로젝트 간 또는 파이프라인 간 데이터 노출을 막기 위해 현재 파이프라인으로 제한합니다. 해당 기능에 프로젝트 간 또는 파이프라인 간 접근이 실제로 필요한지 평가합니다. 범위를 제한하면 보안 위험이 줄어듭니다.
- 활동을 모니터링하고 감사합니다: 기능이 감사 가능하고 모니터링 가능하도록 보장합니다. 파이프라인 사용자, 동작을 시작한 행위자, 이벤트 세부 정보를 포함해 파이프라인을 트리거하는 이벤트의 상세 로그를 도입합니다.
기타 가이드#
CI/CD 관련 개발 가이드는 다음과 같습니다.
- 새 CI/CD 템플릿을 만드는 경우 GitLab CI/CD 템플릿 개발 가이드를 참고합니다.
- 새 키워드를 추가하거나 CI 스키마를 변경하는 경우 다음 가이드를 참고합니다.
- 린팅이나 파이프라인 생성처럼 핵심 CI/CD 프로세스를 변경하는 경우 CI/CD 테스트 가이드를 참고합니다.
CI/CD YAML syntax reference 페이지를 업데이트하는 방법은 CI/CD YAML reference 문서 가이드를 참고합니다.
메트릭#
이 섹션에서는 엔지니어가 개발, 변경 검증, 장애 조사 과정에서 활용할 수 있는 대시보드와 메트릭을 설명합니다.
- 모든 GitLab 팀용 대시보드를 사용할 수 있습니다. 관심 있는 기능 카테고리를 소유한 팀을 검색할 수 있습니다.
- Pipeline Execution error budget 대시보드에는 파이프라인 생성과 job 실행에 관한 또 다른 유용한 메트릭이 포함되어 있습니다.
- 운영 로그도 Kibana에서 검색하고 집계할 수 있는 유용한 정보를 많이 제공합니다.
- Pipeline creation 대시보드는 파이프라인 생성에 관련된 단계들을 유용하게 분해해 보여줍니다. 이 대시보드에는 생성에 시간이 더 오래 걸리거나 job이 많은 "느린 파이프라인"의 데이터만 포함됩니다. SQL의 "slow query log"와 비슷합니다.
- CI partitioning 대시보드에는 현재 파티션 번호, 파티션 크기, 배큐밍, 기타 데이터베이스 메트릭에 대한 정보가 포함되어 있습니다.
CI/CD 사용 예시#
GitLab은 ci-sample-projects 그룹을 유지 관리하며, 이 그룹에는 GitLab CI/CD의 다양한
사용 사례에 대한 .gitlab-ci.yml 예시를 보여주는 프로젝트가 있습니다. 여러 시나리오에 사용할 수 있는
특정 구문도 다룹니다.
CI 아키텍처 개요#
다음은 CI 아키텍처를 단순화한 다이어그램입니다. 주요 구성 요소에 집중하기 위해 일부 세부 사항은 생략했습니다.
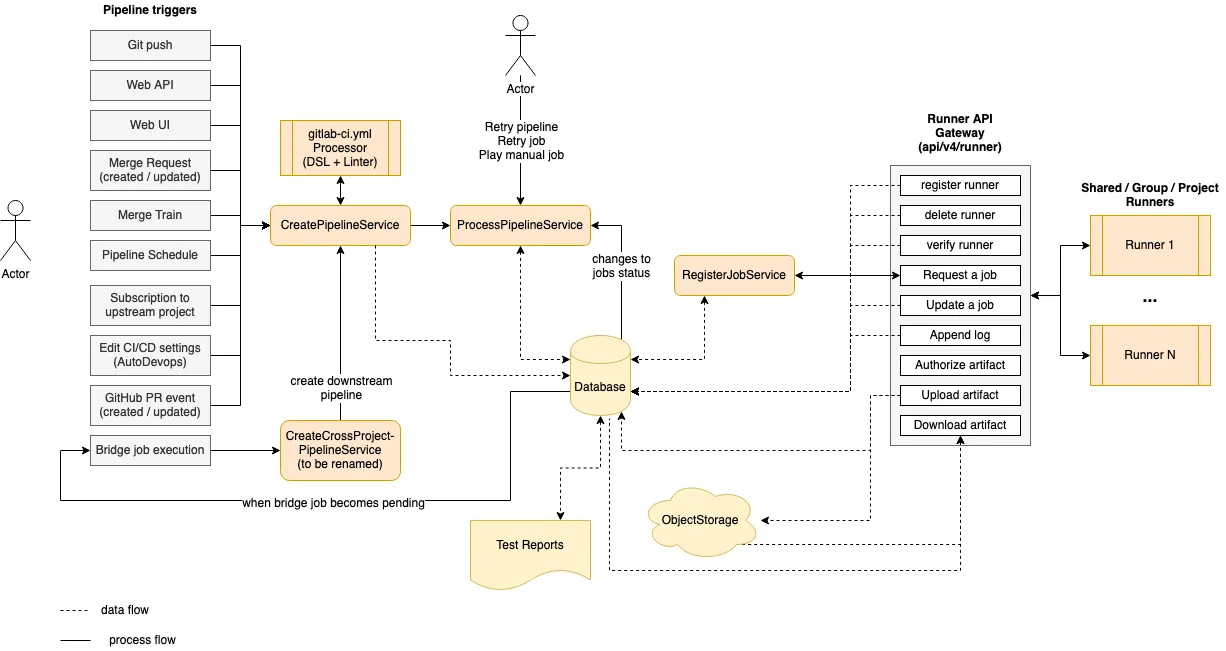
왼쪽에는 다양한 이벤트(사용자 또는 자동화가 트리거함)를 기반으로 파이프라인을 트리거할 수 있는 이벤트가 있습니다.
git push는 파이프라인을 트리거하는 가장 일반적인 이벤트입니다.- Web API.
- 사용자가 UI에서 "Run pipeline" 버튼을 선택하는 경우.
- 머지 리퀘스트가 생성되거나 업데이트될 때.
- MR이 Merge Train에 추가될 때.
- 예약된 파이프라인.
- 프로젝트가 업스트림 프로젝트를 구독할 때.
- Auto DevOps가 활성화될 때.
- GitHub 통합을 외부 풀 리퀘스트와 함께 사용할 때.
- 업스트림 파이프라인에 다운스트림 파이프라인을 트리거하는 트리거 job이 포함될 때.
이러한 이벤트 중 하나라도 트리거되면 CreatePipelineService가 호출되며,
이 서비스는 이벤트 데이터와 트리거한 사용자를 입력으로 받아 파이프라인 생성을 시도합니다.
CreatePipelineService는 YAML Processor
컴포넌트에 크게 의존합니다. 이 컴포넌트는 YAML 블롭을 입력으로 받아 파이프라인의 추상 데이터 구조(Stage와
모든 job 포함)를 반환합니다. 또한 처리 과정에서 YAML의 구조를 검증하고 구문 오류나 의미 오류를
반환합니다. YAML Processor 컴포넌트는 파이프라인을 구성하는 데 사용할 수 있는
모든 키워드를 정의하는 곳입니다.
CreatePipelineService는 YAML Processor가 반환한 추상 데이터 구조를 받아
이를 영속 모델(파이프라인, Stage, job 등)로 변환합니다. 그 후 파이프라인은 처리할 준비가
됩니다. 파이프라인 처리란 다음 중 하나가 발생할 때까지 실행 순서(Stage 또는 needs)에 따라
job을 실행하는 것을 의미합니다.
- 예상된 모든 job이 실행됩니다.
- 실패로 파이프라인 실행이 중단됩니다.
파이프라인을 처리하는 컴포넌트는 ProcessPipelineService이며 다음을 처리합니다.
- 실행 준비가 된 job은
pending, 의존 job을 기다리는 job은created로 초기 상태를 설정합니다 - 최근에 완료된 의존 job을 기준으로 job을
pending으로 업데이트합니다 - job 모음의 전체 상태에 맞게 파이프라인과 Stage를 업데이트합니다
다이어그램 오른쪽에는 GitLab 인스턴스에 연결된 러너 목록이
있습니다. 인스턴스 러너, 그룹 러너, 프로젝트 러너가 여기에 해당합니다.
러너와 Rails 서버 사이의 통신은 Runner API Gateway로 묶인 API 엔드포인트 집합을 통해
이루어집니다.
러너는 등록, 삭제, 검증할 수 있으며 이 과정에서도 데이터베이스에 읽기/쓰기 쿼리가 발생합니다. 러너가 연결되면
실행할 다음 job을 계속 요청합니다. 이때 RegisterJobService가 호출되어
다음 job을 선택하고 러너에 할당합니다. 이 시점에 job은 running 상태로 전환되며,
상태 변경으로 인해 ProcessPipelineService가 다시 트리거됩니다.
자세한 내용은 job 스케줄링)을 참고합니다.
job이 실행되는 동안 러너는 로그와 저장해야 하는 아티팩트를 서버로 전송합니다. 또한 job은 실행을 위해 이전 job의 아티팩트에 의존할 수 있습니다. 이 경우 러너는 전용 API 엔드포인트로 아티팩트를 내려받습니다.
아티팩트는 오브젝트 스토리지에 저장되고 메타데이터는 데이터베이스에 보관됩니다. 아티팩트의 대표적인 예는 머지 리퀘스트에서 파싱되어 표시되는 리포트(JUnit, SAST, DAST 등)입니다.
job 상태 전환이 모두 자동인 것은 아닙니다. 사용자는 수동 job을 실행하거나, 파이프라인을 취소하거나,
실패한 특정 job 또는 파이프라인 전체를 재시도할 수 있습니다. job의 상태를
변경하는 모든 동작은 ProcessPipelineService를 트리거하며, 이 서비스가
파이프라인 전체의 상태를 추적하는 역할을 맡기 때문입니다.
특수한 유형의 job으로 트리거 job이 있으며, pending 상태로 전환될 때
서버 측에서 실행됩니다. 이 job은 다중 프로젝트 파이프라인이나 하위 파이프라인 같은 다운스트림 파이프라인을
생성하는 역할을 합니다. 다운스트림 파이프라인이 트리거될 때마다
워크플로 루프가 CreatePipelineService에서 다시 시작됩니다.
CI Backend Architectural Walkthrough에서 아키텍처를 설명하는 영상을 볼 수 있습니다.
파이프라인 처리#
파이프라인이 생성되면 ProcessPipelineService가 Ci::InitialPipelineProcessWorker를 통해 자동으로 실행됩니다.
이 서비스는 job의 상태가 바뀔 때마다 PipelineProcessWorker를 통해서도 트리거됩니다.
이 서비스는 파이프라인의 모든 job을 다음 중 하나로 설정해 완료 상태로 옮기는 역할을 합니다.
- 요구 사항이 충족되어 실행할 준비가 되었고 러너가 가져갈 수 있는 job은
pending상태 - 대기해야 하는 job은
created상태로 두고processed를true로 표시
job은 실행 후 성공적으로 완료되거나 실패할 수 있습니다. 파이프라인 안에서 job의 상태 전환이 일어날 때마다 이 서비스가 다시 트리거되어 완료 단계로 전환할 다음 job을 찾습니다. 그 과정에서 ProcessPipelineService는 job, Stage, 파이프라인 전체의 상태를 업데이트합니다. 추가 처리가 필요한 job이 있으면 이 서비스는 자신을 다시 예약합니다.
processed 플래그는 "처리 필요" 표시로 동작하며 상태 전환마다 false로 초기화됩니다. 이를 통해 job의 상태가 바뀔 때마다 그 변경이 Stage와 파이프라인 수준으로 전파되고, DAG의 이후 빌드와 다음 빌드를 pending으로 표시할 수 있습니다. 상태가 파이프라인과 Stage까지 전파되기 전에는 job이 processed로 표시되지 않습니다.
재시도 동작과 자가 복구#
PipelineProcessWorker는 지수 백오프를 사용해 간헐적인 오류가 발생했을 때 파이프라인에 자가 복구 기능을 제공합니다.
데이터베이스 타임아웃, Redis 오류, 메모리 부족 같은 일시적 문제로 처리가 실패하면 워커는 지연 시간을 늘려 가며 재시도합니다.
이 워커는 멱등이며 job과 파이프라인의 need_processing?를 확인하므로 여러 번 실행해도
안전합니다. 이 재시도 메커니즘은 모든 job이 완료되었는데도 처리 중 일시적 오류로 파이프라인이 완료로
표시되지 않은 경우를 바로잡을 수 있습니다.
job 스케줄링#
파이프라인이 생성되면 모든 Stage의 job이 created 초기 상태로 한 번에 생성됩니다. 덕분에 파이프라인의 전체 내용을 확인할 수 있습니다.
created 상태의 job은 아직 러너에 보이지 않습니다. job을 러너에 할당하려면 먼저 pending 상태로 전환되어야 하며, 다음 조건에서 전환됩니다.
- job이 파이프라인의 첫 번째 Stage에 생성된 경우.
- job이 수동 시작을 요구했고 실제로 트리거된 경우.
- 이전 Stage의 모든 job이 성공적으로 완료된 경우. 이때 다음 Stage의 모든 job이
pending으로 전환됩니다. - job이
needs:로 의존성을 지정했고 의존하는 job이 모두 완료된 경우. - job이 실행 불가 상태 때문에
Ci::PipelineCreation::DropNotRunnableBuildsService에 의해 드롭되지 않은 경우.
러너가 연결되면 서버를 계속 폴링하면서 실행할 다음 pending job을 요청합니다.
러너가 GitLab과 상호작용할 때 사용하는 API 엔드포인트는 lib/api/ci/runner.rb에 정의되어 있습니다
서버는 요청을 받은 뒤 Ci::RegisterJobService 알고리즘에 따라 pending job을 선택하고, 그 job을 러너에 할당해 전송합니다.
현재 Stage의 모든 job이 완료되면 서버는 다음 Stage의 모든 job 상태를 pending으로 변경해 "잠금을 해제"합니다. 이렇게 해제된 job은 러너가 새 job을 요청할 때 스케줄링 알고리즘이 선택할 수 있으며, 모든 Stage가 완료될 때까지 이 과정이 이어집니다.
러너와 GitLab 서버 간 통신#
러너가 등록 토큰으로 등록되면 서버는 그 러너가 실행할 수 있는 job 유형을 파악합니다. 이는 다음에 따라 달라집니다.
- 러너가 등록된 유형:
- 인스턴스 러너
- 그룹 러너
- 프로젝트 러너
- 연결된 태그.
러너는 POST /api/v4/jobs/request로 실행할 job을 요청하면서 통신을 시작합니다. 폴링은 몇 초마다 일어나지만, job 큐가 변하지 않으면 HTTP 헤더 기반 캐싱을 활용해 서버 측 부하를 줄입니다.
이 API 엔드포인트는 Ci::RegisterJobService를 실행하며, 이 서비스는 다음을 수행합니다.
pendingjob 풀에서 실행할 다음 job을 선택합니다- 그 job을 러너에 할당합니다
- API 응답으로 러너에 job을 전달합니다
Ci::RegisterJobService#
이 서비스는 최상위 쿼리 3개로 대부분의 job을 수집하며, job은 러너가 등록된 수준에 따라 선택됩니다.
- 인스턴스 러너용 job 선택(인스턴스 전체)
- 실행 중인 빌드가 적은 프로젝트를 우선하는 공정 스케줄링 알고리즘을 사용합니다
- 그룹 러너용 job 선택
- 프로젝트 러너용 job 선택
이 job 목록은 job 태그와 러너 태그를 대조해 한 번 더 필터링됩니다.
job에 태그가 있으면 러너는 모든 태그가 일치하지 않는 한 그 job을 가져가지 않습니다. 러너는 job에 정의된 것보다 많은 태그를 가질 수 있지만 그 반대는 성립하지 않습니다.
마지막으로 러너가 태그가 지정된 job만 가져갈 수 있는 경우, 태그가 없는 job은 모두 걸러집니다.
이 시점에 남은 pending job을 순회하면서 추가 정책에 따라 러너가 "가져갈 수 있는" 첫 번째 job을 할당하려고 시도합니다. 예를 들어 protected로 표시된 러너는 보호된 브랜치를 대상으로 실행되는 job(예: 프로덕션 배포)만 가져갈 수 있습니다.
풀의 러너 수가 늘어나면 같은 job이 서로 다른 러너에 할당되면서 충돌이 발생할 가능성도 커집니다. 이를 막기 위해 충돌 오류를 안전하게 복구하고 목록의 다음 job을 할당합니다.
멈춘 빌드 드롭#
빌드를 "멈춤" 상태로 표시하고 드롭하는 방법은 두 가지입니다.
- 빌드가 생성될 때
Ci::PipelineCreation::DropNotRunnableBuildsService가 job을 실행 불가로 만드는, 사전에 알 수 있는 조건을 확인합니다. - 빌드를 가져갈 수 있는 러너가 없으면 1시간 후
Ci::StuckBuilds::DropPendingService에 의해 드롭됩니다.- job이 24시간 안에 러너에 선택되지 않으면 그 시간이 지난 후 처리 큐에서 자동으로 제거됩니다.
- 대기 중인 job이 멈췄고 처리할 수 있는 러너가 없으면 1시간 후 큐에서 제거됩니다.
- 두 경우 모두 job의 상태는 적절한 실패 사유와 함께
failed로 변경됩니다.
이러한 차이가 있는 이유#
컴퓨팅 분 할당량 메커니즘은 대부분의 경우 변하지 않는 판단이기 때문에 job이 생성될 때 미리 처리합니다. 프로젝트가 한도를 초과하면 다음 달이 시작될 때까지 이후의 모든 해당 job에 같은 판단이 적용됩니다. 물론 프로젝트 소유자가 추가 분을 구매할 수 있지만, 이는 프로젝트가 직접 수행해야 하는 수동 작업입니다.
allowed_plans에도 곧 같은 메커니즘이 적용됩니다.
프로젝트가 필요한 플랜이 아닌데 job이 해당 러너를 대상으로 한다면,
프로젝트 소유자가 구성을 변경하거나 네임스페이스를 필요한 플랜으로 업그레이드할 때까지 계속 실패합니다.
두 메커니즘 모두 GitLab.com에만 적용되며 대규모 환경에서는 상당한 컴퓨팅 자원을 소비합니다. job이 pending으로 전환되기도 전에 검사해 일찍 실패시키는 방식이 여기에서는 합리적입니다.
대기 중인 다른 경우까지 조기에 드롭하지 않는 이유는 다음과 같습니다. 러너가 job을 가져가는 속도가 느려서 job이 대기 상태에 머무는 경우도 있습니다. 이는 GitLab 수준에서는 알 수 없는 사항입니다. 러너의 구성과 용량, GitLab 큐의 크기에 따라 job은 즉시 선택될 수도 있고 대기해야 할 수도 있습니다.
다른 이유도 있습니다.
- 러너를 유지 보수하는 중이어서 일시적으로 사용할 수 없습니다.
- 구성을 업데이트하다가 실수로 잘못된 태그나 protected 플래그를 사용했습니다.
- GitLab.com 인스턴스 러너에 잘못된 비용 계수나
allowed_plans구성을 지정했습니다.
이러한 문제는 대개 일시적이며 빠르게 감지하고 해결할 수 있습니다. 이런 조건이 발생했다고 해서 job을 즉시 드롭하는 것은 바람직하지 않습니다. 러너가 용량 한계에 도달했거나 일시적인 사용 불가 또는 구성 실수가 있다는 이유만으로 job을 드롭하면 사용자에게 큰 피해를 줍니다.
job 트레이스 청크 아키텍처#
GitLab.com에서는 러너가 트레이스를 보내면 그 내용이 job ID와 인덱스를 담은 키와 함께 redis_trace_chunks Redis 클러스터에 저장됩니다.
각 청크를 추적하기 위해 Ci::BuildTraceChunk 레코드도 생성됩니다. 이 레코드는 해당 청크의 현재 데이터 저장소를 나타냅니다. GitLab
설치의 관리자는 어떤 데이터 저장소를 사용할지 구성할 수 있습니다. GitLab.com이 아닌 인스턴스에서는 ci_job_live_trace_enabled?가 활성화된 경우에도 이 동작이 일어납니다.
수명 주기#
- 트레이스 추가 단계
- 러너 →
PATCH /api/v4/jobs/1/trace(트레이스 내용 전송) Ci::AppendBuildTraceService가 라이브 저장소(GitLab.com의 Redis 트레이스 청크 클러스터)에 청크 데이터를 저장합니다- PostgreSQL에
data_store: redis_trace_chunks로Ci::BuildTraceChunk레코드를 생성합니다 - 트레이스 메타데이터를 추적할
Ci::BuildTraceMetadata레코드를 생성합니다 - 러너에 200 OK를 반환합니다
build.trace_chunks에는data_store가redis_trace_chunks이거나 다른 라이브 저장소인 레코드가 포함됩니다
- 러너 →
- job 업데이트 단계
- 러너 →
PUT /api/v4/jobs/1(job 업데이트) - 이 엔드포인트는
Ci::BuildTraceChunkFlushWorker도 실행합니다 Ci::BuildTraceChunkFlushWorker가 Redis 트레이스 청크 클러스터에서 청크 데이터를 가져옵니다- 청크를 오브젝트 스토리지로 복사합니다(청크마다 개별 파일 생성)
- 라이브 데이터 저장소(GitLab.com의
redis_trace_chunks클러스터)에서 라이브 청크를 삭제합니다 - PostgreSQL의
Ci::BuildTraceChunk레코드를data_store: fog로 업데이트합니다 - 러너에 200 OK를 반환합니다
build.trace_chunks에는data_store가fog이거나 다른 영속 저장소인 레코드가 포함됩니다
- 러너 →
- job 완료 및 아카이브 단계
- 러너 →
PUT /api/v4/jobs/1(job 완료) Ci::BuildFinishedWorker를 트리거합니다Ci::ArchiveTraceWorker가 오브젝트 스토리지에서 모든 fog 청크를 가져옵니다type: :trace인JobArtifact로 통합 아카이브 파일 하나를 생성합니다- 오브젝트 스토리지에서 개별 청크를 삭제합니다
- PostgreSQL에서
Ci::BuildTraceChunk레코드를 삭제합니다Ci::Build::Trace가live에서archived상태로 바뀝니다
- 러너에 200 OK를 반환합니다
build.trace_chunks는 빈 배열이 됩니다
- 러너 →
소스 코드 보기
sequenceDiagram
participant Runner
participant API
participant Redis as Redis Trace Chunks
participant ObjectStorage as Object Storage
participant PostgreSQL
participant Archive as Archive Storage
Note over Runner, Archive: 1. Trace Append Phase
Runner->>API: PATCH /api/v4/jobs/1/trace<br/>(trace contents)
API->>Redis: Ci::AppendBuildTraceService<br/>stores chunk data
API->>PostgreSQL: Create Ci::BuildTraceChunk<br/>(data_store: redis_trace_chunks)
API->>Runner: 200 OK
Note over Runner, Archive: 2. Job Update Phase
Runner->>API: PUT /api/v4/jobs/1<br/>(job update)
API->>Redis: Ci::BuildTraceChunkFlushWorker<br/>retrieves chunk data
API->>ObjectStorage: Copy chunk to storage<br/>(each chunk = own file)
API->>Redis: Delete chunk in redis
API->>PostgreSQL: Update Ci::BuildTraceChunk<br/>(data_store: fog)
API->>Runner: 200 OK
Note over Runner, Archive: 3. Job Completion & Archive Phase
Runner->>API: PUT /api/v4/jobs/1<br/>(job completion)
API->>API: Trigger Ci::BuildFinishedWorker
API->>ObjectStorage: Ci::ArchiveTraceWorker<br/>retrieves all fog chunks
API->>Archive: Create single archive file
API->>ObjectStorage: Delete individual chunks
API->>PostgreSQL: Update Ci::Build::Trace<br/>(live → archived)
API->>Runner: 200 OK</code></pre></details></div>
모니터링 리소스#
GitLab CI/CD에서 "Job"의 정의#
GitLab CI 컨텍스트에서 "Job"은 지속적 통합, 지속적 전달, 지속적 배포를 이끄는 작업을 가리킵니다.
일반적으로 파이프라인은 여러 Stage를 포함하고, Stage는 여러 job을 포함합니다.
Active Record 모델링에서 Job은 CommitStatus 클래스로 정의됩니다.
그 위에 다음과 같은 job 유형이 있습니다.
Ci::Build ... 러너가 실행하는 job입니다.Ci::Bridge ... 다운스트림 파이프라인을 트리거하는 job입니다. (트리거 job 참고)GenericCommitStatus ... Jenkins 같은 외부 CI/CD 시스템에서 실행되는 job입니다.
코드베이스에서 "Job"이라는 용어를 사용하면 독자는 해당 클래스나 객체가
위 유형 중 하나라고 가정합니다.
Ci::Build 클래스를 특정해 가리키는 경우에는 혼동을 일으킬 수 있으므로
객체나 클래스 이름을 "job"으로 붙이지 않습니다. 문서에서는
일반적으로 "Build" 대신 "Job"을 사용합니다.
코드베이스에는 리팩터링이 필요한 불일치가 몇 가지 있습니다.
예를 들어 CommitStatus는 Ci::Job이어야 하고 Ci::JobArtifact는 Ci::BuildArtifact여야 합니다.
전체 리팩터링 계획은 이 이슈를 참고합니다.
트리거 job#
트리거 job은 내부적으로 브리지 job이라고 하며 일반 job과 다릅니다. 트리거 job의 특징은 다음과 같습니다.
- 러너에서 실행되지 않으며
script를 실행하지 않습니다.
- GitLab이 다운스트림 파이프라인을 생성하고 오케스트레이션하도록 합니다.
pending 상태로 시작한 뒤 GitLab이 다운스트림 파이프라인을 생성했는지에 따라
passed 또는 failed로 전환됩니다(trigger:strategy를 사용하면
다운스트림 파이프라인의 상태에 따라 전환됩니다).
컴퓨팅 분과 할당량#
컴퓨팅 분 개발 문서를 참고합니다.