



InfoGrab DocsInfoGrab Docs

배치로 테이블 반복 처리하기

요약

Rails는 행을 배치 단위로 반복 처리하는 데 사용할 수 있는 in_batches 메서드를 제공합니다. 그러나 이 메서드는 쿼리와 메모리 사용 측면 모두에서 효율이 그다지 좋지 않은 방식으로 구현되어 있습니다. 이를 우회하려면 모델에 EachBatch 모듈을 포함한 다음 each_batch 클래스 메서드를 사용할 수 있습니다.

Rails는 행을 배치 단위로 반복 처리하는 데 사용할 수 있는 in_batches 메서드를 제공합니다. 예를 들면 다음과 같습니다:

User.in_batches(of: 10) do |relation|
  relation.update_all(updated_at: Time.now)
end

그러나 이 메서드는 쿼리와 메모리 사용 측면 모두에서 효율이 그다지 좋지 않은 방식으로 구현되어 있습니다.

이를 우회하려면 모델에 EachBatch 모듈을 포함한 다음 each_batch 클래스 메서드를 사용할 수 있습니다. 예를 들면 다음과 같습니다:

class User < ActiveRecord::Base
  include EachBatch
end

User.each_batch(of: 10) do |relation|
  relation.update_all(updated_at: Time.now)
end

이 메서드는 다음과 같은 쿼리를 생성합니다:

User Load (0.7ms)  SELECT  "users"."id" FROM "users" WHERE ("users"."id" >= 41654)  ORDER BY "users"."id" ASC LIMIT 1 OFFSET 1000
  (0.7ms)  SELECT COUNT(*) FROM "users" WHERE ("users"."id" >= 41654) AND ("users"."id" < 42687)

이 메서드의 API는 in_batches와 비슷하지만 in_batches가 지원하는 모든 인수를 지원하지는 않습니다. in_batches가 특별히 필요한 경우가 아니라면 항상 each_batch를 사용합니다.

고유하지 않은 칼럼에 대한 반복 처리#

(관계 컨텍스트에서) 고유하지 않은 칼럼에는 each_batch 메서드를 사용하지 않아야 합니다. 무한 루프에 빠질 수 있기 때문입니다. 또한 고유하지 않은 칼럼을 반복 처리하면 배치 크기가 일정하지 않아 성능 문제가 발생합니다. 속성을 반복 처리할 때 최대 배치 크기를 적용해도 결과 배치가 그 크기를 넘지 않는다고 보장할 수 없습니다. 다음 스니펫이 이 상황을 보여 줍니다. id가 1에서 10,000 사이인 사용자의 Ci::Build 항목을 선택하려 하면 데이터베이스가 1 215 178개의 일치하는 행을 반환합니다.

[ gstg ] production> Ci::Build.where(user_id: (1..10_000)).size
=> 1215178

이는 구성된 관계가 다음 쿼리로 변환되기 때문입니다:

[ gstg ] production> puts Ci::Build.where(user_id: (1..10_000)).to_sql
SELECT "ci_builds".* FROM "ci_builds" WHERE "ci_builds"."type" = 'Ci::Build' AND "ci_builds"."user_id" BETWEEN 1 AND 10000
=> nil

And 쿼리는 WHERE "ci_builds"."user_id" BETWEEN ? AND ?처럼 고유하지 않은 칼럼을 범위로 필터링하며, 범위 크기를 특정 임계값(앞의 예시에서는 10,000)으로 제한해도 이 임계값이 반환되는 데이터 세트의 크기로 이어지지는 않습니다. 속성의 가능한 값 n개를 취할 때, 그 값을 담고 있는 레코드의 수가 n보다 적다고 단정할 수 없기 때문입니다.

distinct_each_batch를 사용한 loose-index scan#

고유하지 않은 칼럼을 반복 처리해야 한다면 distinct_each_batch 헬퍼 메서드를 사용합니다. 이 헬퍼는 loose-index scan 기법 (skip-index scan)을 사용해 데이터베이스 인덱스 안의 중복 값을 건너뜁니다.

예시: Issue 모델에서 고유한 author_id를 반복 처리

Issue.distinct_each_batch(column: :author_id, of: 1000) do |relation|
  users = User.where(id: relation.select(:author_id)).to_a
end

이 기법은 데이터 분포와 무관하게 배치 간에 안정적인 성능을 제공합니다. relation 객체는 지정한 column만 사용할 수 있는 ActiveRecord 스코프를 반환합니다. 다른 칼럼은 로드되지 않습니다.

기반이 되는 데이터베이스 쿼리는 재귀 CTE를 사용하므로 오버헤드가 추가됩니다. 따라서 표준 each_batch 반복보다 작은 배치 크기를 사용할 것을 권장합니다.

칼럼 정의#

EachBatch는 기본적으로 모델의 기본 키를 반복에 사용합니다. 대부분의 경우 이렇게 해도 되지만, 경우에 따라 다른 칼럼을 반복에 사용하고 싶을 수 있습니다.

Project.distinct.each_batch(column: :creator_id, of: 10) do |relation|
  puts User.where(id: relation.select(:creator_id)).map(&:id)
end

위 쿼리는 프로젝트 작성자를 반복 처리하며 중복 없이 출력합니다.

Note

칼럼이 고유하지 않다면(고유 인덱스 정의가 없다면) 관계에서 distinct 메서드를 호출해야 합니다. 고유하지 않은 칼럼을 distinct 없이 사용하면 each_batch가 끝나지 않는 루프에 빠질 수 있으며, 이는 다음 이슈에 설명되어 있습니다.

데이터 마이그레이션에서 EachBatch 사용#

데이터 마이그레이션을 다룰 때 대량의 데이터를 반복 처리하는 데 선호되는 방법은 EachBatch를 사용하는 것입니다.

데이터 마이그레이션의 특수한 경우로 배치 백그라운드 마이그레이션이 있으며, 여기서는 실제 데이터 수정이 백그라운드 job에서 실행됩니다. 데이터 범위(슬라이스)를 결정하고 백그라운드 job을 예약하는 마이그레이션 코드에서 each_batch를 사용합니다.

each_batch의 효율적인 사용#

EachBatch는 대용량 테이블을 반복 처리하는 데 도움이 됩니다. EachBatch가 반복과 관련된 모든 성능 문제를 마법처럼 해결해 주지는 않으며, 일부 시나리오에서는 전혀 도움이 되지 않을 수도 있다는 점을 강조해 둡니다. 데이터베이스 관점에서는 EachBatch가 제대로 작동하도록 올바르게 구성된 데이터베이스 인덱스도 필요합니다.

예시 1: 단순 반복#

users 테이블을 반복 처리하면서 User 레코드를 표준 출력으로 출력하려 한다고 가정합니다. users 테이블에는 수백만 개의 레코드가 있으므로, 사용자를 가져오는 쿼리를 한 번에 실행하면 시간이 초과될 가능성이 높습니다.

다음 표는 여러 행을 담은 users 테이블의 단순화된 버전입니다. 예시를 좀 더 현실적으로 만들기 위해 id 칼럼에 작은 간격을 몇 군데 두었습니다(일부 레코드가 이미 삭제된 상황입니다). id 필드에는 인덱스 하나가 있습니다:

ID sign_in_count created_at
1 1 2020-01-01
2 4 2020-01-01
9 1 2020-01-03
300 5 2020-01-03
301 9 2020-01-03
302 8 2020-01-03
303 2 2020-01-03
350 1 2020-01-03
351 3 2020-01-04
352 0 2020-01-05
353 9 2020-01-11
354 3 2020-01-12

모든 사용자를 메모리에 로드하는 방식입니다(피해야 합니다):

users = User.all

users.each { |user| puts user.inspect }

each_batch를 사용합니다:

# Note: for this example I picked 5 as the batch size, the default is 1_000
User.each_batch(of: 5) do |relation|
  relation.each { |user| puts user.inspect }
end

each_batch 동작 방식#

첫 단계로 다음 데이터베이스 쿼리를 실행해 테이블에서 가장 작은 id(시작 id)를 찾습니다:

SELECT "users"."id" FROM "users" ORDER BY "users"."id" ASC LIMIT 1
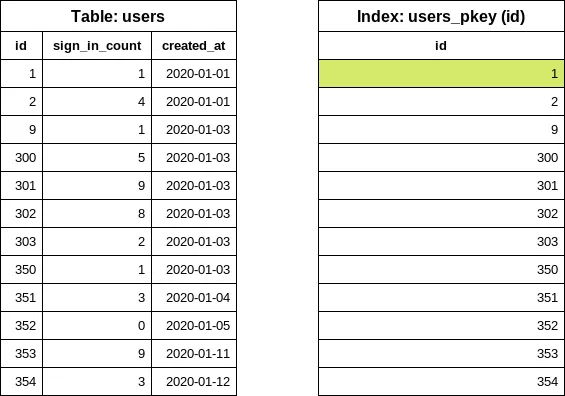
값이 1인 ID 칼럼이 강조된 users 테이블.

이 쿼리는 인덱스에서만 데이터를 읽고(INDEX ONLY SCAN) 테이블에는 접근하지 않습니다. 데이터베이스 인덱스는 정렬되어 있으므로 첫 항목을 꺼내는 작업은 비용이 매우 적습니다.

다음 단계는 배치 크기 설정을 따르는 다음 id(끝 id)를 찾는 것입니다. 이 예시에서는 배치 크기 5를 사용했습니다. EachBatch는 "이동한" id 값을 얻기 위해 OFFSET 절을 사용합니다.

SELECT "users"."id" FROM "users" WHERE "users"."id" >= 1 ORDER BY "users"."id" ASC LIMIT 1 OFFSET 5
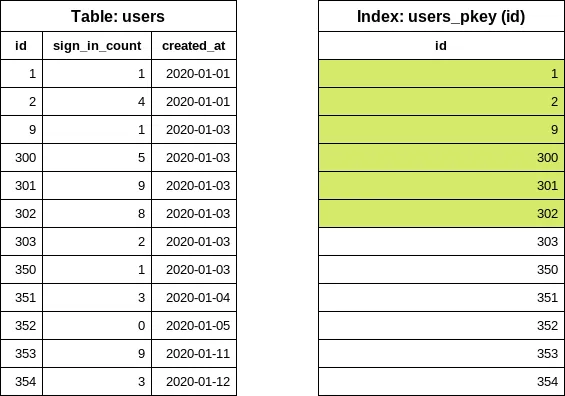
ID 칼럼에서 값 1, 2, 9, 300, 301, 302가 강조된 users 테이블.

이번에도 쿼리는 인덱스만 봅니다. OFFSET 5는 여섯 번째 id 값을 꺼냅니다. 이 쿼리는 테이블 크기나 반복 횟수와 무관하게 인덱스에서 최대 여섯 개의 항목을 읽습니다.

이 시점에서 첫 배치의 id 범위를 알게 됩니다. 이제 relation 블록에 사용할 쿼리를 구성할 차례입니다.

SELECT "users".* FROM "users" WHERE "users"."id" >= 1 AND "users"."id" < 302
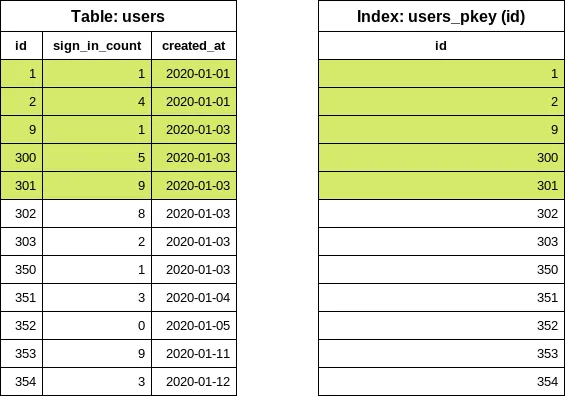
처음 네 행이 강조된 users 테이블과 처음 네 행이 강조된 ID 칼럼.

< 기호에 주목합니다. 앞에서 인덱스에서 여섯 개의 항목을 읽었고, 이 쿼리에서는 마지막 값이 "제외"됩니다. 쿼리는 인덱스를 보고 디스크에서 user 행 다섯 개의 위치를 파악한 뒤 테이블에서 그 행들을 읽습니다. 반환된 배열은 Ruby에서 처리됩니다.

첫 번째 반복이 끝났습니다. 다음 반복에서는 이전 반복의 마지막 id 값을 재사용해 다음 끝 id 값을 찾습니다.

SELECT "users"."id" FROM "users" WHERE "users"."id" >= 302 ORDER BY "users"."id" ASC LIMIT 1 OFFSET 5
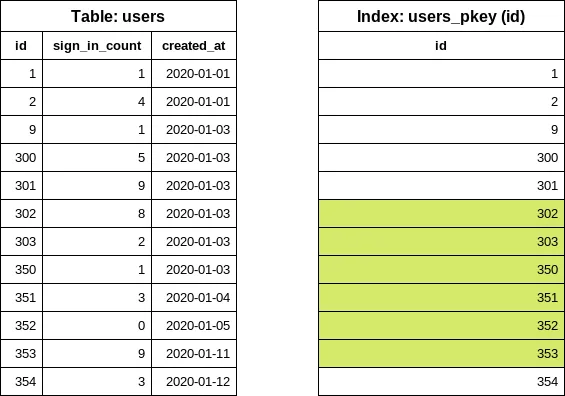
두 번째 끝 ID 값 읽기

이제 두 번째 반복에 사용할 users 쿼리를 손쉽게 구성할 수 있습니다.

SELECT "users".* FROM "users" WHERE "users"."id" >= 302 AND "users"."id" < 353
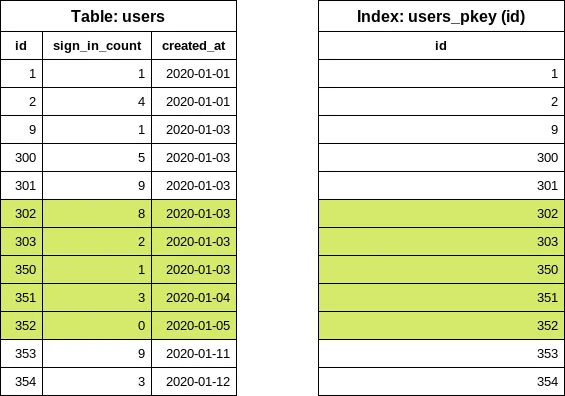
users 테이블에서 두 번째 반복에 해당하는 행 읽기

예시 2: 필터를 사용한 반복#

앞의 예시를 바탕으로, 로그인 횟수가 0인 사용자를 출력하려 합니다. 로그인 횟수는 sign_in_count 칼럼에 기록하고 있으므로 다음과 같은 코드를 작성합니다:

users = User.where(sign_in_count: 0)

users.each_batch(of: 5) do |relation|
  relation.each { |user| puts user.inspect }
end

each_batch는 시작 id 값을 구하기 위해 다음 SQL 쿼리를 생성합니다:

SELECT "users"."id" FROM "users" WHERE "users"."sign_in_count" = 0 ORDER BY "users"."id" ASC LIMIT 1

id 칼럼만 선택하고 id로 정렬하면 데이터베이스가 id 칼럼의 인덱스(기본 키 인덱스)를 사용하게 됩니다. 그런데 sign_in_count 칼럼에 대한 조건도 추가로 있습니다. 이 칼럼은 인덱스에 포함되어 있지 않으므로, 데이터베이스는 처음으로 일치하는 행을 찾기 위해 실제 테이블을 살펴봐야 합니다.
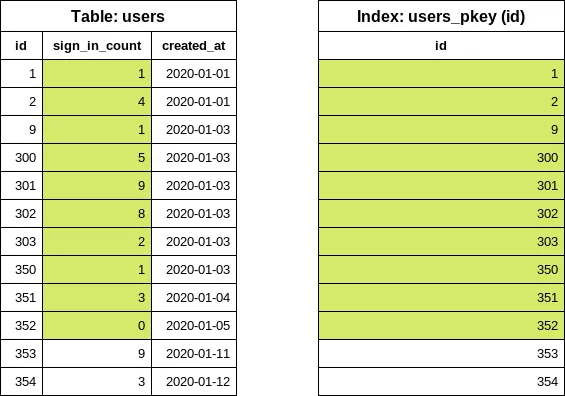
추가 필터가 있는 인덱스 읽기

Note

스캔되는 행의 수는 테이블의 데이터 분포에 따라 달라집니다.

  • 최선의 경우: 첫 번째 사용자가 한 번도 로그인하지 않았습니다. 데이터베이스는 한 행만 읽습니다.
  • 최악의 경우: 모든 사용자가 최소 한 번 로그인했습니다. 데이터베이스는 모든 행을 읽습니다.

이 예시에서 데이터베이스는 첫 id 값을 알아내기 위해 (배치 크기 설정과 무관하게) 10개의 행을 읽어야 했습니다. "실제" 애플리케이션에서는 필터링이 문제를 일으킬지 여부를 예측하기 어렵습니다. GitLab의 경우 프로덕션 복제본에서 데이터를 확인하는 것이 좋은 출발점이지만, GitLab.com의 데이터 분포가 GitLab Self-Managed 인스턴스와 다를 수 있다는 점을 염두에 둡니다.

each_batch를 사용한 필터링 개선#

특수 조건 인덱스#
CREATE INDEX index_on_users_never_logged_in ON users (id) WHERE sign_in_count = 0

테이블과 새로 만든 인덱스는 다음과 같습니다:
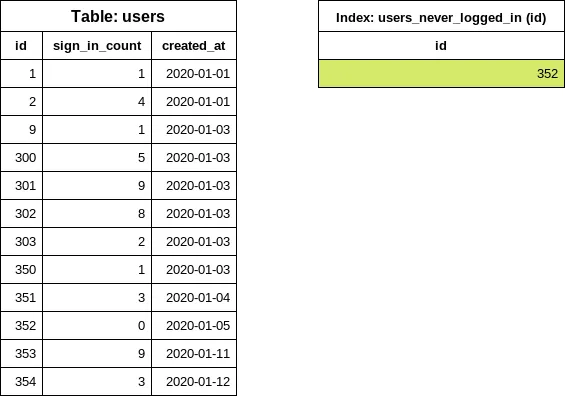
특수 인덱스 읽기

이 인덱스 정의는 id 및 sign_in_count 칼럼의 조건을 모두 포함하므로 each_batch 쿼리가 매우 효과적으로 동작합니다(단순 반복 예시와 비슷합니다).

한 번도 로그인하지 않은 사용자는 드물기 때문에 인덱스 크기가 작을 것으로 예상합니다. 인덱스 정의에 id만 포함하는 것도 인덱스 크기를 작게 유지하는 데 도움이 됩니다.

칼럼에 대한 인덱스#

이후에 sign_in_count 값을 다르게 필터링하면서 테이블을 반복 처리하고 싶을 수 있습니다. 그런 경우에는 새 필터(sign_in_count > 10)와 WHERE 조건이 일치하지 않으므로 앞에서 제안한 조건 인덱스를 사용할 수 없습니다.

이 문제를 해결하는 방법은 두 가지입니다:

  • 새 쿼리를 포함하는 다른 조건 인덱스를 만듭니다.
  • 인덱스를 더 일반화된 구성으로 교체합니다.
Note

같은 테이블의 같은 칼럼에 인덱스가 여러 개 있으면 데이터를 쓸 때 성능 병목이 될 수 있습니다.

다음 인덱스를 살펴봅니다(피해야 합니다):

CREATE INDEX index_on_users_never_logged_in ON users (id, sign_in_count)

이 인덱스 정의는 id 칼럼으로 시작하므로 데이터 선택도 관점에서 인덱스가 매우 비효율적입니다.

SELECT "users"."id" FROM "users" WHERE "users"."sign_in_count" = 0 ORDER BY "users"."id" ASC LIMIT 1

위 쿼리를 실행하면 INDEX ONLY SCAN이 됩니다. 그러나 쿼리는 여전히 인덱스에서 개수를 알 수 없는 항목들을 반복해서 살펴본 다음 sign_in_count가 0인 첫 항목을 찾아야 합니다.
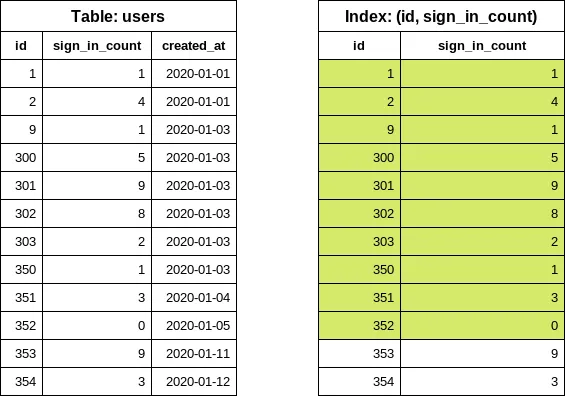
비효율적인 인덱스 읽기

인덱스 정의에서 칼럼 순서를 바꾸면 쿼리를 크게 개선할 수 있습니다(권장).

CREATE INDEX index_on_users_never_logged_in ON users (sign_in_count, id)
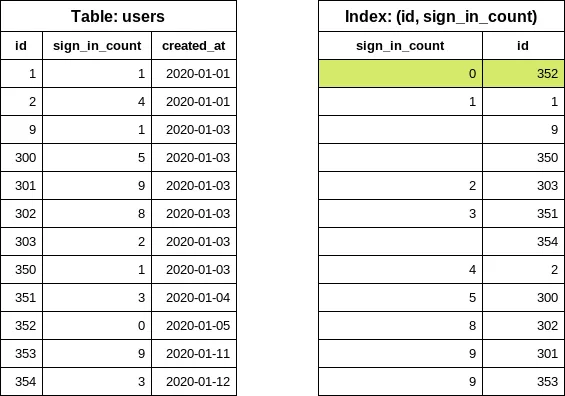
좋은 인덱스 읽기

다음 인덱스 정의는 each_batch와 잘 맞지 않습니다(피해야 합니다).

CREATE INDEX index_on_users_never_logged_in ON users (sign_in_count)

each_batch는 id 칼럼을 기준으로 범위 쿼리를 구성하므로 이 인덱스는 효율적으로 사용할 수 없습니다. 데이터베이스는 테이블에서 행을 읽거나, 기본 키 인덱스도 함께 읽는 비트맵 검색을 사용합니다.

"느린" 반복#

느린 반복은 좋은 인덱스 구성을 사용해 테이블을 반복 처리하고, 생성된 관계에 필터링을 적용하는 방식을 뜻합니다.

User.each_batch(of: 5) do |relation|
  relation.where(sign_in_count: 0).each { |user| puts user inspect }
end

이 반복은 (id 칼럼의) 기본 키 인덱스를 사용하므로 구문 시간 초과로부터 안전합니다. 필터(sign_in_count: 0)는 id가 이미 (범위로) 제한된 relation에 적용됩니다. 행의 수가 제한됩니다.

느린 반복은 일반적으로 끝날 때까지 더 오래 걸립니다. 반복 횟수가 더 많고, 한 번의 반복이 배치 크기보다 적은 레코드를 생성할 수 있습니다. 반복이 레코드를 0개 생성할 수도 있습니다. 최적의 해결책은 아닙니다. 그러나 일부 경우(특히 대용량 테이블을 다룰 때)에는 이것이 유일하게 실행 가능한 선택입니다.

서브쿼리 사용#

each_batch 쿼리에 서브쿼리를 사용하는 방식은 대부분의 경우 잘 동작하지 않습니다. 다음 예시를 살펴봅니다:

projects = Project.where(creator_id: Issue.where(confidential: true).select(:author_id))

projects.each_batch do |relation|
  # do something
end

이 반복은 projects 테이블의 id 칼럼을 사용합니다. 배칭은 서브쿼리에 영향을 주지 않습니다. 즉, 반복마다 데이터베이스가 서브쿼리를 실행합니다. 이는 쿼리에 일정한 "부하"를 더하며 결국 구문 시간 초과로 이어지는 경우가 많습니다. 우리는 비공개 이슈의 수를 알 수 없고, 실행 시간과 접근하는 데이터베이스 행은 issues 테이블의 데이터 분포에 따라 달라집니다.

Note

서브쿼리 사용은 서브쿼리가 적은 수의 행을 반환할 때만 효과가 있습니다.

서브쿼리 개선#

서브쿼리를 다룰 때는 느린 반복 방식이 통할 수 있습니다. creator_id에 대한 필터를 생성된 relation 객체의 일부로 둘 수 있습니다.

projects = Project.all

projects.each_batch do |relation|
  relation.where(creator_id: Issue.where(confidential: true).select(:author_id))
end

issues 테이블 자체에 대한 쿼리의 성능이 충분하지 않다면 중첩 루프를 구성할 수도 있습니다. 가능하면 피합니다.

projects = Project.all

projects.each_batch do |relation|
  issues = Issue.where(confidential: true)

  issues.each_batch do |issues_relation|
    relation.where(creator_id: issues_relation.select(:author_id))
  end
end

issues 테이블의 행이 projects보다 훨씬 많다는 것을 안다면, issues 테이블을 먼저 배칭하도록 쿼리를 뒤집는 것이 합리적입니다.

JOIN과 EXISTS 사용#

JOINS를 사용하는 경우는 다음과 같습니다:

  • 테이블 사이에 1:1 또는 1:N 관계가 있고, 조인되는 레코드가 (거의) 항상 존재한다는 것을 아는 경우입니다. 이는 "확장형" 테이블에 잘 맞습니다:
    • projects - project_settings
    • users - user_details
    • users - user_statuses
  • 이 경우 LEFT JOIN이 잘 동작합니다. 조인되는 테이블의 조건은 생성된 관계에 두어야 하며, 그래야 조인되는 테이블의 데이터 분포가 반복에 영향을 주지 않습니다.

예시:

User.each_batch do |relation|
  relation
    .joins("LEFT JOIN personal_access_tokens on personal_access_tokens.user_id = users.id")
    .where("personal_access_tokens.name = 'name'")
end

EXISTS 쿼리는 each_batch 쿼리의 내부 relation에만 추가해야 합니다:

User.each_batch do |relation|
  relation.where("EXISTS (SELECT 1 FROM ...")
end

relation 객체에 대한 복잡한 쿼리#

relation 객체에 추가 조건이 여러 개 있으면 실행 계획이 "불안정"해질 수 있습니다.

예시:

Issue.each_batch do |relation|
  relation
    .joins(:metrics)
    .joins(:merge_requests_closing_issues)
    .where("id IN (SELECT ...)")
    .where(confidential: true)
end

여기서는 relation 쿼리가 BATCH_SIZE만큼의 사용자 레코드를 읽은 다음 제공된 쿼리에 따라 결과를 좁혀 주기를 기대합니다. 그런데 플래너는 confidential 칼럼의 인덱스를 사용한 비트맵 인덱스 조회가 쿼리를 실행하는 더 나은 방법이라고 판단할 수 있습니다. 이렇게 되면 예상보다 훨씬 많은 행을 읽게 되고 쿼리가 시간 초과될 수 있습니다.

문제는 이렇습니다. 관계가 최대 BATCH_SIZE개의 레코드를 반환한다는 것을 우리는 확실히 압니다. 그러나 플래너는 이를 알지 못합니다.

범위 쿼리를 먼저 실행하도록 강제하는 공통 테이블 식(CTE) 기법입니다:

Issue.each_batch(of: 1000) do |relation|
  cte = Gitlab::SQL::CTE.new(:batched_relation, relation.limit(1000))

  scope = cte
    .apply_to(Issue.all)
    .joins(:metrics)
    .joins(:merge_requests_closing_issues)
    .where("id IN (SELECT ...)")
    .where(confidential: true)

  puts scope.to_a
end

레코드 카운팅#

데이터가 많은 테이블에서는 쿼리로 레코드를 카운팅하면 시간 초과가 발생할 수 있습니다. EachBatch 모듈은 레코드를 반복적으로 카운팅하는 대안을 제공합니다. each_batch를 사용하는 단점은 생성된 관계 객체에서 실행되는 추가 카운트 쿼리입니다.

each_batch_count 메서드는 추가 카운트 쿼리가 필요하지 않은 더 효율적인 접근 방식입니다. 이 메서드를 호출하면 반복 프로세스를 필요에 따라 일시 중지하고 재개할 수 있습니다. 이 기능은 Sidekiq 워커에서 카운팅 연산을 수행할 때처럼 5분이 지나면 오류 예산 위반이 발생하는 상황에서 특히 유용합니다.

예를 들어 EachBatch로 레코드를 카운팅하면 다음과 같이 추가 카운트 쿼리를 호출하게 됩니다:

count = 0

Issue.each_batch do |relation|
  count += relation.count
end

puts count

반면 each_batch_count 메서드를 사용하면 추가 카운트 쿼리를 호출하지 않고 카운팅을 더 효율적으로 수행할 수 있습니다(카운팅이 반복 쿼리의 일부입니다):

count, _last_value = Issue.each_batch_count # last value can be ignored here

또한 each_batch_count 메서드는 카운팅 과정을 어느 시점에서든 일시 중지하고 재개할 수 있게 합니다. 다음 코드 스니펫이 이 기능을 보여 줍니다:

stop_at = Time.current + 3.minutes

count, last_value = Issue.each_batch_count do
  stop_at.past? # condition for stopping the counting
end

# Continue the counting later
stop_at = Time.current + 3.minutes

count, last_value = Issue.each_batch_count(last_count: count, last_value: last_value) do
  stop_at.past?
end

EachBatch와 BatchCount 비교#

Service Ping용 카운터를 새로 추가할 때 레코드를 카운팅하는 선호 방법은 Gitlab::Database::BatchCount 클래스를 사용하는 것입니다. BatchCount에 구현된 반복 로직은 EachBatch와 비슷한 성능 특성을 가집니다. 앞에서 언급한 BatchCount 개선을 위한 팁과 제안 대부분은 BatchCount에도 적용됩니다.

키셋 페이지네이션으로 반복#

EachBatch로 반복하는 것이 동작하지 않는 특수한 경우가 몇 가지 있습니다. EachBatch는 고유한 칼럼 하나(보통 기본 키)를 요구하므로, 타임스탬프 칼럼과 복합 기본 키가 있는 테이블에서는 반복이 불가능합니다.

EachBatch가 동작하지 않는 경우에는 키셋 페이지네이션을 사용해 테이블이나 행 범위를 반복할 수 있습니다. 확장성과 성능 특성은 EachBatch와 매우 비슷합니다.

예시:

  • 정렬에 사용하는 칼럼에 고유한 값이 없는 경우, 타이-브레이커와 함께 특정 순서(타임스탬프 칼럼)로 테이블을 반복합니다.
  • 복합 기본 키가 있는 테이블을 반복합니다.

프로젝트의 이슈를 생성 날짜별로 반복#

키셋 페이지네이션을 사용하면 특정 순서(예를 들어 created_at DESC)로 임의의 데이터베이스 칼럼을 반복할 수 있습니다. created_at 값이 같은 레코드의 순서를 일관되게 유지하려면 고유한 값을 가진 타이-브레이커 칼럼(예를 들어 id)을 사용합니다.

issues 테이블에 다음 인덱스가 있다고 가정합니다:

idx_issues_on_project_id_and_created_at_and_id" btree (project_id, created_at, id)

추가 처리를 위한 레코드 가져오기#

다음 스니펫은 지정한 순서(created_at, id)로 프로젝트 안의 이슈 레코드를 반복 처리합니다.

scope = Issue.where(project_id: 278964).order(:created_at, :id) # id is the tie-breaker

iterator = Gitlab::Pagination::Keyset::Iterator.new(scope: scope)

iterator.each_batch(of: 100) do |records|
  puts records.map(&:id)
end

쿼리에 필터를 추가할 수 있습니다. 다음 예시는 최근 30일 동안 생성된 이슈 ID만 나열합니다:

scope = Issue.where(project_id: 278964).where('created_at > ?', 30.days.ago).order(:created_at, :id) # id is the tie-breaker

iterator = Gitlab::Pagination::Keyset::Iterator.new(scope: scope)

iterator.each_batch(of: 100) do |records|
  puts records.map(&:id)
end

배치에서 레코드 업데이트#

복잡한 ActiveRecord 쿼리에서는 .update_all 메서드가 잘 동작하지 않습니다. 잘못된 UPDATE 문을 생성하기 때문입니다. 배치로 레코드를 업데이트할 때는 원시 SQL을 사용할 수 있습니다:

scope = Issue.where(project_id: 278964).order(:created_at, :id) # id is the tie-breaker

iterator = Gitlab::Pagination::Keyset::Iterator.new(scope: scope)

iterator.each_batch(of: 100) do |records|
  ApplicationRecord.connection.execute("UPDATE issues SET updated_at=NOW() WHERE issues.id in (#{records.dup.reselect(:id).to_sql})")
end
Note

반복을 안정적이고 예측 가능하게 유지하려면 ORDER BY 절의 칼럼을 업데이트하지 않습니다.

merge_request_diff_commits 테이블 반복#

merge_request_diff_commits 테이블은 복합 기본 키(merge_request_diff_id, relative_order)를 사용하므로 EachBatch를 효율적으로 사용할 수 없습니다.

merge_request_diff_commits 테이블을 페이지네이션하려면 다음 스니펫을 사용할 수 있습니다:

# Custom order object configuration:
order = Gitlab::Pagination::Keyset::Order.build([
  Gitlab::Pagination::Keyset::ColumnOrderDefinition.new(
    attribute_name: 'merge_request_diff_id',
    order_expression: MergeRequestDiffCommit.arel_table[:merge_request_diff_id].asc,
    nullable: :not_nullable
  ),
  Gitlab::Pagination::Keyset::ColumnOrderDefinition.new(
    attribute_name: 'relative_order',
    order_expression: MergeRequestDiffCommit.arel_table[:relative_order].asc,
    nullable: :not_nullable
  )
])
MergeRequestDiffCommit.include(FromUnion) # keyset pagination generates UNION queries

scope = MergeRequestDiffCommit.order(order)

iterator = Gitlab::Pagination::Keyset::Iterator.new(scope: scope)

iterator.each_batch(of: 100) do |records|
  puts records.map { |record| [record.merge_request_diff_id, record.relative_order] }.inspect
end

Order 객체 구성#

키셋 페이지네이션은 단순한 ActiveRecord order 스코프와 잘 동작합니다 (첫 번째 예시). 그러나 특수한 경우에는 기반 키셋 페이지네이션 라이브러리를 위해 ORDER BY 절의 칼럼을 직접 기술해야 합니다(두 번째 예시). 키셋 페이지네이션 라이브러리가 ORDER BY 구성을 자동으로 판별할 수 없으면 오류가 발생합니다.

ORDER BY 절을 구성할 때 사용할 수 있는 옵션의 개요는 Gitlab::Pagination::Keyset::Order 및 Gitlab::Pagination::Keyset::ColumnOrderDefinition 클래스의 코드 주석에서 확인할 수 있습니다. 몇 가지 코드 예시는 키셋 페이지네이션 문서에서도 찾을 수 있습니다.

배치로 테이블 반복 처리하기

GitLab v19.4
원문 보기

요약

Rails는 행을 배치 단위로 반복 처리하는 데 사용할 수 있는 in_batches 메서드를 제공합니다. 그러나 이 메서드는 쿼리와 메모리 사용 측면 모두에서 효율이 그다지 좋지 않은 방식으로 구현되어 있습니다. 이를 우회하려면 모델에 EachBatch 모듈을 포함한 다음 each_batch 클래스 메서드를 사용할 수 있습니다.

Rails는 행을 배치 단위로 반복 처리하는 데 사용할 수 있는 in_batches 메서드를 제공합니다. 예를 들면 다음과 같습니다:

User.in_batches(of: 10) do |relation|
  relation.update_all(updated_at: Time.now)
end

그러나 이 메서드는 쿼리와 메모리 사용 측면 모두에서 효율이 그다지 좋지 않은 방식으로 구현되어 있습니다.

이를 우회하려면 모델에 EachBatch 모듈을 포함한 다음 each_batch 클래스 메서드를 사용할 수 있습니다. 예를 들면 다음과 같습니다:

class User < ActiveRecord::Base
  include EachBatch
end

User.each_batch(of: 10) do |relation|
  relation.update_all(updated_at: Time.now)
end

이 메서드는 다음과 같은 쿼리를 생성합니다:

User Load (0.7ms)  SELECT  "users"."id" FROM "users" WHERE ("users"."id" >= 41654)  ORDER BY "users"."id" ASC LIMIT 1 OFFSET 1000
  (0.7ms)  SELECT COUNT(*) FROM "users" WHERE ("users"."id" >= 41654) AND ("users"."id" < 42687)

이 메서드의 API는 in_batches와 비슷하지만 in_batches가 지원하는 모든 인수를 지원하지는 않습니다. in_batches가 특별히 필요한 경우가 아니라면 항상 each_batch를 사용합니다.

고유하지 않은 칼럼에 대한 반복 처리#

(관계 컨텍스트에서) 고유하지 않은 칼럼에는 each_batch 메서드를 사용하지 않아야 합니다. 무한 루프에 빠질 수 있기 때문입니다. 또한 고유하지 않은 칼럼을 반복 처리하면 배치 크기가 일정하지 않아 성능 문제가 발생합니다. 속성을 반복 처리할 때 최대 배치 크기를 적용해도 결과 배치가 그 크기를 넘지 않는다고 보장할 수 없습니다. 다음 스니펫이 이 상황을 보여 줍니다. id가 1에서 10,000 사이인 사용자의 Ci::Build 항목을 선택하려 하면 데이터베이스가 1 215 178개의 일치하는 행을 반환합니다.

[ gstg ] production> Ci::Build.where(user_id: (1..10_000)).size
=> 1215178

이는 구성된 관계가 다음 쿼리로 변환되기 때문입니다:

[ gstg ] production> puts Ci::Build.where(user_id: (1..10_000)).to_sql
SELECT "ci_builds".* FROM "ci_builds" WHERE "ci_builds"."type" = 'Ci::Build' AND "ci_builds"."user_id" BETWEEN 1 AND 10000
=> nil

And 쿼리는 WHERE "ci_builds"."user_id" BETWEEN ? AND ?처럼 고유하지 않은 칼럼을 범위로 필터링하며, 범위 크기를 특정 임계값(앞의 예시에서는 10,000)으로 제한해도 이 임계값이 반환되는 데이터 세트의 크기로 이어지지는 않습니다. 속성의 가능한 값 n개를 취할 때, 그 값을 담고 있는 레코드의 수가 n보다 적다고 단정할 수 없기 때문입니다.

distinct_each_batch를 사용한 loose-index scan#

고유하지 않은 칼럼을 반복 처리해야 한다면 distinct_each_batch 헬퍼 메서드를 사용합니다. 이 헬퍼는 loose-index scan 기법 (skip-index scan)을 사용해 데이터베이스 인덱스 안의 중복 값을 건너뜁니다.

예시: Issue 모델에서 고유한 author_id를 반복 처리

Issue.distinct_each_batch(column: :author_id, of: 1000) do |relation|
  users = User.where(id: relation.select(:author_id)).to_a
end

이 기법은 데이터 분포와 무관하게 배치 간에 안정적인 성능을 제공합니다. relation 객체는 지정한 column만 사용할 수 있는 ActiveRecord 스코프를 반환합니다. 다른 칼럼은 로드되지 않습니다.

기반이 되는 데이터베이스 쿼리는 재귀 CTE를 사용하므로 오버헤드가 추가됩니다. 따라서 표준 each_batch 반복보다 작은 배치 크기를 사용할 것을 권장합니다.

칼럼 정의#

EachBatch는 기본적으로 모델의 기본 키를 반복에 사용합니다. 대부분의 경우 이렇게 해도 되지만, 경우에 따라 다른 칼럼을 반복에 사용하고 싶을 수 있습니다.

Project.distinct.each_batch(column: :creator_id, of: 10) do |relation|
  puts User.where(id: relation.select(:creator_id)).map(&:id)
end

위 쿼리는 프로젝트 작성자를 반복 처리하며 중복 없이 출력합니다.

Note

칼럼이 고유하지 않다면(고유 인덱스 정의가 없다면) 관계에서 distinct 메서드를 호출해야 합니다. 고유하지 않은 칼럼을 distinct 없이 사용하면 each_batch가 끝나지 않는 루프에 빠질 수 있으며, 이는 다음 이슈에 설명되어 있습니다.

데이터 마이그레이션에서 EachBatch 사용#

데이터 마이그레이션을 다룰 때 대량의 데이터를 반복 처리하는 데 선호되는 방법은 EachBatch를 사용하는 것입니다.

데이터 마이그레이션의 특수한 경우로 배치 백그라운드 마이그레이션이 있으며, 여기서는 실제 데이터 수정이 백그라운드 job에서 실행됩니다. 데이터 범위(슬라이스)를 결정하고 백그라운드 job을 예약하는 마이그레이션 코드에서 each_batch를 사용합니다.

each_batch의 효율적인 사용#

EachBatch는 대용량 테이블을 반복 처리하는 데 도움이 됩니다. EachBatch가 반복과 관련된 모든 성능 문제를 마법처럼 해결해 주지는 않으며, 일부 시나리오에서는 전혀 도움이 되지 않을 수도 있다는 점을 강조해 둡니다. 데이터베이스 관점에서는 EachBatch가 제대로 작동하도록 올바르게 구성된 데이터베이스 인덱스도 필요합니다.

예시 1: 단순 반복#

users 테이블을 반복 처리하면서 User 레코드를 표준 출력으로 출력하려 한다고 가정합니다. users 테이블에는 수백만 개의 레코드가 있으므로, 사용자를 가져오는 쿼리를 한 번에 실행하면 시간이 초과될 가능성이 높습니다.

다음 표는 여러 행을 담은 users 테이블의 단순화된 버전입니다. 예시를 좀 더 현실적으로 만들기 위해 id 칼럼에 작은 간격을 몇 군데 두었습니다(일부 레코드가 이미 삭제된 상황입니다). id 필드에는 인덱스 하나가 있습니다:

ID sign_in_count created_at
1 1 2020-01-01
2 4 2020-01-01
9 1 2020-01-03
300 5 2020-01-03
301 9 2020-01-03
302 8 2020-01-03
303 2 2020-01-03
350 1 2020-01-03
351 3 2020-01-04
352 0 2020-01-05
353 9 2020-01-11
354 3 2020-01-12

모든 사용자를 메모리에 로드하는 방식입니다(피해야 합니다):

users = User.all

users.each { |user| puts user.inspect }

each_batch를 사용합니다:

# Note: for this example I picked 5 as the batch size, the default is 1_000
User.each_batch(of: 5) do |relation|
  relation.each { |user| puts user.inspect }
end

each_batch 동작 방식#

첫 단계로 다음 데이터베이스 쿼리를 실행해 테이블에서 가장 작은 id(시작 id)를 찾습니다:

SELECT "users"."id" FROM "users" ORDER BY "users"."id" ASC LIMIT 1

값이 1인 ID 칼럼이 강조된 users 테이블.

이 쿼리는 인덱스에서만 데이터를 읽고(INDEX ONLY SCAN) 테이블에는 접근하지 않습니다. 데이터베이스 인덱스는 정렬되어 있으므로 첫 항목을 꺼내는 작업은 비용이 매우 적습니다.

다음 단계는 배치 크기 설정을 따르는 다음 id(끝 id)를 찾는 것입니다. 이 예시에서는 배치 크기 5를 사용했습니다. EachBatch는 "이동한" id 값을 얻기 위해 OFFSET 절을 사용합니다.

SELECT "users"."id" FROM "users" WHERE "users"."id" >= 1 ORDER BY "users"."id" ASC LIMIT 1 OFFSET 5

ID 칼럼에서 값 1, 2, 9, 300, 301, 302가 강조된 users 테이블.

이번에도 쿼리는 인덱스만 봅니다. OFFSET 5는 여섯 번째 id 값을 꺼냅니다. 이 쿼리는 테이블 크기나 반복 횟수와 무관하게 인덱스에서 최대 여섯 개의 항목을 읽습니다.

이 시점에서 첫 배치의 id 범위를 알게 됩니다. 이제 relation 블록에 사용할 쿼리를 구성할 차례입니다.

SELECT "users".* FROM "users" WHERE "users"."id" >= 1 AND "users"."id" < 302

처음 네 행이 강조된 users 테이블과 처음 네 행이 강조된 ID 칼럼.

< 기호에 주목합니다. 앞에서 인덱스에서 여섯 개의 항목을 읽었고, 이 쿼리에서는 마지막 값이 "제외"됩니다. 쿼리는 인덱스를 보고 디스크에서 user 행 다섯 개의 위치를 파악한 뒤 테이블에서 그 행들을 읽습니다. 반환된 배열은 Ruby에서 처리됩니다.

첫 번째 반복이 끝났습니다. 다음 반복에서는 이전 반복의 마지막 id 값을 재사용해 다음 끝 id 값을 찾습니다.

SELECT "users"."id" FROM "users" WHERE "users"."id" >= 302 ORDER BY "users"."id" ASC LIMIT 1 OFFSET 5

두 번째 끝 ID 값 읽기

이제 두 번째 반복에 사용할 users 쿼리를 손쉽게 구성할 수 있습니다.

SELECT "users".* FROM "users" WHERE "users"."id" >= 302 AND "users"."id" < 353

users 테이블에서 두 번째 반복에 해당하는 행 읽기

예시 2: 필터를 사용한 반복#

앞의 예시를 바탕으로, 로그인 횟수가 0인 사용자를 출력하려 합니다. 로그인 횟수는 sign_in_count 칼럼에 기록하고 있으므로 다음과 같은 코드를 작성합니다:

users = User.where(sign_in_count: 0)

users.each_batch(of: 5) do |relation|
  relation.each { |user| puts user.inspect }
end

each_batch는 시작 id 값을 구하기 위해 다음 SQL 쿼리를 생성합니다:

SELECT "users"."id" FROM "users" WHERE "users"."sign_in_count" = 0 ORDER BY "users"."id" ASC LIMIT 1

id 칼럼만 선택하고 id로 정렬하면 데이터베이스가 id 칼럼의 인덱스(기본 키 인덱스)를 사용하게 됩니다. 그런데 sign_in_count 칼럼에 대한 조건도 추가로 있습니다. 이 칼럼은 인덱스에 포함되어 있지 않으므로, 데이터베이스는 처음으로 일치하는 행을 찾기 위해 실제 테이블을 살펴봐야 합니다.

추가 필터가 있는 인덱스 읽기

Note

스캔되는 행의 수는 테이블의 데이터 분포에 따라 달라집니다.

  • 최선의 경우: 첫 번째 사용자가 한 번도 로그인하지 않았습니다. 데이터베이스는 한 행만 읽습니다.
  • 최악의 경우: 모든 사용자가 최소 한 번 로그인했습니다. 데이터베이스는 모든 행을 읽습니다.

이 예시에서 데이터베이스는 첫 id 값을 알아내기 위해 (배치 크기 설정과 무관하게) 10개의 행을 읽어야 했습니다. "실제" 애플리케이션에서는 필터링이 문제를 일으킬지 여부를 예측하기 어렵습니다. GitLab의 경우 프로덕션 복제본에서 데이터를 확인하는 것이 좋은 출발점이지만, GitLab.com의 데이터 분포가 GitLab Self-Managed 인스턴스와 다를 수 있다는 점을 염두에 둡니다.

each_batch를 사용한 필터링 개선#

특수 조건 인덱스#
CREATE INDEX index_on_users_never_logged_in ON users (id) WHERE sign_in_count = 0

테이블과 새로 만든 인덱스는 다음과 같습니다:

특수 인덱스 읽기

이 인덱스 정의는 id 및 sign_in_count 칼럼의 조건을 모두 포함하므로 each_batch 쿼리가 매우 효과적으로 동작합니다(단순 반복 예시와 비슷합니다).

한 번도 로그인하지 않은 사용자는 드물기 때문에 인덱스 크기가 작을 것으로 예상합니다. 인덱스 정의에 id만 포함하는 것도 인덱스 크기를 작게 유지하는 데 도움이 됩니다.

칼럼에 대한 인덱스#

이후에 sign_in_count 값을 다르게 필터링하면서 테이블을 반복 처리하고 싶을 수 있습니다. 그런 경우에는 새 필터(sign_in_count > 10)와 WHERE 조건이 일치하지 않으므로 앞에서 제안한 조건 인덱스를 사용할 수 없습니다.

이 문제를 해결하는 방법은 두 가지입니다:

  • 새 쿼리를 포함하는 다른 조건 인덱스를 만듭니다.
  • 인덱스를 더 일반화된 구성으로 교체합니다.
Note

같은 테이블의 같은 칼럼에 인덱스가 여러 개 있으면 데이터를 쓸 때 성능 병목이 될 수 있습니다.

다음 인덱스를 살펴봅니다(피해야 합니다):

CREATE INDEX index_on_users_never_logged_in ON users (id, sign_in_count)

이 인덱스 정의는 id 칼럼으로 시작하므로 데이터 선택도 관점에서 인덱스가 매우 비효율적입니다.

SELECT "users"."id" FROM "users" WHERE "users"."sign_in_count" = 0 ORDER BY "users"."id" ASC LIMIT 1

위 쿼리를 실행하면 INDEX ONLY SCAN이 됩니다. 그러나 쿼리는 여전히 인덱스에서 개수를 알 수 없는 항목들을 반복해서 살펴본 다음 sign_in_count가 0인 첫 항목을 찾아야 합니다.

비효율적인 인덱스 읽기

인덱스 정의에서 칼럼 순서를 바꾸면 쿼리를 크게 개선할 수 있습니다(권장).

CREATE INDEX index_on_users_never_logged_in ON users (sign_in_count, id)

좋은 인덱스 읽기

다음 인덱스 정의는 each_batch와 잘 맞지 않습니다(피해야 합니다).

CREATE INDEX index_on_users_never_logged_in ON users (sign_in_count)

each_batch는 id 칼럼을 기준으로 범위 쿼리를 구성하므로 이 인덱스는 효율적으로 사용할 수 없습니다. 데이터베이스는 테이블에서 행을 읽거나, 기본 키 인덱스도 함께 읽는 비트맵 검색을 사용합니다.

"느린" 반복#

느린 반복은 좋은 인덱스 구성을 사용해 테이블을 반복 처리하고, 생성된 관계에 필터링을 적용하는 방식을 뜻합니다.

User.each_batch(of: 5) do |relation|
  relation.where(sign_in_count: 0).each { |user| puts user inspect }
end

이 반복은 (id 칼럼의) 기본 키 인덱스를 사용하므로 구문 시간 초과로부터 안전합니다. 필터(sign_in_count: 0)는 id가 이미 (범위로) 제한된 relation에 적용됩니다. 행의 수가 제한됩니다.

느린 반복은 일반적으로 끝날 때까지 더 오래 걸립니다. 반복 횟수가 더 많고, 한 번의 반복이 배치 크기보다 적은 레코드를 생성할 수 있습니다. 반복이 레코드를 0개 생성할 수도 있습니다. 최적의 해결책은 아닙니다. 그러나 일부 경우(특히 대용량 테이블을 다룰 때)에는 이것이 유일하게 실행 가능한 선택입니다.

서브쿼리 사용#

each_batch 쿼리에 서브쿼리를 사용하는 방식은 대부분의 경우 잘 동작하지 않습니다. 다음 예시를 살펴봅니다:

projects = Project.where(creator_id: Issue.where(confidential: true).select(:author_id))

projects.each_batch do |relation|
  # do something
end

이 반복은 projects 테이블의 id 칼럼을 사용합니다. 배칭은 서브쿼리에 영향을 주지 않습니다. 즉, 반복마다 데이터베이스가 서브쿼리를 실행합니다. 이는 쿼리에 일정한 "부하"를 더하며 결국 구문 시간 초과로 이어지는 경우가 많습니다. 우리는 비공개 이슈의 수를 알 수 없고, 실행 시간과 접근하는 데이터베이스 행은 issues 테이블의 데이터 분포에 따라 달라집니다.

Note

서브쿼리 사용은 서브쿼리가 적은 수의 행을 반환할 때만 효과가 있습니다.

서브쿼리 개선#

서브쿼리를 다룰 때는 느린 반복 방식이 통할 수 있습니다. creator_id에 대한 필터를 생성된 relation 객체의 일부로 둘 수 있습니다.

projects = Project.all

projects.each_batch do |relation|
  relation.where(creator_id: Issue.where(confidential: true).select(:author_id))
end

issues 테이블 자체에 대한 쿼리의 성능이 충분하지 않다면 중첩 루프를 구성할 수도 있습니다. 가능하면 피합니다.

projects = Project.all

projects.each_batch do |relation|
  issues = Issue.where(confidential: true)

  issues.each_batch do |issues_relation|
    relation.where(creator_id: issues_relation.select(:author_id))
  end
end

issues 테이블의 행이 projects보다 훨씬 많다는 것을 안다면, issues 테이블을 먼저 배칭하도록 쿼리를 뒤집는 것이 합리적입니다.

JOIN과 EXISTS 사용#

JOINS를 사용하는 경우는 다음과 같습니다:

  • 테이블 사이에 1:1 또는 1:N 관계가 있고, 조인되는 레코드가 (거의) 항상 존재한다는 것을 아는 경우입니다. 이는 "확장형" 테이블에 잘 맞습니다:
    • projects - project_settings
    • users - user_details
    • users - user_statuses
  • 이 경우 LEFT JOIN이 잘 동작합니다. 조인되는 테이블의 조건은 생성된 관계에 두어야 하며, 그래야 조인되는 테이블의 데이터 분포가 반복에 영향을 주지 않습니다.

예시:

User.each_batch do |relation|
  relation
    .joins("LEFT JOIN personal_access_tokens on personal_access_tokens.user_id = users.id")
    .where("personal_access_tokens.name = 'name'")
end

EXISTS 쿼리는 each_batch 쿼리의 내부 relation에만 추가해야 합니다:

User.each_batch do |relation|
  relation.where("EXISTS (SELECT 1 FROM ...")
end

relation 객체에 대한 복잡한 쿼리#

relation 객체에 추가 조건이 여러 개 있으면 실행 계획이 "불안정"해질 수 있습니다.

예시:

Issue.each_batch do |relation|
  relation
    .joins(:metrics)
    .joins(:merge_requests_closing_issues)
    .where("id IN (SELECT ...)")
    .where(confidential: true)
end

여기서는 relation 쿼리가 BATCH_SIZE만큼의 사용자 레코드를 읽은 다음 제공된 쿼리에 따라 결과를 좁혀 주기를 기대합니다. 그런데 플래너는 confidential 칼럼의 인덱스를 사용한 비트맵 인덱스 조회가 쿼리를 실행하는 더 나은 방법이라고 판단할 수 있습니다. 이렇게 되면 예상보다 훨씬 많은 행을 읽게 되고 쿼리가 시간 초과될 수 있습니다.

문제는 이렇습니다. 관계가 최대 BATCH_SIZE개의 레코드를 반환한다는 것을 우리는 확실히 압니다. 그러나 플래너는 이를 알지 못합니다.

범위 쿼리를 먼저 실행하도록 강제하는 공통 테이블 식(CTE) 기법입니다:

Issue.each_batch(of: 1000) do |relation|
  cte = Gitlab::SQL::CTE.new(:batched_relation, relation.limit(1000))

  scope = cte
    .apply_to(Issue.all)
    .joins(:metrics)
    .joins(:merge_requests_closing_issues)
    .where("id IN (SELECT ...)")
    .where(confidential: true)

  puts scope.to_a
end

레코드 카운팅#

데이터가 많은 테이블에서는 쿼리로 레코드를 카운팅하면 시간 초과가 발생할 수 있습니다. EachBatch 모듈은 레코드를 반복적으로 카운팅하는 대안을 제공합니다. each_batch를 사용하는 단점은 생성된 관계 객체에서 실행되는 추가 카운트 쿼리입니다.

each_batch_count 메서드는 추가 카운트 쿼리가 필요하지 않은 더 효율적인 접근 방식입니다. 이 메서드를 호출하면 반복 프로세스를 필요에 따라 일시 중지하고 재개할 수 있습니다. 이 기능은 Sidekiq 워커에서 카운팅 연산을 수행할 때처럼 5분이 지나면 오류 예산 위반이 발생하는 상황에서 특히 유용합니다.

예를 들어 EachBatch로 레코드를 카운팅하면 다음과 같이 추가 카운트 쿼리를 호출하게 됩니다:

count = 0

Issue.each_batch do |relation|
  count += relation.count
end

puts count

반면 each_batch_count 메서드를 사용하면 추가 카운트 쿼리를 호출하지 않고 카운팅을 더 효율적으로 수행할 수 있습니다(카운팅이 반복 쿼리의 일부입니다):

count, _last_value = Issue.each_batch_count # last value can be ignored here

또한 each_batch_count 메서드는 카운팅 과정을 어느 시점에서든 일시 중지하고 재개할 수 있게 합니다. 다음 코드 스니펫이 이 기능을 보여 줍니다:

stop_at = Time.current + 3.minutes

count, last_value = Issue.each_batch_count do
  stop_at.past? # condition for stopping the counting
end

# Continue the counting later
stop_at = Time.current + 3.minutes

count, last_value = Issue.each_batch_count(last_count: count, last_value: last_value) do
  stop_at.past?
end

EachBatch와 BatchCount 비교#

Service Ping용 카운터를 새로 추가할 때 레코드를 카운팅하는 선호 방법은 Gitlab::Database::BatchCount 클래스를 사용하는 것입니다. BatchCount에 구현된 반복 로직은 EachBatch와 비슷한 성능 특성을 가집니다. 앞에서 언급한 BatchCount 개선을 위한 팁과 제안 대부분은 BatchCount에도 적용됩니다.

키셋 페이지네이션으로 반복#

EachBatch로 반복하는 것이 동작하지 않는 특수한 경우가 몇 가지 있습니다. EachBatch는 고유한 칼럼 하나(보통 기본 키)를 요구하므로, 타임스탬프 칼럼과 복합 기본 키가 있는 테이블에서는 반복이 불가능합니다.

EachBatch가 동작하지 않는 경우에는 키셋 페이지네이션을 사용해 테이블이나 행 범위를 반복할 수 있습니다. 확장성과 성능 특성은 EachBatch와 매우 비슷합니다.

예시:

  • 정렬에 사용하는 칼럼에 고유한 값이 없는 경우, 타이-브레이커와 함께 특정 순서(타임스탬프 칼럼)로 테이블을 반복합니다.
  • 복합 기본 키가 있는 테이블을 반복합니다.

프로젝트의 이슈를 생성 날짜별로 반복#

키셋 페이지네이션을 사용하면 특정 순서(예를 들어 created_at DESC)로 임의의 데이터베이스 칼럼을 반복할 수 있습니다. created_at 값이 같은 레코드의 순서를 일관되게 유지하려면 고유한 값을 가진 타이-브레이커 칼럼(예를 들어 id)을 사용합니다.

issues 테이블에 다음 인덱스가 있다고 가정합니다:

idx_issues_on_project_id_and_created_at_and_id" btree (project_id, created_at, id)

추가 처리를 위한 레코드 가져오기#

다음 스니펫은 지정한 순서(created_at, id)로 프로젝트 안의 이슈 레코드를 반복 처리합니다.

scope = Issue.where(project_id: 278964).order(:created_at, :id) # id is the tie-breaker

iterator = Gitlab::Pagination::Keyset::Iterator.new(scope: scope)

iterator.each_batch(of: 100) do |records|
  puts records.map(&:id)
end

쿼리에 필터를 추가할 수 있습니다. 다음 예시는 최근 30일 동안 생성된 이슈 ID만 나열합니다:

scope = Issue.where(project_id: 278964).where('created_at > ?', 30.days.ago).order(:created_at, :id) # id is the tie-breaker

iterator = Gitlab::Pagination::Keyset::Iterator.new(scope: scope)

iterator.each_batch(of: 100) do |records|
  puts records.map(&:id)
end

배치에서 레코드 업데이트#

복잡한 ActiveRecord 쿼리에서는 .update_all 메서드가 잘 동작하지 않습니다. 잘못된 UPDATE 문을 생성하기 때문입니다. 배치로 레코드를 업데이트할 때는 원시 SQL을 사용할 수 있습니다:

scope = Issue.where(project_id: 278964).order(:created_at, :id) # id is the tie-breaker

iterator = Gitlab::Pagination::Keyset::Iterator.new(scope: scope)

iterator.each_batch(of: 100) do |records|
  ApplicationRecord.connection.execute("UPDATE issues SET updated_at=NOW() WHERE issues.id in (#{records.dup.reselect(:id).to_sql})")
end
Note

반복을 안정적이고 예측 가능하게 유지하려면 ORDER BY 절의 칼럼을 업데이트하지 않습니다.

merge_request_diff_commits 테이블 반복#

merge_request_diff_commits 테이블은 복합 기본 키(merge_request_diff_id, relative_order)를 사용하므로 EachBatch를 효율적으로 사용할 수 없습니다.

merge_request_diff_commits 테이블을 페이지네이션하려면 다음 스니펫을 사용할 수 있습니다:

# Custom order object configuration:
order = Gitlab::Pagination::Keyset::Order.build([
  Gitlab::Pagination::Keyset::ColumnOrderDefinition.new(
    attribute_name: 'merge_request_diff_id',
    order_expression: MergeRequestDiffCommit.arel_table[:merge_request_diff_id].asc,
    nullable: :not_nullable
  ),
  Gitlab::Pagination::Keyset::ColumnOrderDefinition.new(
    attribute_name: 'relative_order',
    order_expression: MergeRequestDiffCommit.arel_table[:relative_order].asc,
    nullable: :not_nullable
  )
])
MergeRequestDiffCommit.include(FromUnion) # keyset pagination generates UNION queries

scope = MergeRequestDiffCommit.order(order)

iterator = Gitlab::Pagination::Keyset::Iterator.new(scope: scope)

iterator.each_batch(of: 100) do |records|
  puts records.map { |record| [record.merge_request_diff_id, record.relative_order] }.inspect
end

Order 객체 구성#

키셋 페이지네이션은 단순한 ActiveRecord order 스코프와 잘 동작합니다 (첫 번째 예시). 그러나 특수한 경우에는 기반 키셋 페이지네이션 라이브러리를 위해 ORDER BY 절의 칼럼을 직접 기술해야 합니다(두 번째 예시). 키셋 페이지네이션 라이브러리가 ORDER BY 구성을 자동으로 판별할 수 없으면 오류가 발생합니다.

ORDER BY 절을 구성할 때 사용할 수 있는 옵션의 개요는 Gitlab::Pagination::Keyset::Order 및 Gitlab::Pagination::Keyset::ColumnOrderDefinition 클래스의 코드 주석에서 확인할 수 있습니다. 몇 가지 코드 예시는 키셋 페이지네이션 문서에서도 찾을 수 있습니다.