



InfoGrab DocsInfoGrab Docs

페이지네이션 가이드라인

요약

이 문서는 GitLab에서, 특히 PostgreSQL에서 데이터를 페이지네이션하는 현재 기능의 개요와 모범 사례를 제공합니다. 페이지네이션은 하나의 웹 요청에서 너무 많은 데이터를 로드하지 않기 위한 일반적인 기법입니다.

이 문서는 GitLab에서, 특히 PostgreSQL에서 데이터를 페이지네이션하는 현재 기능의 개요와 모범 사례를 제공합니다.

페이지네이션이 필요한 이유#

페이지네이션은 하나의 웹 요청에서 너무 많은 데이터를 로드하지 않기 위한 일반적인 기법입니다. 보통 레코드 목록을 렌더링할 때 발생합니다. 대표적인 시나리오는 UI에서 부모-자식 관계(has many)를 시각화하는 경우입니다.

예시: 프로젝트 내 이슈 목록 표시

프로젝트 내 이슈 수가 늘어날수록 목록이 길어집니다. 목록을 렌더링하기 위해 백엔드는 다음을 수행합니다.

  1. 데이터베이스에서 레코드를 로드합니다. 보통 특정 순서로 로드합니다.
  2. Ruby에서 레코드를 직렬화합니다. Ruby(ActiveRecord) 객체를 빌드한 다음 JSON 또는 HTML 문자열을 빌드합니다.
  3. 브라우저로 응답을 반환합니다.
  4. 브라우저가 콘텐츠를 렌더링합니다.

콘텐츠 렌더링 방식은 두 가지입니다.

  • HTML: 백엔드가 렌더링을 처리합니다(HAML 템플릿).
  • JSON: 클라이언트(클라이언트 측 JavaScript)가 페이로드를 HTML로 변환합니다.

긴 목록을 렌더링하면 프론트엔드와 백엔드 성능 모두에 큰 영향을 줄 수 있습니다.

  • 데이터베이스가 디스크에서 많은 데이터를 읽습니다.
  • 쿼리 결과(레코드)는 결국 Ruby 객체로 변환되어 메모리 할당이 늘어납니다.
  • 응답이 크면 사용자 브라우저로 전송하는 데 시간이 더 걸립니다.
  • 긴 목록을 렌더링하면 브라우저가 멈출 수 있습니다(나쁜 사용자 경험).

페이지네이션을 사용하면 데이터가 동일한 크기의 조각(페이지)으로 나뉩니다. 첫 방문 시 사용자는 제한된 수의 항목(페이지 크기)만 받습니다. 사용자는 앞으로 페이지를 이동해 더 많은 항목을 볼 수 있으며, 이때 새로운 HTTP 요청과 새로운 데이터베이스 쿼리가 발생합니다.
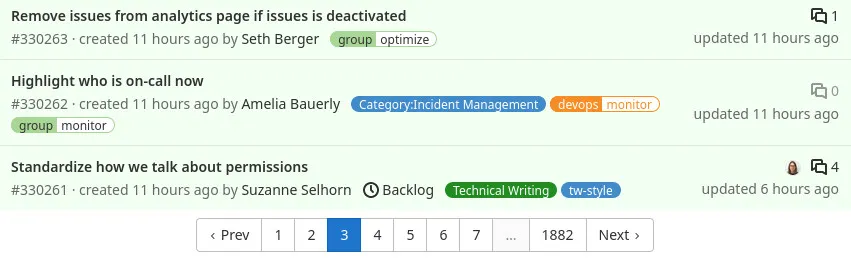
페이지네이션이 적용된 프로젝트 이슈 페이지

페이지네이션 일반 가이드라인#

올바른 접근 방식 선택#

페이지네이션, 필터링, 데이터 조회는 데이터베이스가 처리하도록 맡깁니다. 백엔드의 인메모리 페이지네이션(Kaminari의 paginate_array)이나 프론트엔드(JavaScript) 페이지네이션은 레코드가 수백 개 수준이면 동작할 수 있습니다. 애플리케이션 제한을 정의하지 않으면 상황이 빠르게 통제를 벗어납니다.

복잡성 줄이기#

페이지에 레코드를 나열할 때 추가 필터와 여러 정렬 옵션을 함께 제공하는 경우가 많습니다. 이는 백엔드 측 복잡성을 크게 높입니다.

MVC 버전에서는 다음을 고려합니다.

  • 정렬 옵션 수를 최소한으로 줄입니다.
  • 필터 수(드롭다운 목록, 검색창)를 최소한으로 줄입니다.

정렬과 페이지네이션을 효율적으로 만들려면 각 정렬 옵션마다 최소 두 개의 데이터베이스 인덱스(오름차순, 내림차순)가 필요합니다. 필터 옵션(상태별 또는 작성자별)을 추가하면 좋은 성능을 유지하기 위해 더 많은 인덱스가 필요할 수 있습니다. 인덱스는 공짜가 아니며 UPDATE 쿼리 시간에 큰 영향을 줄 수 있습니다.

모든 필터와 정렬 조합을 성능적으로 만족시킬 수는 없으므로, 사용 패턴을 기준으로 성능을 최적화합니다.

확장 대비#

오프셋 기반 페이지네이션은 레코드를 페이지네이션하는 가장 쉬운 방법입니다. 다만 대용량 데이터베이스 테이블에서는 확장성이 떨어집니다. 장기적인 해결책으로는 keyset 페이지네이션을 권장합니다. 오프셋과 keyset 페이지네이션 간 전환은 대체로 간단하며, 다음 조건을 충족하면 최종 사용자에게 영향을 주지 않고 수행할 수 있습니다.

  • 전체 개수 표시를 피하고 제한 개수를 사용합니다.
    • 예시: 최대 1001개의 레코드를 세고, 개수가 1001이면 UI에 1000+를 표시하고 그렇지 않으면 실제 숫자를 표시합니다.
    • 자세한 내용은 배지 카운터 접근 방식을 참고합니다.
  • 페이지 번호를 쓰지 않고 다음·이전 페이지 버튼을 사용합니다.
    • Keyset 페이지네이션은 페이지 번호를 지원하지 않습니다.
  • API에서는 다음 페이지 URL을 "직접" 조립하지 않도록 안내합니다.
    • 백엔드가 다음·이전 페이지 URL을 제공하는 Link 헤더 사용을 권장합니다.
    • 이 방식이면 이전 버전 호환성을 깨지 않고 URL 구조를 바꿀 수 있습니다.
Note

무한 스크롤은 페이지 번호가 노출되지 않으므로 사용자 경험에 영향을 주지 않고 keyset 페이지네이션을 사용할 수 있습니다.

페이지네이션 옵션#

오프셋 페이지네이션#

목록을 페이지네이션하는 가장 일반적인 방법은 오프셋 기반 페이지네이션입니다(UI 및 REST API). 이 방식은 ActiveRecord 쿼리에 페이지네이션을 구현하는 편리한 헬퍼 메서드를 제공하는 Kaminari Ruby gem을 기반으로 합니다.

오프셋 기반 페이지네이션은 LIMIT 및 OFFSET SQL 절을 활용해 테이블에서 특정 구간을 가져옵니다.

프로젝트 내 이슈의 두 번째 페이지를 조회할 때의 데이터베이스 쿼리 예시입니다.

SELECT issues.* FROM issues WHERE project_id = 1 ORDER BY id LIMIT 20 OFFSET 20
  1. 테이블 행 위로 가상의 포인터를 옮겨 20개 행을 건너뜁니다.
  2. 다음 20개 행을 가져옵니다.

이 쿼리가 기본 키(id)로 행을 정렬한다는 점에 유의합니다. 데이터를 페이지네이션할 때 순서 지정은 매우 중요합니다. 순서가 없으면 반환되는 행이 비결정적이어서 최종 사용자에게 혼란을 줍니다.

페이지 번호#

페이지네이션 바 예시입니다.
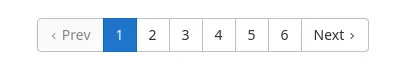
Kaminari가 렌더링한 페이지 선택기

Kaminari gem은 UI에 페이지 번호와 함께 선택적으로 다음·이전·첫 페이지·마지막 페이지 버튼 단축 링크를 포함한 페이지네이션 바를 렌더링합니다. 이 버튼을 렌더링하려면 Kaminari가 행 수를 알아야 하므로 count 쿼리가 실행됩니다.

SELECT COUNT(*) FROM issues WHERE project_id = 1

성능#

인덱스 커버리지#

좋은 성능을 얻으려면 ORDER BY 절이 인덱스로 커버되어야 합니다.

다음 인덱스가 있다고 가정합니다.

CREATE INDEX index_on_issues_project_id ON issues (project_id);

첫 번째 페이지를 요청해 봅니다.

SELECT issues.* FROM issues WHERE project_id = 1 ORDER BY id LIMIT 20;

Rails에서 동일한 쿼리를 만들 수 있습니다.

Issue.where(project_id: 1).page(1).per(20)

이 SQL 쿼리는 데이터베이스에서 최대 20개 행을 반환합니다. 다만 데이터베이스가 결과를 만들기 위해 디스크에서 20개 행만 읽는다는 뜻은 아닙니다.

실제로는 다음과 같이 동작합니다.

  1. 데이터베이스는 테이블 통계와 사용 가능한 인덱스를 기반으로 가장 효율적인 실행 계획을 세우려 합니다.
  2. 플래너는 project_id 칼럼을 커버하는 인덱스가 있음을 알고 있습니다.
  3. 데이터베이스는 project_id 인덱스를 사용해 모든 행을 읽습니다.
  4. 이 시점의 행은 정렬되어 있지 않으므로 데이터베이스가 행을 정렬합니다.
  5. 데이터베이스가 처음 20개 행을 반환합니다.

프로젝트에 10,000개 행이 있으면 데이터베이스는 10,000개 행을 읽어 메모리(또는 디스크)에서 정렬합니다. 이는 장기적으로 확장성이 떨어집니다.

이를 해결하려면 다음 인덱스가 필요합니다.

CREATE INDEX index_on_issues_project_id ON issues (project_id, id);

id 칼럼을 인덱스에 포함하면 앞의 쿼리는 최대 20개 행만 읽습니다. 프로젝트 내 이슈 수와 무관하게 쿼리 성능이 유지됩니다. 따라서 이 변경으로 최초 페이지 로드(사용자가 이슈 페이지를 여는 시점)도 개선됩니다.

Note

여기서는 b-tree 데이터베이스 인덱스의 정렬 속성을 활용합니다. 인덱스의 값이 정렬되어 있으므로 20개 행을 읽는 데 추가 정렬이 필요하지 않습니다.

알려진 문제#

대용량 데이터셋에서의 COUNT(*)#

Kaminari는 기본적으로 페이지 링크를 렌더링할 페이지 수를 파악하기 위해 count 쿼리를 실행합니다. count 쿼리는 대용량 테이블에서 상당히 비쌀 수 있습니다. 최악의 경우 쿼리가 타임아웃됩니다.

이를 우회하려면 count SQL 쿼리를 호출하지 않고 Kaminari를 실행할 수 있습니다.

Issue.where(project_id: 1).page(1).per(20).without_count

이 경우 count 쿼리는 실행되지 않으며 페이지네이션이 페이지 번호를 렌더링하지 않습니다. 다음·이전 링크만 표시됩니다.

대용량 데이터셋에서의 OFFSET#

대용량 데이터셋을 페이지네이션하면 응답 시간이 점점 느려지는 현상이 나타납니다. 행을 훑으며 N개 행을 건너뛰는 OFFSET 절 때문입니다.

사용자 관점에서는 항상 체감되지는 않습니다. 사용자가 앞으로 페이지를 이동할 때는 이전 행이 데이터베이스 버퍼 캐시에 남아 있을 수 있습니다. 사용자가 그 링크를 다른 사람과 공유하고 몇 분 또는 몇 시간 뒤에 열면 응답 시간이 크게 늘어나거나 타임아웃될 수 있습니다.

큰 페이지 번호를 요청하면 데이터베이스는 PAGE * PAGE_SIZE개 행을 읽어야 합니다. 이 때문에 오프셋 페이지네이션은 대용량 데이터베이스 테이블에 적합하지 않습니다. 다만 최적화 기법을 적용하면 데이터베이스 쿼리의 전반적인 성능을 다소 개선할 수 있습니다.

예시: Admin area에서 사용자 목록 표시

매우 단순한 SQL 쿼리로 사용자 목록을 표시합니다.

SELECT "users".* FROM "users" ORDER BY "users"."id" DESC LIMIT 20 OFFSET 0

쿼리 실행 계획을 보면 이 쿼리는 효율적이며 데이터베이스가 20개 행만 읽었습니다(rows=20).

 Limit  (cost=0.43..3.19 rows=20 width=1309) (actual time=0.098..2.093 rows=20 loops=1)
   Buffers: shared hit=103
   ->  Index Scan Backward using users_pkey on users  (cost=0.43..X rows=X width=1309) (actual time=0.097..2.087 rows=20 loops=1)
         Buffers: shared hit=103
 Planning Time: 0.333 ms
 Execution Time: 2.145 ms
(6 rows)

실행 계획 읽는 법은 EXPLAIN 계획 이해하기를 참고합니다.

50,000번째 페이지를 방문해 봅니다.

SELECT "users".* FROM "users" ORDER BY "users"."id" DESC LIMIT 20 OFFSET 999980;

실행 계획을 보면 데이터베이스가 20개 행을 반환하기 위해 1,000,000개 행을 읽었고 실행 시간이 매우 길었습니다(5.5초).

Limit  (cost=137878.89..137881.65 rows=20 width=1309) (actual time=5523.588..5523.667 rows=20 loops=1)
   Buffers: shared hit=1007901 read=14774 written=609
   I/O Timings: read=420.591 write=57.344
   ->  Index Scan Backward using users_pkey on users  (cost=0.43..X rows=X width=1309) (actual time=0.060..5459.353 rows=1000000 loops=1)
         Buffers: shared hit=1007901 read=14774 written=609
         I/O Timings: read=420.591 write=57.344
 Planning Time: 0.821 ms
 Execution Time: 5523.745 ms
(8 rows)

일반적인 사용자는 이런 페이지를 방문하지 않는다고 볼 수도 있습니다. 다만 API 사용자는 매우 높은 페이지 번호까지 이동할 수 있습니다(스크래핑, 데이터 수집).

Keyset 페이지네이션#

Keyset 페이지네이션은 큰 페이지를 요청할 때 이전 행을 "건너뛰는" 데서 오는 성능 문제를 해결합니다. 다만 오프셋 기반 페이지네이션을 그대로 대체하지는 못합니다. API 엔드포인트를 오프셋 기반에서 keyset 기반 페이지네이션으로 옮길 때는 두 방식을 모두 지원해야 합니다. 한쪽 페이지네이션 유형을 완전히 제거하는 것은 브레이킹 체인지입니다.

Keyset 페이지네이션은 GraphQL API와 REST API 양쪽에서 사용됩니다.

다음 issues 테이블을 살펴봅니다.

id project_id
1 1
2 1
3 2
4 1
5 1
6 2
7 2
8 1
9 1
10 2

기본 키(id)로 정렬해 테이블 전체를 페이지네이션해 봅니다. 첫 페이지 쿼리는 오프셋 페이지네이션 쿼리와 동일하며, 단순화를 위해 페이지 크기로 5를 사용합니다.

SELECT "issues".* FROM "issues" ORDER BY "issues"."id" ASC LIMIT 5

OFFSET 절을 추가하지 않았다는 점에 유의합니다.

다음 페이지로 이동하려면 마지막 행에서 ORDER BY 절에 포함된 값을 추출해야 합니다. 이 경우 필요한 값은 id인 5뿐입니다. 이제 다음 페이지 쿼리를 구성합니다.

SELECT "issues".* FROM "issues" WHERE "issues"."id" > 5 ORDER BY "issues"."id" ASC LIMIT 5

쿼리 실행 계획을 보면 이 쿼리는 5개 행만 읽었습니다(오프셋 기반 페이지네이션이라면 10개 행을 읽습니다).

 Limit  (cost=0.56..2.08 rows=5 width=1301) (actual time=0.093..0.137 rows=5 loops=1)
   ->  Index Scan using issues_pkey on issues  (cost=0.56..X rows=X width=1301) (actual time=0.092..0.136 rows=5 loops=1)
         Index Cond: (id > 5)
 Planning Time: 7.710 ms
 Execution Time: 0.224 ms
(5 rows)

알려진 문제#

페이지 번호 미지원#

오프셋 페이지네이션은 특정 페이지를 간단히 요청할 수 있습니다. URL을 편집해 page= URL 파라미터를 수정하면 됩니다. Keyset 페이지네이션은 페이징 로직이 서로 다른 칼럼에 의존할 수 있으므로 페이지 번호를 제공하지 못합니다.

앞의 예시에서 칼럼은 id이므로 URL에서 다음과 같은 형태를 볼 수 있습니다.

id_after=5

GraphQL에서는 파라미터가 JSON으로 직렬화된 다음 인코딩됩니다.

eyJpZCI6Ijk0NzMzNTk0IiwidXBkYXRlZF9hdCI6IjIwMjEtMDQtMDkgMDg6NTA6MDUuODA1ODg0MDAwIFVUQyJ9
Note

페이지네이션 파라미터는 사용자에게 노출되므로 어떤 칼럼으로 정렬할지 신중하게 정합니다.

Keyset 페이지네이션은 다음·이전·첫 페이지·마지막 페이지만 제공할 수 있습니다.

복잡성#

단일 칼럼으로 정렬할 때는 쿼리 작성이 매우 쉽습니다. 다만 타이 브레이커나 다중 칼럼 정렬을 쓰면 더 복잡해집니다. 칼럼이 nullable이면 복잡성이 한층 커집니다.

예시: created_at이 nullable인 상태에서 id와 created_at으로 정렬할 때, 두 번째 페이지를 가져오는 쿼리입니다.

SELECT "issues".*
FROM "issues"
WHERE (("issues"."id" > 99
        AND "issues"."created_at" = '2021-02-16 11:26:17.408466')
       OR ("issues"."created_at" > '2021-02-16 11:26:17.408466')
       OR ("issues"."created_at" IS NULL))
ORDER BY "issues"."created_at" DESC NULLS LAST, "issues"."id" DESC
LIMIT 20
도구#

GitLab 프로젝트에는 범용 keyset 페이지네이션 라이브러리가 있으며, 대부분의 경우 기존 Kaminari 기반 페이지네이션을 손쉽게 대체해 대용량 데이터셋을 다룰 때 성능을 크게 개선합니다.

예시:

# first page
paginator = Project.order(:created_at, :id).keyset_paginate(per_page: 20)
puts paginator.to_a # records

# next page
cursor = paginator.cursor_for_next_page
paginator = Project.order(:created_at, :id).keyset_paginate(cursor: cursor, per_page: 20)
puts paginator.to_a # records

전체적인 개요는 keyset 페이지네이션 가이드 페이지를 참고합니다.

성능#

Keyset 페이지네이션은 앞으로 몇 페이지를 이동했든 일정한 성능을 제공합니다. 이 성능을 얻으려면 오프셋 페이지네이션과 마찬가지로 페이지네이션 쿼리에 ORDER BY 절의 모든 칼럼을 커버하는 인덱스가 필요합니다.

일반 성능 가이드라인#

페이지네이션 일반 성능 가이드라인 페이지를 참고합니다.

페이지네이션 가이드라인

GitLab v19.4
원문 보기

요약

이 문서는 GitLab에서, 특히 PostgreSQL에서 데이터를 페이지네이션하는 현재 기능의 개요와 모범 사례를 제공합니다. 페이지네이션은 하나의 웹 요청에서 너무 많은 데이터를 로드하지 않기 위한 일반적인 기법입니다.

이 문서는 GitLab에서, 특히 PostgreSQL에서 데이터를 페이지네이션하는 현재 기능의 개요와 모범 사례를 제공합니다.

페이지네이션이 필요한 이유#

페이지네이션은 하나의 웹 요청에서 너무 많은 데이터를 로드하지 않기 위한 일반적인 기법입니다. 보통 레코드 목록을 렌더링할 때 발생합니다. 대표적인 시나리오는 UI에서 부모-자식 관계(has many)를 시각화하는 경우입니다.

예시: 프로젝트 내 이슈 목록 표시

프로젝트 내 이슈 수가 늘어날수록 목록이 길어집니다. 목록을 렌더링하기 위해 백엔드는 다음을 수행합니다.

  1. 데이터베이스에서 레코드를 로드합니다. 보통 특정 순서로 로드합니다.
  2. Ruby에서 레코드를 직렬화합니다. Ruby(ActiveRecord) 객체를 빌드한 다음 JSON 또는 HTML 문자열을 빌드합니다.
  3. 브라우저로 응답을 반환합니다.
  4. 브라우저가 콘텐츠를 렌더링합니다.

콘텐츠 렌더링 방식은 두 가지입니다.

  • HTML: 백엔드가 렌더링을 처리합니다(HAML 템플릿).
  • JSON: 클라이언트(클라이언트 측 JavaScript)가 페이로드를 HTML로 변환합니다.

긴 목록을 렌더링하면 프론트엔드와 백엔드 성능 모두에 큰 영향을 줄 수 있습니다.

  • 데이터베이스가 디스크에서 많은 데이터를 읽습니다.
  • 쿼리 결과(레코드)는 결국 Ruby 객체로 변환되어 메모리 할당이 늘어납니다.
  • 응답이 크면 사용자 브라우저로 전송하는 데 시간이 더 걸립니다.
  • 긴 목록을 렌더링하면 브라우저가 멈출 수 있습니다(나쁜 사용자 경험).

페이지네이션을 사용하면 데이터가 동일한 크기의 조각(페이지)으로 나뉩니다. 첫 방문 시 사용자는 제한된 수의 항목(페이지 크기)만 받습니다. 사용자는 앞으로 페이지를 이동해 더 많은 항목을 볼 수 있으며, 이때 새로운 HTTP 요청과 새로운 데이터베이스 쿼리가 발생합니다.

페이지네이션이 적용된 프로젝트 이슈 페이지

페이지네이션 일반 가이드라인#

올바른 접근 방식 선택#

페이지네이션, 필터링, 데이터 조회는 데이터베이스가 처리하도록 맡깁니다. 백엔드의 인메모리 페이지네이션(Kaminari의 paginate_array)이나 프론트엔드(JavaScript) 페이지네이션은 레코드가 수백 개 수준이면 동작할 수 있습니다. 애플리케이션 제한을 정의하지 않으면 상황이 빠르게 통제를 벗어납니다.

복잡성 줄이기#

페이지에 레코드를 나열할 때 추가 필터와 여러 정렬 옵션을 함께 제공하는 경우가 많습니다. 이는 백엔드 측 복잡성을 크게 높입니다.

MVC 버전에서는 다음을 고려합니다.

  • 정렬 옵션 수를 최소한으로 줄입니다.
  • 필터 수(드롭다운 목록, 검색창)를 최소한으로 줄입니다.

정렬과 페이지네이션을 효율적으로 만들려면 각 정렬 옵션마다 최소 두 개의 데이터베이스 인덱스(오름차순, 내림차순)가 필요합니다. 필터 옵션(상태별 또는 작성자별)을 추가하면 좋은 성능을 유지하기 위해 더 많은 인덱스가 필요할 수 있습니다. 인덱스는 공짜가 아니며 UPDATE 쿼리 시간에 큰 영향을 줄 수 있습니다.

모든 필터와 정렬 조합을 성능적으로 만족시킬 수는 없으므로, 사용 패턴을 기준으로 성능을 최적화합니다.

확장 대비#

오프셋 기반 페이지네이션은 레코드를 페이지네이션하는 가장 쉬운 방법입니다. 다만 대용량 데이터베이스 테이블에서는 확장성이 떨어집니다. 장기적인 해결책으로는 keyset 페이지네이션을 권장합니다. 오프셋과 keyset 페이지네이션 간 전환은 대체로 간단하며, 다음 조건을 충족하면 최종 사용자에게 영향을 주지 않고 수행할 수 있습니다.

  • 전체 개수 표시를 피하고 제한 개수를 사용합니다.
    • 예시: 최대 1001개의 레코드를 세고, 개수가 1001이면 UI에 1000+를 표시하고 그렇지 않으면 실제 숫자를 표시합니다.
    • 자세한 내용은 배지 카운터 접근 방식을 참고합니다.
  • 페이지 번호를 쓰지 않고 다음·이전 페이지 버튼을 사용합니다.
    • Keyset 페이지네이션은 페이지 번호를 지원하지 않습니다.
  • API에서는 다음 페이지 URL을 "직접" 조립하지 않도록 안내합니다.
    • 백엔드가 다음·이전 페이지 URL을 제공하는 Link 헤더 사용을 권장합니다.
    • 이 방식이면 이전 버전 호환성을 깨지 않고 URL 구조를 바꿀 수 있습니다.
Note

무한 스크롤은 페이지 번호가 노출되지 않으므로 사용자 경험에 영향을 주지 않고 keyset 페이지네이션을 사용할 수 있습니다.

페이지네이션 옵션#

오프셋 페이지네이션#

목록을 페이지네이션하는 가장 일반적인 방법은 오프셋 기반 페이지네이션입니다(UI 및 REST API). 이 방식은 ActiveRecord 쿼리에 페이지네이션을 구현하는 편리한 헬퍼 메서드를 제공하는 Kaminari Ruby gem을 기반으로 합니다.

오프셋 기반 페이지네이션은 LIMIT 및 OFFSET SQL 절을 활용해 테이블에서 특정 구간을 가져옵니다.

프로젝트 내 이슈의 두 번째 페이지를 조회할 때의 데이터베이스 쿼리 예시입니다.

SELECT issues.* FROM issues WHERE project_id = 1 ORDER BY id LIMIT 20 OFFSET 20
  1. 테이블 행 위로 가상의 포인터를 옮겨 20개 행을 건너뜁니다.
  2. 다음 20개 행을 가져옵니다.

이 쿼리가 기본 키(id)로 행을 정렬한다는 점에 유의합니다. 데이터를 페이지네이션할 때 순서 지정은 매우 중요합니다. 순서가 없으면 반환되는 행이 비결정적이어서 최종 사용자에게 혼란을 줍니다.

페이지 번호#

페이지네이션 바 예시입니다.

Kaminari가 렌더링한 페이지 선택기

Kaminari gem은 UI에 페이지 번호와 함께 선택적으로 다음·이전·첫 페이지·마지막 페이지 버튼 단축 링크를 포함한 페이지네이션 바를 렌더링합니다. 이 버튼을 렌더링하려면 Kaminari가 행 수를 알아야 하므로 count 쿼리가 실행됩니다.

SELECT COUNT(*) FROM issues WHERE project_id = 1

성능#

인덱스 커버리지#

좋은 성능을 얻으려면 ORDER BY 절이 인덱스로 커버되어야 합니다.

다음 인덱스가 있다고 가정합니다.

CREATE INDEX index_on_issues_project_id ON issues (project_id);

첫 번째 페이지를 요청해 봅니다.

SELECT issues.* FROM issues WHERE project_id = 1 ORDER BY id LIMIT 20;

Rails에서 동일한 쿼리를 만들 수 있습니다.

Issue.where(project_id: 1).page(1).per(20)

이 SQL 쿼리는 데이터베이스에서 최대 20개 행을 반환합니다. 다만 데이터베이스가 결과를 만들기 위해 디스크에서 20개 행만 읽는다는 뜻은 아닙니다.

실제로는 다음과 같이 동작합니다.

  1. 데이터베이스는 테이블 통계와 사용 가능한 인덱스를 기반으로 가장 효율적인 실행 계획을 세우려 합니다.
  2. 플래너는 project_id 칼럼을 커버하는 인덱스가 있음을 알고 있습니다.
  3. 데이터베이스는 project_id 인덱스를 사용해 모든 행을 읽습니다.
  4. 이 시점의 행은 정렬되어 있지 않으므로 데이터베이스가 행을 정렬합니다.
  5. 데이터베이스가 처음 20개 행을 반환합니다.

프로젝트에 10,000개 행이 있으면 데이터베이스는 10,000개 행을 읽어 메모리(또는 디스크)에서 정렬합니다. 이는 장기적으로 확장성이 떨어집니다.

이를 해결하려면 다음 인덱스가 필요합니다.

CREATE INDEX index_on_issues_project_id ON issues (project_id, id);

id 칼럼을 인덱스에 포함하면 앞의 쿼리는 최대 20개 행만 읽습니다. 프로젝트 내 이슈 수와 무관하게 쿼리 성능이 유지됩니다. 따라서 이 변경으로 최초 페이지 로드(사용자가 이슈 페이지를 여는 시점)도 개선됩니다.

Note

여기서는 b-tree 데이터베이스 인덱스의 정렬 속성을 활용합니다. 인덱스의 값이 정렬되어 있으므로 20개 행을 읽는 데 추가 정렬이 필요하지 않습니다.

알려진 문제#

대용량 데이터셋에서의 COUNT(*)#

Kaminari는 기본적으로 페이지 링크를 렌더링할 페이지 수를 파악하기 위해 count 쿼리를 실행합니다. count 쿼리는 대용량 테이블에서 상당히 비쌀 수 있습니다. 최악의 경우 쿼리가 타임아웃됩니다.

이를 우회하려면 count SQL 쿼리를 호출하지 않고 Kaminari를 실행할 수 있습니다.

Issue.where(project_id: 1).page(1).per(20).without_count

이 경우 count 쿼리는 실행되지 않으며 페이지네이션이 페이지 번호를 렌더링하지 않습니다. 다음·이전 링크만 표시됩니다.

대용량 데이터셋에서의 OFFSET#

대용량 데이터셋을 페이지네이션하면 응답 시간이 점점 느려지는 현상이 나타납니다. 행을 훑으며 N개 행을 건너뛰는 OFFSET 절 때문입니다.

사용자 관점에서는 항상 체감되지는 않습니다. 사용자가 앞으로 페이지를 이동할 때는 이전 행이 데이터베이스 버퍼 캐시에 남아 있을 수 있습니다. 사용자가 그 링크를 다른 사람과 공유하고 몇 분 또는 몇 시간 뒤에 열면 응답 시간이 크게 늘어나거나 타임아웃될 수 있습니다.

큰 페이지 번호를 요청하면 데이터베이스는 PAGE * PAGE_SIZE개 행을 읽어야 합니다. 이 때문에 오프셋 페이지네이션은 대용량 데이터베이스 테이블에 적합하지 않습니다. 다만 최적화 기법을 적용하면 데이터베이스 쿼리의 전반적인 성능을 다소 개선할 수 있습니다.

예시: Admin area에서 사용자 목록 표시

매우 단순한 SQL 쿼리로 사용자 목록을 표시합니다.

SELECT "users".* FROM "users" ORDER BY "users"."id" DESC LIMIT 20 OFFSET 0

쿼리 실행 계획을 보면 이 쿼리는 효율적이며 데이터베이스가 20개 행만 읽었습니다(rows=20).

 Limit  (cost=0.43..3.19 rows=20 width=1309) (actual time=0.098..2.093 rows=20 loops=1)
   Buffers: shared hit=103
   ->  Index Scan Backward using users_pkey on users  (cost=0.43..X rows=X width=1309) (actual time=0.097..2.087 rows=20 loops=1)
         Buffers: shared hit=103
 Planning Time: 0.333 ms
 Execution Time: 2.145 ms
(6 rows)

실행 계획 읽는 법은 EXPLAIN 계획 이해하기를 참고합니다.

50,000번째 페이지를 방문해 봅니다.

SELECT "users".* FROM "users" ORDER BY "users"."id" DESC LIMIT 20 OFFSET 999980;

실행 계획을 보면 데이터베이스가 20개 행을 반환하기 위해 1,000,000개 행을 읽었고 실행 시간이 매우 길었습니다(5.5초).

Limit  (cost=137878.89..137881.65 rows=20 width=1309) (actual time=5523.588..5523.667 rows=20 loops=1)
   Buffers: shared hit=1007901 read=14774 written=609
   I/O Timings: read=420.591 write=57.344
   ->  Index Scan Backward using users_pkey on users  (cost=0.43..X rows=X width=1309) (actual time=0.060..5459.353 rows=1000000 loops=1)
         Buffers: shared hit=1007901 read=14774 written=609
         I/O Timings: read=420.591 write=57.344
 Planning Time: 0.821 ms
 Execution Time: 5523.745 ms
(8 rows)

일반적인 사용자는 이런 페이지를 방문하지 않는다고 볼 수도 있습니다. 다만 API 사용자는 매우 높은 페이지 번호까지 이동할 수 있습니다(스크래핑, 데이터 수집).

Keyset 페이지네이션#

Keyset 페이지네이션은 큰 페이지를 요청할 때 이전 행을 "건너뛰는" 데서 오는 성능 문제를 해결합니다. 다만 오프셋 기반 페이지네이션을 그대로 대체하지는 못합니다. API 엔드포인트를 오프셋 기반에서 keyset 기반 페이지네이션으로 옮길 때는 두 방식을 모두 지원해야 합니다. 한쪽 페이지네이션 유형을 완전히 제거하는 것은 브레이킹 체인지입니다.

Keyset 페이지네이션은 GraphQL API와 REST API 양쪽에서 사용됩니다.

다음 issues 테이블을 살펴봅니다.

id project_id
1 1
2 1
3 2
4 1
5 1
6 2
7 2
8 1
9 1
10 2

기본 키(id)로 정렬해 테이블 전체를 페이지네이션해 봅니다. 첫 페이지 쿼리는 오프셋 페이지네이션 쿼리와 동일하며, 단순화를 위해 페이지 크기로 5를 사용합니다.

SELECT "issues".* FROM "issues" ORDER BY "issues"."id" ASC LIMIT 5

OFFSET 절을 추가하지 않았다는 점에 유의합니다.

다음 페이지로 이동하려면 마지막 행에서 ORDER BY 절에 포함된 값을 추출해야 합니다. 이 경우 필요한 값은 id인 5뿐입니다. 이제 다음 페이지 쿼리를 구성합니다.

SELECT "issues".* FROM "issues" WHERE "issues"."id" > 5 ORDER BY "issues"."id" ASC LIMIT 5

쿼리 실행 계획을 보면 이 쿼리는 5개 행만 읽었습니다(오프셋 기반 페이지네이션이라면 10개 행을 읽습니다).

 Limit  (cost=0.56..2.08 rows=5 width=1301) (actual time=0.093..0.137 rows=5 loops=1)
   ->  Index Scan using issues_pkey on issues  (cost=0.56..X rows=X width=1301) (actual time=0.092..0.136 rows=5 loops=1)
         Index Cond: (id > 5)
 Planning Time: 7.710 ms
 Execution Time: 0.224 ms
(5 rows)

알려진 문제#

페이지 번호 미지원#

오프셋 페이지네이션은 특정 페이지를 간단히 요청할 수 있습니다. URL을 편집해 page= URL 파라미터를 수정하면 됩니다. Keyset 페이지네이션은 페이징 로직이 서로 다른 칼럼에 의존할 수 있으므로 페이지 번호를 제공하지 못합니다.

앞의 예시에서 칼럼은 id이므로 URL에서 다음과 같은 형태를 볼 수 있습니다.

id_after=5

GraphQL에서는 파라미터가 JSON으로 직렬화된 다음 인코딩됩니다.

eyJpZCI6Ijk0NzMzNTk0IiwidXBkYXRlZF9hdCI6IjIwMjEtMDQtMDkgMDg6NTA6MDUuODA1ODg0MDAwIFVUQyJ9
Note

페이지네이션 파라미터는 사용자에게 노출되므로 어떤 칼럼으로 정렬할지 신중하게 정합니다.

Keyset 페이지네이션은 다음·이전·첫 페이지·마지막 페이지만 제공할 수 있습니다.

복잡성#

단일 칼럼으로 정렬할 때는 쿼리 작성이 매우 쉽습니다. 다만 타이 브레이커나 다중 칼럼 정렬을 쓰면 더 복잡해집니다. 칼럼이 nullable이면 복잡성이 한층 커집니다.

예시: created_at이 nullable인 상태에서 id와 created_at으로 정렬할 때, 두 번째 페이지를 가져오는 쿼리입니다.

SELECT "issues".*
FROM "issues"
WHERE (("issues"."id" > 99
        AND "issues"."created_at" = '2021-02-16 11:26:17.408466')
       OR ("issues"."created_at" > '2021-02-16 11:26:17.408466')
       OR ("issues"."created_at" IS NULL))
ORDER BY "issues"."created_at" DESC NULLS LAST, "issues"."id" DESC
LIMIT 20
도구#

GitLab 프로젝트에는 범용 keyset 페이지네이션 라이브러리가 있으며, 대부분의 경우 기존 Kaminari 기반 페이지네이션을 손쉽게 대체해 대용량 데이터셋을 다룰 때 성능을 크게 개선합니다.

예시:

# first page
paginator = Project.order(:created_at, :id).keyset_paginate(per_page: 20)
puts paginator.to_a # records

# next page
cursor = paginator.cursor_for_next_page
paginator = Project.order(:created_at, :id).keyset_paginate(cursor: cursor, per_page: 20)
puts paginator.to_a # records

전체적인 개요는 keyset 페이지네이션 가이드 페이지를 참고합니다.

성능#

Keyset 페이지네이션은 앞으로 몇 페이지를 이동했든 일정한 성능을 제공합니다. 이 성능을 얻으려면 오프셋 페이지네이션과 마찬가지로 페이지네이션 쿼리에 ORDER BY 절의 모든 칼럼을 커버하는 인덱스가 필요합니다.

일반 성능 가이드라인#

페이지네이션 일반 성능 가이드라인 페이지를 참고합니다.