





읽기 전용 데이터(Read-mostly data)
GitLab v19.4요약
이 문서는 Database Scalability Working Group 에서 제시한 read-mostly 패턴을 설명합니다. 이름에서 알 수 있듯 read-mostly 데이터는 업데이트보다 읽기가 훨씬 잦은 데이터를 말합니다.
이 문서는 Database Scalability Working Group 에서 제시한 read-mostly 패턴을 설명합니다. read-mostly 데이터의 특성을 살펴보고, GitLab 개발에서 이 컨텍스트를 다룰 때 참고할 모범 사례를 제안합니다.
read-mostly 데이터의 특성#
이름에서 알 수 있듯 read-mostly 데이터는 업데이트보다 읽기가 훨씬 잦은 데이터를 말합니다. 업데이트, 삽입, 삭제로 이 데이터를 쓰는 일은 읽는 일에 비하면 매우 드뭅니다.
또한 여기에서 말하는 read-mostly 데이터는 대체로 크기가 작은 데이터셋입니다. 대용량 데이터셋도 "한 번 쓰고 자주 읽는" 특성을 가질 때가 많지만 여기에서는 다루지 않습니다.
예시: 라이선스 데이터#
대표적인 예시로 GitLab의 라이선스 데이터를 들 수 있습니다. GitLab 인스턴스는 엔터프라이즈 기능을
사용하기 위한 라이선스를 가질 수 있습니다. 이 라이선스 데이터는 인스턴스 전체 단위로 보관되며,
일반적으로 관련 레코드가 몇 건에 지나지 않습니다. 이 정보는 licenses라는
아주 작은 테이블에 저장됩니다.
이 데이터는 다음과 같이 앞서 설명한 특성을 따르므로 read-mostly 데이터로 봅니다.
- 드문 쓰기: 라이선스 데이터는 라이선스를 삽입한 뒤 쓰기가 거의 발생하지 않습니다.
- 잦은 읽기: 엔터프라이즈 기능을 사용할 수 있는지 확인하기 위해 라이선스 데이터를 매우 자주 읽습니다.
- 작은 크기: 이 데이터셋은 매우 작습니다. GitLab.com에는 레코드가 5건이며 전체 관계 크기가 50 kB 미만입니다.
대규모 환경에서 read-mostly 데이터가 미치는 영향#
이 데이터셋은 작고 매우 자주 읽히므로, 데이터가 거의 항상 데이터베이스 캐시나 데이터베이스 디스크 캐시에 있다고 볼 수 있습니다. 따라서 read-mostly 데이터에서 문제가 되는 것은 대개 데이터베이스 I/O 부담이 아닙니다. 어차피 디스크에서 데이터를 읽지 않기 때문입니다.
다만 읽기 빈도가 높다는 점을 고려하면 데이터베이스 CPU 부하와 데이터베이스 컨텍스트 전환 측면에서 부담이 생길 수 있습니다. 또한 이런 고빈도 쿼리는 데이터베이스 스택 전체를 거칩니다. 데이터베이스 연결 다중화 컴포넌트와 로드 밸런서에도 부담을 줍니다. 애플리케이션 역시 데이터를 가져오는 쿼리를 준비해 보내고, 결과를 역직렬화하고, 수집한 정보를 표현할 새 객체를 할당하는 작업을 모두 높은 빈도로 반복하면서 자원을 소모합니다.
앞의 라이선스 데이터 예시에서는 라이선스 데이터를 읽는 쿼리가 쿼리 빈도 측면에서 두드러진다는 점이 확인되었습니다. 실제로 피크 시간대에 클러스터에서 초당 약 6,000건(QPS)의 쿼리가 발생했습니다. 당시 클러스터 규모에서는 각 복제본에서 약 1,000 QPS, 피크 시간대 기본 노드에서 400 QPS 미만이 관측되었습니다. 이 차이는 순수 읽기 전용 트랜잭션에 복제본을 우선 사용하는 읽기 확장용 데이터베이스 로드 밸런싱 으로 설명됩니다.
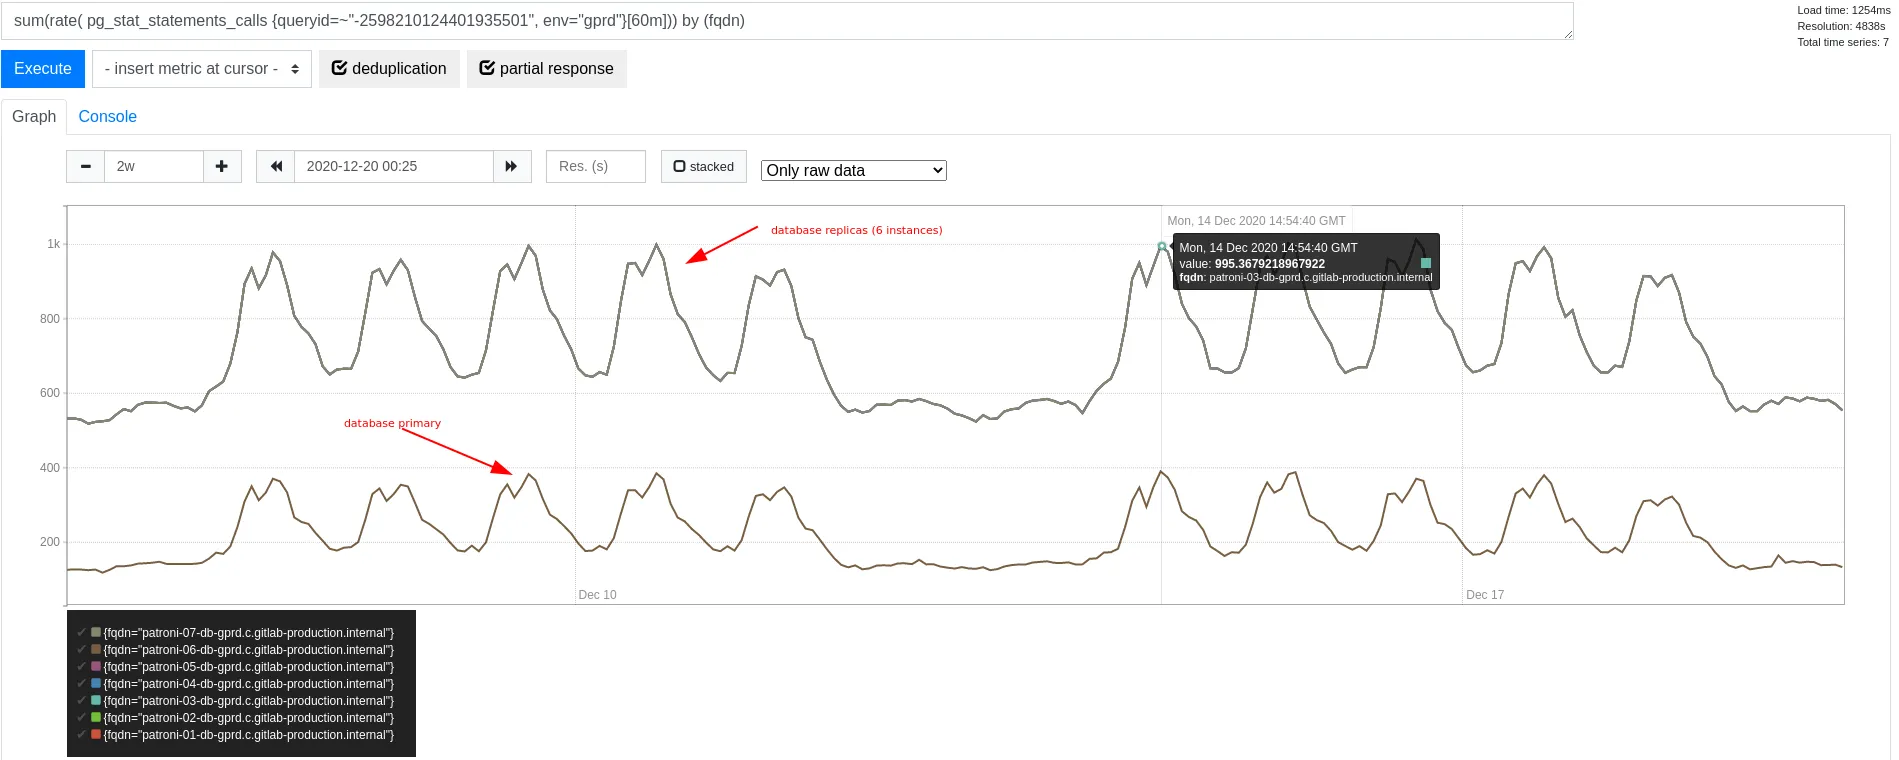
당시 데이터베이스 기본 노드의 전체 트랜잭션 처리량은 초당 50,000건에서 70,000건(TPS) 사이였습니다. 이와 비교하면 이 쿼리 빈도는 전체 쿼리 빈도에서 작은 비중에 지나지 않습니다. 그럼에도 컨텍스트 전환 측면에서는 여전히 상당한 부담이 된다고 봅니다. 없앨 수 있다면 없애는 편이 낫습니다.
read-mostly 데이터를 식별하는 방법#
예시처럼 명확한 경우도 있지만, read-mostly 데이터를 알아보기는 쉽지 않을 수 있습니다.
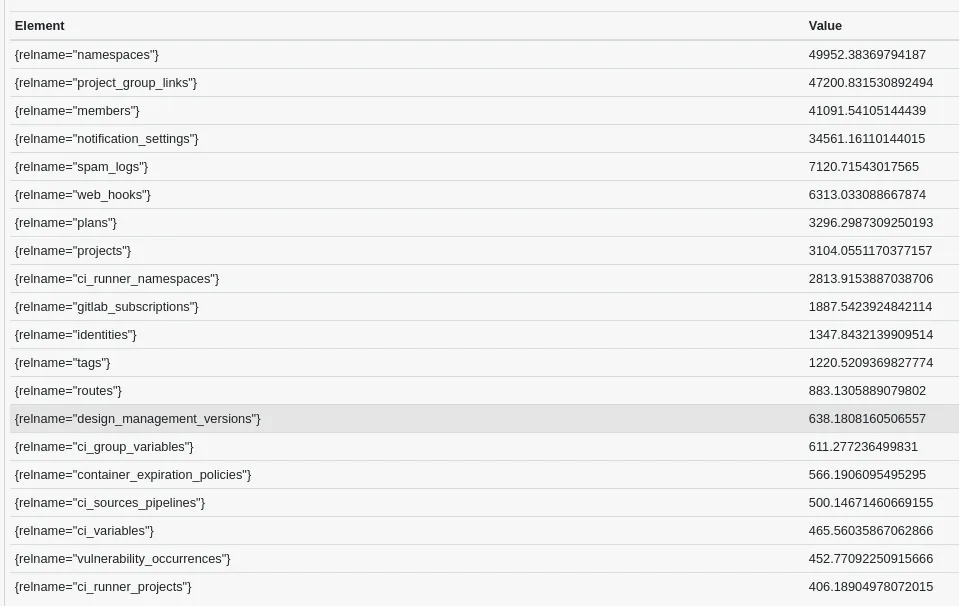
한 가지 방법은 예를 들어 기본 노드의 읽기/쓰기 비율과 통계를 살펴보는 것입니다. 아래에서는 (트래픽이 몰리는 시간대에 측정한) 60분 동안의 읽기/쓰기 비율 기준 상위 20개 테이블을 봅니다.
bottomk(20,
avg by (relname, fqdn) (
  (
      rate(pg_stat_user_tables_seq_tup_read{env="gprd"}[1h])
      +
      rate(pg_stat_user_tables_idx_tup_fetch{env="gprd"}[1h])
  ) /
  (
      rate(pg_stat_user_tables_seq_tup_read{env="gprd"}[1h])
      + rate(pg_stat_user_tables_idx_tup_fetch{env="gprd"}[1h])
      + rate(pg_stat_user_tables_n_tup_ins{env="gprd"}[1h])
      + rate(pg_stat_user_tables_n_tup_upd{env="gprd"}[1h])
      + rate(pg_stat_user_tables_n_tup_del{env="gprd"}[1h])
  )
) and on (fqdn) (pg_replication_is_replica == 0)
)
이렇게 하면 (데이터베이스 기본 노드에서) 쓰기보다 읽기가 훨씬 잦은 테이블이 무엇인지 잘 파악할 수 있습니다.
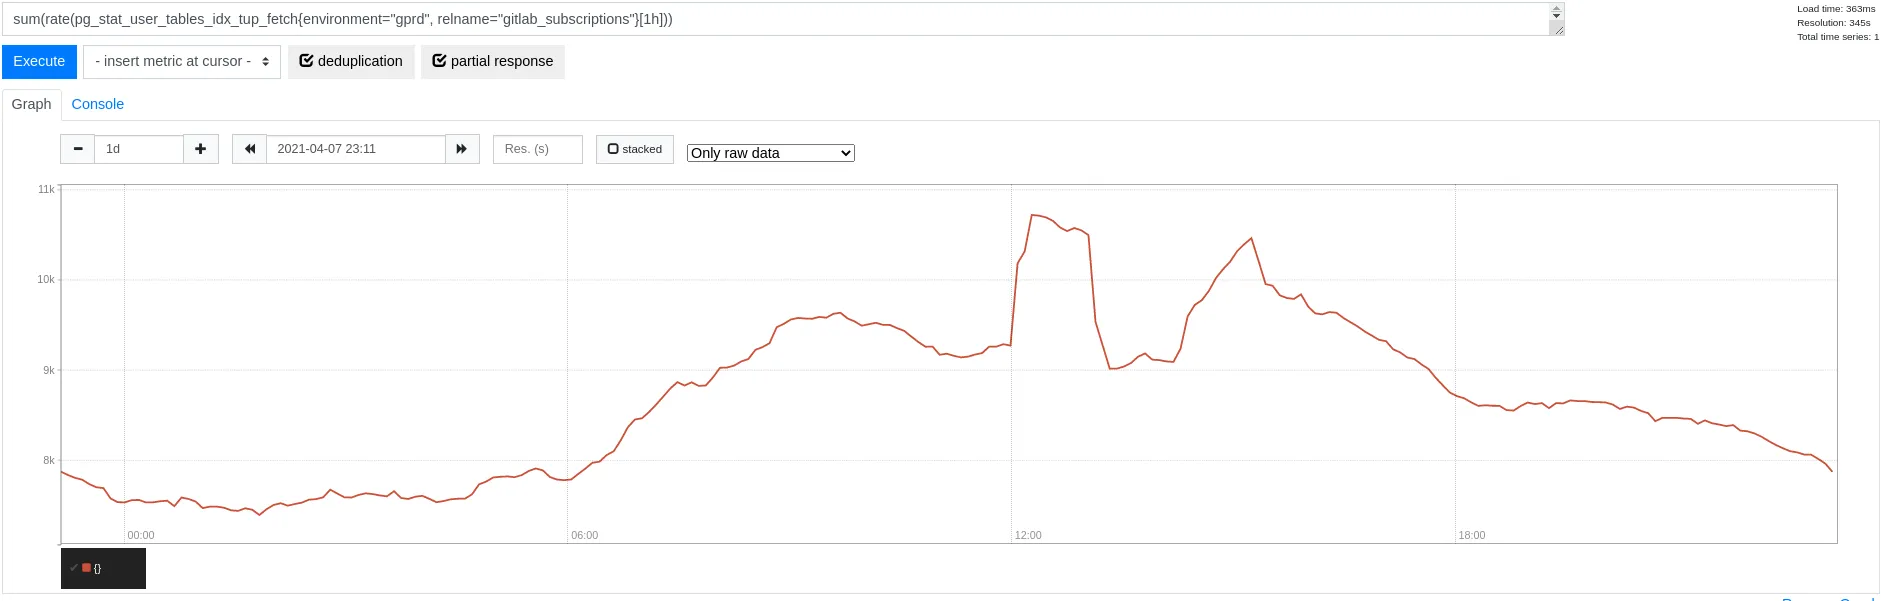
여기에서 예를 들어 gitlab_subscriptions를 확대해 보면 인덱스 읽기가 전체적으로 초당 1만 튜플을 넘는 지점까지 올라가는 것을 볼 수 있습니다(순차 스캔은 없습니다).
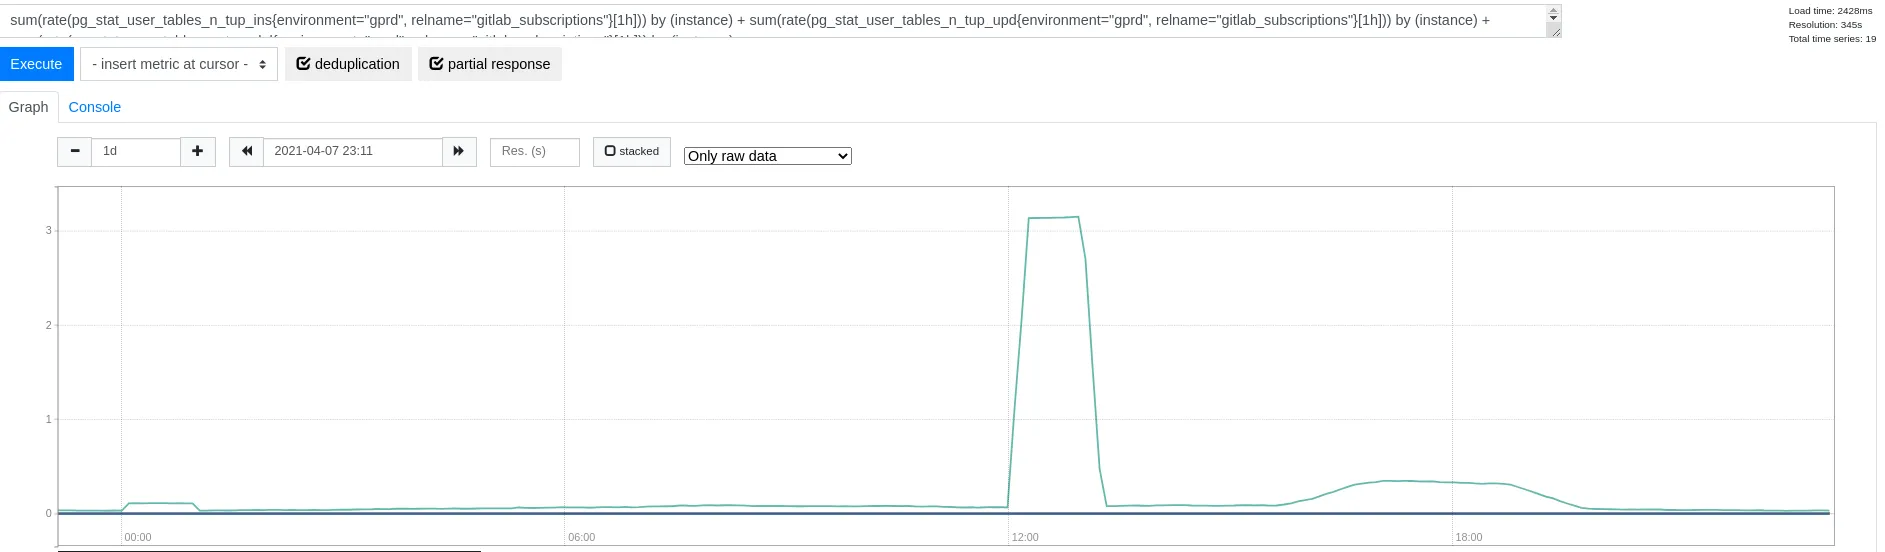
이 테이블에는 쓰기가 거의 발생하지 않습니다(순차 스캔은 없습니다).
또한 이 테이블은 크기가 400 MB에 불과하므로 이 패턴에서 함께 검토할 만한 후보가 될 수 있습니다(#327483 참고).
대규모 환경에서 read-mostly 데이터를 다루는 모범 사례#
read-mostly 데이터 캐싱#
데이터베이스 부담을 줄이기 위해 데이터에 캐시를 적용하면 데이터베이스 쪽 쿼리 빈도를 크게 낮출 수 있습니다. 사용할 수 있는 캐시 범위는 다음과 같습니다.
RequestStore: 요청 단위 인메모리 캐시(request_storegem 기반)ProcessMemoryCache: 프로세스 단위 인메모리 캐시(ActiveSupport::Cache::MemoryStore)Gitlab::Redis::Cache와Rails.cache: Redis에 두는 본격적인 캐시
앞의 예시에서는 라이선스 정보를 요청 단위로 캐싱하기 위해 RequestStore를 사용하고
있었습니다. 다만 이 방식으로도 요청마다 쿼리가 한 번씩 발생합니다. 라이선스 정보를
프로세스 단위 인메모리 캐시로
1초 동안 캐싱하기 시작하자 쿼리 빈도가 크게 떨어졌습니다.
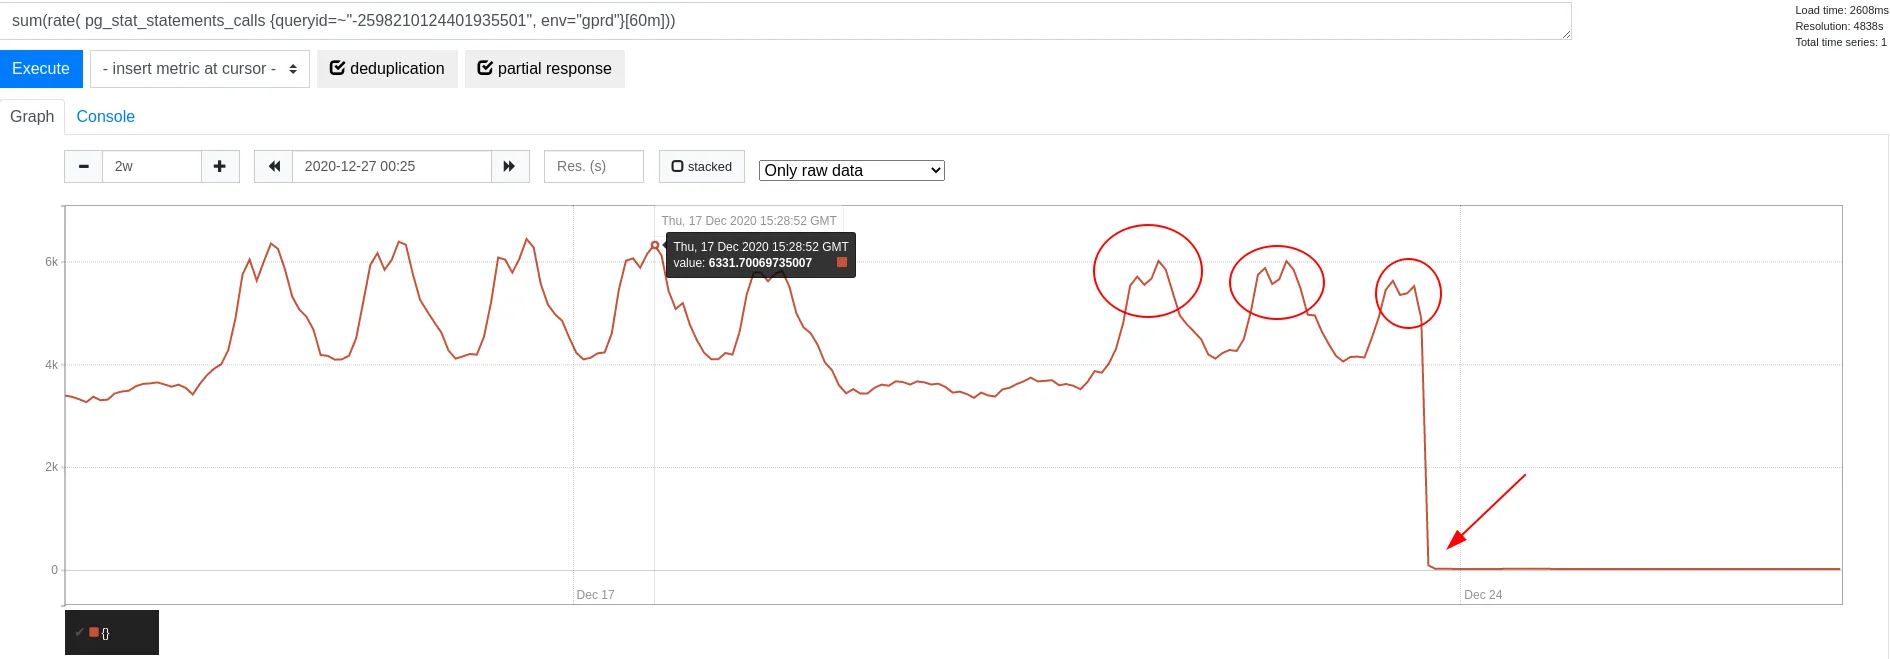
여기에서 어떤 캐시를 고를지는 대상 데이터의 특성에 크게 좌우됩니다. 라이선스 데이터처럼 매우 작고 거의 업데이트되지 않는 데이터셋은 인메모리 캐싱에 적합합니다. 캐시 갱신 주기를 들어오는 요청 빈도에서 떼어 놓을 수 있으므로 프로세스 단위 캐시가 더 유리합니다.
한 가지 유의할 점은 현재 Redis 구성이 Redis 보조 노드를 사용하지 않고 단일 노드에 캐싱을 의존한다는 것입니다. 즉, 부하가 늘어 Redis가 무너지지 않도록 균형을 잡아야 합니다. 이에 비해 PostgreSQL 복제본에서 데이터를 읽으면 여러 읽기 전용 복제본으로 분산할 수 있습니다. 데이터베이스 쿼리 비용이 더 크더라도 부하는 더 많은 노드로 분산됩니다.
복제본에서 read-mostly 데이터 읽기#
캐싱을 적용했는지와 무관하게, 가능하다면 데이터베이스 복제본에서 데이터를 읽도록 해야 합니다. 이렇게 하면 여러 데이터베이스 복제본으로 읽기를 확장하려는 방향에 부합하고, 데이터베이스 기본 노드의 불필요한 작업량을 줄일 수 있습니다.
GitLab의 읽기용 데이터베이스 로드 밸런싱 은 첫 쓰기가 발생하거나 명시적 트랜잭션을 열면 이후 기본 노드에 고정됩니다. read-mostly 데이터에서는 이 데이터를 트랜잭션 범위 밖에서, 그리고 쓰기를 수행하기 전에 읽는 것을 지향합니다. 이 데이터는 드물게만 업데이트되므로 대개 가능한 방식입니다 (예를 들어 다소 오래된 데이터를 읽어도 문제가 되지 않는 경우가 많습니다). 다만 앞선 쓰기나 트랜잭션 때문에 해당 쿼리를 복제본으로 보낼 수 없다는 사실이 겉으로 드러나지 않을 수 있습니다. 그러므로 read-mostly 데이터를 만나면 더 넓은 컨텍스트를 확인해 이 데이터를 복제본에서 읽을 수 있는지 점검하는 것이 좋습니다.