



InfoGrab DocsInfoGrab Docs

업데이트 간 하위 호환성

요약

GitLab 배포 환경은 여러 컴포넌트로 나눌 수 있습니다. 어떤 의미에서 이 시나리오들은 모두 일시적인 상태입니다. 예를 들어 인수를 변경할 때는 다음을 확인합니다. Sidekiq 노드가 아직 업데이트되지 않아 이 job 들이 몇 시간 동안 실행되지 않아도 문제가 없는지 확인합니다.

GitLab 배포 환경은 여러 컴포넌트로 나눌 수 있습니다. GitLab 업데이트는 원자적으로 이루어지지 않습니다. 따라서 많은 컴포넌트가 하위 호환성을 유지해야 합니다.

자주 발생하는 문제#

어떤 의미에서 이 시나리오들은 모두 일시적인 상태입니다. 다만 운영 환경에서 몇 시간씩 이어지는 경우가 많습니다. 그러므로 영구적인 상태와 똑같이 신중하게 다뤄야 합니다.

Sidekiq 워커 수정 시#

예를 들어 인수를 변경할 때는 다음을 확인합니다.

  • 이전 시그니처로 job 이 큐에 추가되고 새 월간 릴리스에서 실행되어도 문제가 없는지 확인합니다.
  • 새 시그니처로 job 이 큐에 추가되고 이전 월간 릴리스에서 실행되어도 문제가 없는지 확인합니다.

새 Sidekiq 워커 추가 시#

Sidekiq 노드가 아직 업데이트되지 않아 이 job 들이 몇 시간 동안 실행되지 않아도 문제가 없는지 확인합니다.

JavaScript/Vue 수정 시#

Rails 코드 변경(Rails 컨트롤러, REST API, GraphQL API)이 이전 월간 릴리스에 머지되어 배포되었다면, JavaScript는 문제없이 그 Rails 코드에 요청을 보낼 수 있습니다.

Rails 코드 변경(Rails 컨트롤러, REST API, GraphQL API)이 아직 배포되지 않았다면, JavaScript는 그 Rails 코드에 요청을 보낼 수는 있지만 기본 비활성 기능 플래그 뒤에 두거나 실패를 우아하게 처리할 수 있어야 합니다. 예를 들어 18.3에 GraphQL 쿼리를 추가했다면 기능 플래그 없이 프론트엔드에서 그 쿼리를 사용하려면 18.4까지 기다려야 합니다.

기존 쿼리에 GraphQL 필드를 추가할 때는 @gl_introduced 디렉티브로 실패를 우아하게 처리할 수 있습니다. REST API에 필드를 추가할 때는 응답에 새 필드가 없으면 이전 필드로 폴백하는 방식으로 우아하게 처리할 수 있습니다.

사전 배포 마이그레이션 추가 시#

사전 배포 마이그레이션은 실행되었지만 웹, Sidekiq, API 노드가 이전 릴리스를 실행 중이어도 문제가 없는지 확인합니다.

사후 배포 마이그레이션 추가 시#

모든 GitLab 노드가 업데이트되었지만 사후 배포 마이그레이션이 며칠 뒤에야 실행되어도 문제가 없는지 확인합니다.

백그라운드 마이그레이션 추가 시#

모든 노드가 업데이트되고, 며칠 뒤 사후 배포 마이그레이션이 실행되며, 그 후 백그라운드 마이그레이션이 완료되는 데 일주일이 걸려도 문제가 없는지 확인합니다.

Rails 같은 의존성 업그레이드 시#

일부 노드는 새 Rails 버전을, 일부 노드는 이전 Rails 버전을 사용해도 문제가 없는지 확인합니다.

업데이트 과정 살펴보기#

업데이트 중에 발생하는 하위 호환성 문제는 매우 미묘한 경우가 많습니다. 그래서 다음 문서를 숙지해 두면 도움이 됩니다.

이러한 문제가 어떻게 발생하는지는 다음 예시에서 확인할 수 있습니다.

  • 🚢 새 버전
  • 🙂 이전 버전

이 예시는 월간 릴리스 하나만큼 업데이트하는 상황을 가정합니다. 다만 코드의 하위 호환성 유지 기간도 함께 참고합니다.

업데이트 단계 PostgreSQL DB 웹 노드 API 노드 Sidekiq 노드 호환성 우려 사항
초기 상태 🙂 🙂 🙂 🙂
사전 배포 마이그레이션 실행 🚢 (사후 배포 마이그레이션 제외) 🙂 🙂 🙂 🙂 의 Rails 코드가 🚢 에 DB 호출을 수행함
웹 노드 업데이트 🚢 (사후 배포 마이그레이션 제외) 🚢 🙂 🙂 🚢 의 JavaScript가 🙂 에 API 호출을 수행함. 🚢 의 Rails 코드가 🙂 의 Sidekiq 노드에서 실행되는 job을 큐에 추가함
API 및 Sidekiq 노드 업데이트 🚢 (사후 배포 마이그레이션 제외) 🚢 🚢 🚢 🚢 의 Rails 코드가 사후 배포 마이그레이션이나 백그라운드 마이그레이션 없이 DB 호출을 수행함
사후 배포 마이그레이션 실행 🚢 🚢 🚢 🚢 🚢 의 Rails 코드가 백그라운드 마이그레이션 없이 DB 호출을 수행함
백그라운드 마이그레이션 완료 🚢 🚢 🚢 🚢

이 예시가 전부는 아닙니다. GitLab은 매우 다양한 방식으로 배포될 수 있습니다. 각 업데이트 단계조차 원자적이지 않습니다. 예를 들어 롤링 배포에서는 한 그룹 안의 노드들이 일시적으로 서로 다른 버전을 사용합니다. 업데이트 단계 사이에 상당한 시간이 흐른다고 가정해야 합니다. GitLab.com에서는 실제로 그런 경우가 많습니다.

GitLab Next#

GitLab.com은 프로덕션에 배포될 다음 버전을 실행하는 카나리 스테이지를 운영합니다. 즉 상당 기간 동안 여러 버전의 GitLab을 함께 운영합니다.

다음 버전을 시험하기 위해 트래픽의 일부를 카나리로 라우팅합니다. 사용자는 GitLab Next에 직접 참여할 수도 있는데, 이 경우 gitlab_canary 쿠키가 true로 설정되어 카나리로 라우팅됩니다. 사용자 메뉴 토글(오른쪽 위 아바타)과 g x 키보드 단축키는 모두 이 쿠키를 .gitlab.com 도메인에 설정하므로 하위 도메인 전반에서 공유됩니다. next.gitlab.com을 방문해도 참여할 수 있지만, 이 사이트는 별도로 관리됩니다. 또한 gitlab-org 나 gitlab-com으로 시작하는 경로도 카나리로 라우팅되는데, 이 때문에 다중 버전 호환성 문제가 다수 드러나며 이 문제는 카나리의 버전이 프로덕션에 배포될 때까지 몇 시간 동안 이어질 수 있습니다.

이 문제는 API 요청의 경로 접두사가 같지 않아서 발생합니다. 그래서 더 새로운 카나리 프론트엔드 코드에서 보낸 API 요청이 더 오래된 메인 노드로 도달합니다.

GraphQL 요청에서 이런 상황이 발생하는 예시는 다음과 같습니다.

Mermaid 다이어그램 (5줄)
소스 코드 보기
sequenceDiagram
    Client browser->>Canary node: GET /gitlab-org/gitlab/-/issues/1
    Canary node-->>Client browser: HTML page with canary JS
    Client browser->>Main node: POST /api/graphql with query including newFieldAddedInCanary
    Main node-->>Client browser: Returns error due to unrecognized field

사용자는 카나리 쿠키를 설정해 두 요청 모두 카나리 노드로 가도록 하여 문제를 우회할 수 있습니다. 다만 이 우회책에 기댈 수는 없으므로 코드 자체가 하위 호환성을 갖춰야 합니다.

코드의 하위 호환성 유지 기간#

무중단 업데이트 안내를 따르는 사용자에게는 월간 릴리스 하나만큼입니다. 예를 들면 다음과 같습니다.

  • 13.11 => 13.12
  • 13.12 => 14.0
  • 14.0 => 14.1

GitLab.com에서는 하루에도 여러 번 소규모 버전 업데이트가 이루어지므로, GitLab.com은 변경 사항의 하위 호환성 범위를 제한하지 않습니다.

많은 사용자가 일부 월간 릴리스를 건너뜁니다. 예를 들면 다음과 같습니다.

  • 13.0 => 13.12

이러한 사용자는 업데이트 중 일부 다운타임을 감수합니다. 아쉽게도 이 경우를 완전히 무시할 수는 없습니다. 예를 들어 13.12가 13.0의 Sidekiq job을 실행할 수 있는데, 이는 메이저 릴리스 전까지 job의 인수를 제거하지 않는 이유를 보여 줍니다. 핵심 질문은 업데이트가 끝난 뒤 배포 환경이 정상 상태에 도달하는지입니다.

GitLab을 나눌 수 있는 컴포넌트#

1000 RPS 또는 사용자 50,000명 레퍼런스 아키텍처는 GitLab을 48개 이상의 노드에서 실행합니다. GitLab.com은 그보다 더 큽니다. 여기에 더해 인프라 일부는 Kubernetes에서 실행되며, 업데이트를 먼저 받는 "카나리" 스테이지도 있습니다.

다만 문제는 노드가 많다는 점만이 아닙니다. 더 큰 문제는 하나의 배포 환경이 서로 다른 컨텍스트로 나뉠 수 있다는 점입니다. 그리고 이렇게 하는 곳이 GitLab.com 만은 아닙니다. 다음과 같이 나눌 수 있습니다.

  • "카나리 웹 앱 노드": 일부 사용자의 비 API 요청을 처리합니다
  • "Git 앱 노드": Git 요청을 처리합니다
  • "웹 앱 노드": 웹 요청을 처리합니다
  • "API 앱 노드": API 요청을 처리합니다
  • "Sidekiq 앱 노드": Sidekiq job을 처리합니다
  • "PostgreSQL 데이터베이스": 내부 PostgreSQL 호출을 처리합니다
  • "Redis 데이터베이스": 내부 Redis 호출을 처리합니다
  • "Gitaly 노드": 내부 Gitaly 호출을 처리합니다

업데이트 중에는 서로 다른 컨텍스트에서 두 가지 버전의 GitLab 이 실행됩니다. 예를 들어 웹 노드가 큐에 추가한 job 이 이전 버전의 Sidekiq 노드에서 실행될 수 있습니다.

업데이트 단계 순서의 중요성#

순서는 중요합니다. 무중단 업데이트에 대한 구체적인 안내가 있는 이유는, 그래야 호환성 조합 일부를 고려하지 않아도 되기 때문입니다. Rails 코드가 이전 PostgreSQL 데이터베이스 스키마에 DB 호출을 하는 상황을 걱정하지 않아도 되는 이유도 여기에 있습니다.

잠재적 하위 호환성 문제를 발견했을 때의 대응#

조율#

Rails 나 Puma의 메이저·마이너 버전 업데이트에서는 다음과 같이 대응합니다.

  • Quality 팀을 참여시켜 MR을 충분히 테스트합니다.
  • 머지하기 전에 MR에서 @gitlab-org/release/managers에 알립니다.

기능 플래그#

기능 플래그는 하위 호환성 문제를 다루는 전략이 아니라 도구입니다.

예를 들어 프론트엔드와 API 변경이 모두 기본적으로 비활성화되어 있다면 프론트엔드와 API 변경이 포함된 새 기능을 추가해도 안전합니다. 이 작업은 여러 머지 리퀘스트로 나눠 어떤 순서로 머지해도 됩니다. 모든 변경이 GitLab.com에 배포된 뒤에 ChatOps에서 기능을 활성화하고 GitLab.com에서 검증하면 됩니다.

다만 기능을 기본값으로 활성화하는 것이 반드시 안전하지는 않습니다. 코드를 머지한 것과 같은 릴리스에서 기능 플래그를 제거하거나 기본값을 활성화로 바꾸면, 무중단 업데이트를 수행하는 고객은 새 프론트엔드 코드를 이전 릴리스의 API에 대고 실행하게 됩니다.

모든 변경을 한 번에 활성화해도 안전한지 확신할 수 없다면, 현재 릴리스에서는 API만 활성화하고 프론트엔드 변경은 다음 릴리스에서 활성화하는 방법이 있습니다. 이는 확장 및 축소 패턴의 한 예입니다.

또는 이전 릴리스의 API에 대해 프론트엔드가 우아하게 저하되도록 수정하면 릴리스를 미루지 않아도 됩니다.

우아한 저하#

예를 들어 프론트엔드와 API 변경이 포함된 새 기능을 추가할 때, 이전 API 응답에 대해서는 새 기능이 우아하게 저하되도록 프론트엔드를 작성할 수 있습니다. 이렇게 하면 변경을 세 개의 릴리스에 걸쳐 나눌 필요가 없어질 수 있습니다.

확장 및 축소 패턴#

온프레미스 인스턴스의 무중단 업데이트를 보장하는 한 가지 방법은 확장 및 축소 패턴을 따르는 것입니다.

즉 모든 호환성 파괴 변경을 확장, 마이그레이션, 축소의 세 단계로 나눕니다.

  1. 확장: 소프트웨어의 하위 호환성을 유지한 채로 호환성 파괴 변경을 도입합니다.
  2. 마이그레이션: 모든 소비자가 새 구현을 사용하도록 업데이트합니다.
  3. 축소: 하위 호환성을 제거합니다.

무중단 업데이트가 가능하도록 이 세 단계는 서로 다른 마일스톤에 속해야 합니다.

기능의 지원 수준에 따라 축소 단계는 다음 메이저 릴리스까지 미룰 수 있습니다.

확장 및 축소 예시#

라우트 변경, Sidekiq 워커 파라미터 변경, 데이터베이스 마이그레이션은 모두 호환성 파괴 변경의 대표적인 예입니다. 이러한 변경을 안전하게 처리하는 방법은 다음과 같습니다.

라우트 변경#

라우팅을 변경할 때는 새 버전에서 생성한 라우트를 이전 버전이 처리할 수 있고 그 반대도 가능한지 주의해서 확인해야 합니다. 예시에서 볼 수 있듯이 그렇게 하지 않으면 장애로 이어질 수 있습니다. 이런 유형의 변경은 두 구현 사이를 즉시 전환하는 것처럼 보일 수 있습니다. 다만 특히 카나리 스테이지가 있는 환경에서는 두 버전의 코드가 프로덕션에 함께 존재하는 기간이 길게 이어집니다.

  1. 확장: 기존 라우트와 같은 컨트롤러를 가리키는 새 라우트를 추가합니다. 다만 애플리케이션의 어느 곳에서도 새 라우트로 링크를 생성하지는 않습니다.
  2. 마이그레이션: 이제 전체 장비가 새 라우트를 인식할 수 있으므로 새 라우팅으로 링크를 생성합니다.
  3. 축소: 이전 라우트를 안전하게 제거합니다. (리포지터리 파일 링크처럼 이전 라우트가 널리 공유되었을 가능성이 크다면 리다이렉트를 추가하고 이전 라우트를 더 오래 유지할 수 있습니다.)

Sidekiq 워커 파라미터 변경#

이 주제는 업데이트 간 Sidekiq 호환성에서 자세히 설명합니다.

Sidekiq 워커 클래스에 새 파라미터를 추가해야 할 때는 다음 단계로 나눌 수 있습니다.

  1. 확장: 워커 클래스에 기본값을 가진 새 파라미터를 추가합니다.
  2. 마이그레이션: 워커를 호출하는 모든 지점에 새 파라미터를 추가합니다.
  3. 축소: 기본값을 제거합니다.

언뜻 보면 확장과 마이그레이션을 한 마일스톤에 묶어도 안전해 보이지만, Puma가 Sidekiq보다 먼저 재시작되면 장애가 발생합니다. Puma가 이전 Sidekiq 이 처리할 수 없는 추가 파라미터와 함께 job을 큐에 추가하기 때문입니다.

데이터베이스 마이그레이션#

다음 그래프는 배포를 단순화해 시각적으로 나타낸 것으로, 마이그레이션 전략에서 확장 및 축소가 어떻게 구현되는지 이해하는 데 도움이 됩니다.

여기에는 특별히 고려할 점이 있습니다. 사후 배포 마이그레이션 프레임워크를 사용하면 세 단계를 모두 한 마일스톤에 묶을 수 있습니다.

Mermaid 다이어그램 (24줄)
소스 코드 보기
gantt
  title Deployment
  dateFormat  HH:mm

section Deploy box Run migrations :done, migr, after schemaA, 2m Run post-deployment migrations :postmigr, after mcvn , 2m

section Database Schema A :done, schemaA, 00:00 , 1h Schema B :crit, schemaB, after migr, 58m Schema C. : schemaC, after postmigr, 1h

section Machine A Version N :done, mavn, 00:00 , 75m Version N+1 : after mavn, 105m

section Machine B Version N :done, mbvn, 00:00 , 105m Version N+1 : mbdone, after mbvn, 75m

section Machine C Version N :done, mcvn, 00:00 , 2h Version N+1 : mbcdone, after mcvn, 1h

이 스키마를 데이터베이스 관점에서 보면 두 번의 배포가 하나의 GitLab 배포로 이어집니다.

  1. Schema A에서 Schema B로
  2. Schema B에서 Schema C로

그리고 이 배포는 애플리케이션 변경과 정확히 맞물립니다.

  1. 처음에는 Schema A 위에서 Version N 이 동작합니다.
  2. 그다음에는 Schema B 위에서 Version N과 Version N+1 이 함께 동작하는 긴 전환 기간이 이어집니다.
  3. Schema B 위에 Version N+1만 남으면 스키마가 다시 변경됩니다.
  4. 마지막으로 Schema C 위에서 Version N+1 이 동작합니다.

이러한 세부 사항을 염두에 두고, 쿼리를 교체해야 하고 그 쿼리를 뒷받침하는 인덱스가 있는 상황을 가정해 봅니다.

  1. 확장: Schema A에서 Schema B로 가는 배포입니다. 새 인덱스를 추가하지만 애플리케이션은 아직 이를 사용하지 않습니다.
  2. 마이그레이션: Version N에서 Version N+1로 가는 애플리케이션 배포입니다. 새 코드가 배포되고, 이 시점부터는 새 쿼리만 실행됩니다.
  3. 축소: Schema B에서 Schema C로 가는 단계입니다(사후 배포 마이그레이션). 이제 이전 인덱스를 사용하는 곳이 없으므로 안전하게 제거할 수 있습니다.

이것은 하나의 예시일 뿐입니다. 더 복잡한 마이그레이션, 특히 백그라운드 마이그레이션이 필요한 경우에는 마일스톤이 하나 이상 필요할 수 있습니다. 자세한 내용은 마이그레이션 스타일 가이드를 참고합니다.

이전 인시던트 예시#

이슈 및 MR의 일부 링크가 끊어진 사례#

MR 라우트를 옮겼을 때 새 서버의 사용자는 새 URL로 리다이렉트되었습니다. 이 사용자들이 새 URL을 Markdown(또는 다른 곳)에 공유하자, 이전 서버의 사용자에게는 끊어진 링크가 되었습니다.

자세한 내용은 관련 이슈를 참고합니다.

이슈 또는 머지 리퀘스트 설명·댓글의 오래된 캐시#

Markdown 캐시 버전을 올린 뒤, 다른 Markdown 캐시 버전에서 생성된 설명이나 댓글을 사용자가 편집할 때 버그가 발생하는 것을 발견했습니다. 저장 후에도 캐시된 HTML 이 제대로 생성되지 않았습니다. 대부분의 경우에는 사용자가 Edit를 선택하기 전에 Markdown을 먼저 보게 되고 그 과정에서 Markdown 캐시가 갱신되므로 이런 일이 생기지 않았을 것입니다. 하지만 여러 버전을 함께 운영하기 때문에 발생 가능성이 더 큽니다. 다른 버전을 사용하는 다른 사용자가 같은 페이지를 열어 캐시를 그쪽 버전으로 갱신할 수 있기 때문입니다.

자세한 내용은 관련 이슈를 참고합니다.

프로젝트 서비스 템플릿이 잘못 복사된 사례#

서비스가 템플릿인지 여부를 나타내는 칼럼을 변경했습니다. 서비스를 생성할 때는 템플릿에서 속성을 복사하고 이 칼럼을 false로 설정합니다. 이전 서버는 여전히 이전 칼럼을 업데이트하고 있었지만, 이전 칼럼에서 새 칼럼을 갱신하는 DB 트리거가 있었기 때문에 문제가 없었습니다. 그런데 새 서버는 새 칼럼만 업데이트했고, 바로 그 트리거가 이번에는 반대로 작동해 값을 다시 잘못된 값으로 되돌렸습니다.

자세한 내용은 관련 이슈를 참고합니다.

일부 사용자에게 사이드바가 로드되지 않은 사례#

GraphQL 필드 하나의 데이터 유형을 변경했습니다. 사용자가 새 서버에서 이슈 페이지를 열었는데 GraphQL AJAX 요청이 이전 서버로 전달되면서 유형 불일치가 발생했고, 그 결과 JavaScript 오류가 나면서 사이드바가 로드되지 않았습니다.

자세한 내용은 관련 이슈를 참고합니다.

CI 아티팩트 업로드가 실패한 사례#

칼럼에 NOT NULL 제약을 추가하면서 기존 행에는 적용되지 않도록 NOT VALID 제약으로 표시했습니다. 그럼에도 이전 서버가 여전히 null 값으로 새 행을 삽입하고 있었기 때문에 문제가 되었습니다.

자세한 내용은 관련 이슈를 참고합니다.

카나리 배포와 프로덕션 배포 사이에서 릴리스 기능에 발생한 다운타임#

문제를 해결하기 위해 기존 테이블에 기본값을 지정하지 않은 채 NOT NULL 제약이 있는 새 칼럼을 추가했습니다. 다시 말해 애플리케이션이 그 칼럼에 값을 설정해야 했습니다.

이전 버전의 애플리케이션은 해당 엔터티·개념이 이전에는 없었기 때문에 NOT NULL 제약에 맞는 값을 설정하지 않았습니다.

문제는 카나리 배포가 끝난 직후부터 시작되었습니다. 그 시점에는 (칼럼을 추가하는) 데이터베이스 마이그레이션이 정상적으로 실행되었고 카나리 인스턴스가 새 애플리케이션 코드를 사용하기 시작했으므로 QA는 성공했습니다. 그런데 프로덕션 인스턴스는 여전히 이전 코드를 사용하고 있었기 때문에 새 릴리스 항목 삽입에 실패하기 시작했습니다.

자세한 내용은 Releases API와 관련된 이 이슈를 참고합니다.

노드 유형별 배포 시간 차이로 빌드가 실패한 사례#

한 프로덕션 이슈에서는 parallel 키워드를 사용하고 변수 CI_NODE_TOTAL 이 정수라는 점에 의존하는 CI 빌드가 실패했습니다. 사용자가 커밋을 푸시한 뒤 다음과 같은 일이 벌어졌기 때문입니다.

  1. 새 코드: Sidekiq 이 새 파이프라인과 새 빌드를 생성했습니다. build.options[:parallel]은 Hash 입니다.
  2. 이전 코드: 러너가 이전 버전을 실행 중인 API 노드에 job을 요청했습니다.
  3. 그 결과 새 코드 가 API 서버에서 실행되지 않았습니다. 이전 API 서버가 CI_NODE_TOTAL CI/CD 변수를 반환하려 했지만 정수 값(예를 들어 9) 대신 직렬화된 Hash 값({:number=>9, :total=>9})을 보냈기 때문에 러너의 요청이 실패했습니다.

배포 파이프라인을 보면 모든 노드가 병렬로 업데이트된 것을 확인할 수 있습니다.
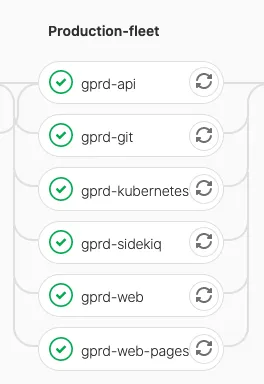
GitLab.com 배포 파이프라인

다만 업데이트가 거의 같은 시각에 시작되었는데도 완료 시각은 크게 달랐습니다.

노드 유형 소요 시간 (분)
API 54
Sidekiq 21
K8S 8

parallel 키워드를 사용하면서 CI_NODE_TOTAL과 CI_NODE_INDEX에 의존하는 빌드는 Sidekiq 이 업데이트된 이후 구간에서 실패했습니다. Kubernetes(K8S)도 Sidekiq Pod를 실행하므로 이 구간은 길게는 46분, 짧게는 33분이었을 수 있습니다. 어느 쪽이든 배포가 끝난 뒤에 켤 수 있는 기능 플래그가 있었다면 이 문제를 막을 수 있었습니다.

업데이트 간 하위 호환성

GitLab v19.4
원문 보기

요약

GitLab 배포 환경은 여러 컴포넌트로 나눌 수 있습니다. 어떤 의미에서 이 시나리오들은 모두 일시적인 상태입니다. 예를 들어 인수를 변경할 때는 다음을 확인합니다. Sidekiq 노드가 아직 업데이트되지 않아 이 job 들이 몇 시간 동안 실행되지 않아도 문제가 없는지 확인합니다.

GitLab 배포 환경은 여러 컴포넌트로 나눌 수 있습니다. GitLab 업데이트는 원자적으로 이루어지지 않습니다. 따라서 많은 컴포넌트가 하위 호환성을 유지해야 합니다.

자주 발생하는 문제#

어떤 의미에서 이 시나리오들은 모두 일시적인 상태입니다. 다만 운영 환경에서 몇 시간씩 이어지는 경우가 많습니다. 그러므로 영구적인 상태와 똑같이 신중하게 다뤄야 합니다.

Sidekiq 워커 수정 시#

예를 들어 인수를 변경할 때는 다음을 확인합니다.

  • 이전 시그니처로 job 이 큐에 추가되고 새 월간 릴리스에서 실행되어도 문제가 없는지 확인합니다.
  • 새 시그니처로 job 이 큐에 추가되고 이전 월간 릴리스에서 실행되어도 문제가 없는지 확인합니다.

새 Sidekiq 워커 추가 시#

Sidekiq 노드가 아직 업데이트되지 않아 이 job 들이 몇 시간 동안 실행되지 않아도 문제가 없는지 확인합니다.

JavaScript/Vue 수정 시#

Rails 코드 변경(Rails 컨트롤러, REST API, GraphQL API)이 이전 월간 릴리스에 머지되어 배포되었다면, JavaScript는 문제없이 그 Rails 코드에 요청을 보낼 수 있습니다.

Rails 코드 변경(Rails 컨트롤러, REST API, GraphQL API)이 아직 배포되지 않았다면, JavaScript는 그 Rails 코드에 요청을 보낼 수는 있지만 기본 비활성 기능 플래그 뒤에 두거나 실패를 우아하게 처리할 수 있어야 합니다. 예를 들어 18.3에 GraphQL 쿼리를 추가했다면 기능 플래그 없이 프론트엔드에서 그 쿼리를 사용하려면 18.4까지 기다려야 합니다.

기존 쿼리에 GraphQL 필드를 추가할 때는 @gl_introduced 디렉티브로 실패를 우아하게 처리할 수 있습니다. REST API에 필드를 추가할 때는 응답에 새 필드가 없으면 이전 필드로 폴백하는 방식으로 우아하게 처리할 수 있습니다.

사전 배포 마이그레이션 추가 시#

사전 배포 마이그레이션은 실행되었지만 웹, Sidekiq, API 노드가 이전 릴리스를 실행 중이어도 문제가 없는지 확인합니다.

사후 배포 마이그레이션 추가 시#

모든 GitLab 노드가 업데이트되었지만 사후 배포 마이그레이션이 며칠 뒤에야 실행되어도 문제가 없는지 확인합니다.

백그라운드 마이그레이션 추가 시#

모든 노드가 업데이트되고, 며칠 뒤 사후 배포 마이그레이션이 실행되며, 그 후 백그라운드 마이그레이션이 완료되는 데 일주일이 걸려도 문제가 없는지 확인합니다.

Rails 같은 의존성 업그레이드 시#

일부 노드는 새 Rails 버전을, 일부 노드는 이전 Rails 버전을 사용해도 문제가 없는지 확인합니다.

업데이트 과정 살펴보기#

업데이트 중에 발생하는 하위 호환성 문제는 매우 미묘한 경우가 많습니다. 그래서 다음 문서를 숙지해 두면 도움이 됩니다.

이러한 문제가 어떻게 발생하는지는 다음 예시에서 확인할 수 있습니다.

  • 🚢 새 버전
  • 🙂 이전 버전

이 예시는 월간 릴리스 하나만큼 업데이트하는 상황을 가정합니다. 다만 코드의 하위 호환성 유지 기간도 함께 참고합니다.

업데이트 단계 PostgreSQL DB 웹 노드 API 노드 Sidekiq 노드 호환성 우려 사항
초기 상태 🙂 🙂 🙂 🙂
사전 배포 마이그레이션 실행 🚢 (사후 배포 마이그레이션 제외) 🙂 🙂 🙂 🙂 의 Rails 코드가 🚢 에 DB 호출을 수행함
웹 노드 업데이트 🚢 (사후 배포 마이그레이션 제외) 🚢 🙂 🙂 🚢 의 JavaScript가 🙂 에 API 호출을 수행함. 🚢 의 Rails 코드가 🙂 의 Sidekiq 노드에서 실행되는 job을 큐에 추가함
API 및 Sidekiq 노드 업데이트 🚢 (사후 배포 마이그레이션 제외) 🚢 🚢 🚢 🚢 의 Rails 코드가 사후 배포 마이그레이션이나 백그라운드 마이그레이션 없이 DB 호출을 수행함
사후 배포 마이그레이션 실행 🚢 🚢 🚢 🚢 🚢 의 Rails 코드가 백그라운드 마이그레이션 없이 DB 호출을 수행함
백그라운드 마이그레이션 완료 🚢 🚢 🚢 🚢

이 예시가 전부는 아닙니다. GitLab은 매우 다양한 방식으로 배포될 수 있습니다. 각 업데이트 단계조차 원자적이지 않습니다. 예를 들어 롤링 배포에서는 한 그룹 안의 노드들이 일시적으로 서로 다른 버전을 사용합니다. 업데이트 단계 사이에 상당한 시간이 흐른다고 가정해야 합니다. GitLab.com에서는 실제로 그런 경우가 많습니다.

GitLab Next#

GitLab.com은 프로덕션에 배포될 다음 버전을 실행하는 카나리 스테이지를 운영합니다. 즉 상당 기간 동안 여러 버전의 GitLab을 함께 운영합니다.

다음 버전을 시험하기 위해 트래픽의 일부를 카나리로 라우팅합니다. 사용자는 GitLab Next에 직접 참여할 수도 있는데, 이 경우 gitlab_canary 쿠키가 true로 설정되어 카나리로 라우팅됩니다. 사용자 메뉴 토글(오른쪽 위 아바타)과 g x 키보드 단축키는 모두 이 쿠키를 .gitlab.com 도메인에 설정하므로 하위 도메인 전반에서 공유됩니다. next.gitlab.com을 방문해도 참여할 수 있지만, 이 사이트는 별도로 관리됩니다. 또한 gitlab-org 나 gitlab-com으로 시작하는 경로도 카나리로 라우팅되는데, 이 때문에 다중 버전 호환성 문제가 다수 드러나며 이 문제는 카나리의 버전이 프로덕션에 배포될 때까지 몇 시간 동안 이어질 수 있습니다.

이 문제는 API 요청의 경로 접두사가 같지 않아서 발생합니다. 그래서 더 새로운 카나리 프론트엔드 코드에서 보낸 API 요청이 더 오래된 메인 노드로 도달합니다.

GraphQL 요청에서 이런 상황이 발생하는 예시는 다음과 같습니다.

Mermaid 다이어그램 (5줄)
소스 코드 보기
sequenceDiagram
    Client browser->>Canary node: GET /gitlab-org/gitlab/-/issues/1
    Canary node-->>Client browser: HTML page with canary JS
    Client browser->>Main node: POST /api/graphql with query including newFieldAddedInCanary
    Main node-->>Client browser: Returns error due to unrecognized field

사용자는 카나리 쿠키를 설정해 두 요청 모두 카나리 노드로 가도록 하여 문제를 우회할 수 있습니다. 다만 이 우회책에 기댈 수는 없으므로 코드 자체가 하위 호환성을 갖춰야 합니다.

코드의 하위 호환성 유지 기간#

무중단 업데이트 안내를 따르는 사용자에게는 월간 릴리스 하나만큼입니다. 예를 들면 다음과 같습니다.

  • 13.11 => 13.12
  • 13.12 => 14.0
  • 14.0 => 14.1

GitLab.com에서는 하루에도 여러 번 소규모 버전 업데이트가 이루어지므로, GitLab.com은 변경 사항의 하위 호환성 범위를 제한하지 않습니다.

많은 사용자가 일부 월간 릴리스를 건너뜁니다. 예를 들면 다음과 같습니다.

  • 13.0 => 13.12

이러한 사용자는 업데이트 중 일부 다운타임을 감수합니다. 아쉽게도 이 경우를 완전히 무시할 수는 없습니다. 예를 들어 13.12가 13.0의 Sidekiq job을 실행할 수 있는데, 이는 메이저 릴리스 전까지 job의 인수를 제거하지 않는 이유를 보여 줍니다. 핵심 질문은 업데이트가 끝난 뒤 배포 환경이 정상 상태에 도달하는지입니다.

GitLab을 나눌 수 있는 컴포넌트#

1000 RPS 또는 사용자 50,000명 레퍼런스 아키텍처는 GitLab을 48개 이상의 노드에서 실행합니다. GitLab.com은 그보다 더 큽니다. 여기에 더해 인프라 일부는 Kubernetes에서 실행되며, 업데이트를 먼저 받는 "카나리" 스테이지도 있습니다.

다만 문제는 노드가 많다는 점만이 아닙니다. 더 큰 문제는 하나의 배포 환경이 서로 다른 컨텍스트로 나뉠 수 있다는 점입니다. 그리고 이렇게 하는 곳이 GitLab.com 만은 아닙니다. 다음과 같이 나눌 수 있습니다.

  • "카나리 웹 앱 노드": 일부 사용자의 비 API 요청을 처리합니다
  • "Git 앱 노드": Git 요청을 처리합니다
  • "웹 앱 노드": 웹 요청을 처리합니다
  • "API 앱 노드": API 요청을 처리합니다
  • "Sidekiq 앱 노드": Sidekiq job을 처리합니다
  • "PostgreSQL 데이터베이스": 내부 PostgreSQL 호출을 처리합니다
  • "Redis 데이터베이스": 내부 Redis 호출을 처리합니다
  • "Gitaly 노드": 내부 Gitaly 호출을 처리합니다

업데이트 중에는 서로 다른 컨텍스트에서 두 가지 버전의 GitLab 이 실행됩니다. 예를 들어 웹 노드가 큐에 추가한 job 이 이전 버전의 Sidekiq 노드에서 실행될 수 있습니다.

업데이트 단계 순서의 중요성#

순서는 중요합니다. 무중단 업데이트에 대한 구체적인 안내가 있는 이유는, 그래야 호환성 조합 일부를 고려하지 않아도 되기 때문입니다. Rails 코드가 이전 PostgreSQL 데이터베이스 스키마에 DB 호출을 하는 상황을 걱정하지 않아도 되는 이유도 여기에 있습니다.

잠재적 하위 호환성 문제를 발견했을 때의 대응#

조율#

Rails 나 Puma의 메이저·마이너 버전 업데이트에서는 다음과 같이 대응합니다.

  • Quality 팀을 참여시켜 MR을 충분히 테스트합니다.
  • 머지하기 전에 MR에서 @gitlab-org/release/managers에 알립니다.

기능 플래그#

기능 플래그는 하위 호환성 문제를 다루는 전략이 아니라 도구입니다.

예를 들어 프론트엔드와 API 변경이 모두 기본적으로 비활성화되어 있다면 프론트엔드와 API 변경이 포함된 새 기능을 추가해도 안전합니다. 이 작업은 여러 머지 리퀘스트로 나눠 어떤 순서로 머지해도 됩니다. 모든 변경이 GitLab.com에 배포된 뒤에 ChatOps에서 기능을 활성화하고 GitLab.com에서 검증하면 됩니다.

다만 기능을 기본값으로 활성화하는 것이 반드시 안전하지는 않습니다. 코드를 머지한 것과 같은 릴리스에서 기능 플래그를 제거하거나 기본값을 활성화로 바꾸면, 무중단 업데이트를 수행하는 고객은 새 프론트엔드 코드를 이전 릴리스의 API에 대고 실행하게 됩니다.

모든 변경을 한 번에 활성화해도 안전한지 확신할 수 없다면, 현재 릴리스에서는 API만 활성화하고 프론트엔드 변경은 다음 릴리스에서 활성화하는 방법이 있습니다. 이는 확장 및 축소 패턴의 한 예입니다.

또는 이전 릴리스의 API에 대해 프론트엔드가 우아하게 저하되도록 수정하면 릴리스를 미루지 않아도 됩니다.

우아한 저하#

예를 들어 프론트엔드와 API 변경이 포함된 새 기능을 추가할 때, 이전 API 응답에 대해서는 새 기능이 우아하게 저하되도록 프론트엔드를 작성할 수 있습니다. 이렇게 하면 변경을 세 개의 릴리스에 걸쳐 나눌 필요가 없어질 수 있습니다.

확장 및 축소 패턴#

온프레미스 인스턴스의 무중단 업데이트를 보장하는 한 가지 방법은 확장 및 축소 패턴을 따르는 것입니다.

즉 모든 호환성 파괴 변경을 확장, 마이그레이션, 축소의 세 단계로 나눕니다.

  1. 확장: 소프트웨어의 하위 호환성을 유지한 채로 호환성 파괴 변경을 도입합니다.
  2. 마이그레이션: 모든 소비자가 새 구현을 사용하도록 업데이트합니다.
  3. 축소: 하위 호환성을 제거합니다.

무중단 업데이트가 가능하도록 이 세 단계는 서로 다른 마일스톤에 속해야 합니다.

기능의 지원 수준에 따라 축소 단계는 다음 메이저 릴리스까지 미룰 수 있습니다.

확장 및 축소 예시#

라우트 변경, Sidekiq 워커 파라미터 변경, 데이터베이스 마이그레이션은 모두 호환성 파괴 변경의 대표적인 예입니다. 이러한 변경을 안전하게 처리하는 방법은 다음과 같습니다.

라우트 변경#

라우팅을 변경할 때는 새 버전에서 생성한 라우트를 이전 버전이 처리할 수 있고 그 반대도 가능한지 주의해서 확인해야 합니다. 예시에서 볼 수 있듯이 그렇게 하지 않으면 장애로 이어질 수 있습니다. 이런 유형의 변경은 두 구현 사이를 즉시 전환하는 것처럼 보일 수 있습니다. 다만 특히 카나리 스테이지가 있는 환경에서는 두 버전의 코드가 프로덕션에 함께 존재하는 기간이 길게 이어집니다.

  1. 확장: 기존 라우트와 같은 컨트롤러를 가리키는 새 라우트를 추가합니다. 다만 애플리케이션의 어느 곳에서도 새 라우트로 링크를 생성하지는 않습니다.
  2. 마이그레이션: 이제 전체 장비가 새 라우트를 인식할 수 있으므로 새 라우팅으로 링크를 생성합니다.
  3. 축소: 이전 라우트를 안전하게 제거합니다. (리포지터리 파일 링크처럼 이전 라우트가 널리 공유되었을 가능성이 크다면 리다이렉트를 추가하고 이전 라우트를 더 오래 유지할 수 있습니다.)

Sidekiq 워커 파라미터 변경#

이 주제는 업데이트 간 Sidekiq 호환성에서 자세히 설명합니다.

Sidekiq 워커 클래스에 새 파라미터를 추가해야 할 때는 다음 단계로 나눌 수 있습니다.

  1. 확장: 워커 클래스에 기본값을 가진 새 파라미터를 추가합니다.
  2. 마이그레이션: 워커를 호출하는 모든 지점에 새 파라미터를 추가합니다.
  3. 축소: 기본값을 제거합니다.

언뜻 보면 확장과 마이그레이션을 한 마일스톤에 묶어도 안전해 보이지만, Puma가 Sidekiq보다 먼저 재시작되면 장애가 발생합니다. Puma가 이전 Sidekiq 이 처리할 수 없는 추가 파라미터와 함께 job을 큐에 추가하기 때문입니다.

데이터베이스 마이그레이션#

다음 그래프는 배포를 단순화해 시각적으로 나타낸 것으로, 마이그레이션 전략에서 확장 및 축소가 어떻게 구현되는지 이해하는 데 도움이 됩니다.

여기에는 특별히 고려할 점이 있습니다. 사후 배포 마이그레이션 프레임워크를 사용하면 세 단계를 모두 한 마일스톤에 묶을 수 있습니다.

Mermaid 다이어그램 (24줄)
소스 코드 보기
gantt
  title Deployment
  dateFormat  HH:mm

section Deploy box Run migrations :done, migr, after schemaA, 2m Run post-deployment migrations :postmigr, after mcvn , 2m

section Database Schema A :done, schemaA, 00:00 , 1h Schema B :crit, schemaB, after migr, 58m Schema C. : schemaC, after postmigr, 1h

section Machine A Version N :done, mavn, 00:00 , 75m Version N+1 : after mavn, 105m

section Machine B Version N :done, mbvn, 00:00 , 105m Version N+1 : mbdone, after mbvn, 75m

section Machine C Version N :done, mcvn, 00:00 , 2h Version N+1 : mbcdone, after mcvn, 1h

이 스키마를 데이터베이스 관점에서 보면 두 번의 배포가 하나의 GitLab 배포로 이어집니다.

  1. Schema A에서 Schema B로
  2. Schema B에서 Schema C로

그리고 이 배포는 애플리케이션 변경과 정확히 맞물립니다.

  1. 처음에는 Schema A 위에서 Version N 이 동작합니다.
  2. 그다음에는 Schema B 위에서 Version N과 Version N+1 이 함께 동작하는 긴 전환 기간이 이어집니다.
  3. Schema B 위에 Version N+1만 남으면 스키마가 다시 변경됩니다.
  4. 마지막으로 Schema C 위에서 Version N+1 이 동작합니다.

이러한 세부 사항을 염두에 두고, 쿼리를 교체해야 하고 그 쿼리를 뒷받침하는 인덱스가 있는 상황을 가정해 봅니다.

  1. 확장: Schema A에서 Schema B로 가는 배포입니다. 새 인덱스를 추가하지만 애플리케이션은 아직 이를 사용하지 않습니다.
  2. 마이그레이션: Version N에서 Version N+1로 가는 애플리케이션 배포입니다. 새 코드가 배포되고, 이 시점부터는 새 쿼리만 실행됩니다.
  3. 축소: Schema B에서 Schema C로 가는 단계입니다(사후 배포 마이그레이션). 이제 이전 인덱스를 사용하는 곳이 없으므로 안전하게 제거할 수 있습니다.

이것은 하나의 예시일 뿐입니다. 더 복잡한 마이그레이션, 특히 백그라운드 마이그레이션이 필요한 경우에는 마일스톤이 하나 이상 필요할 수 있습니다. 자세한 내용은 마이그레이션 스타일 가이드를 참고합니다.

이전 인시던트 예시#

이슈 및 MR의 일부 링크가 끊어진 사례#

MR 라우트를 옮겼을 때 새 서버의 사용자는 새 URL로 리다이렉트되었습니다. 이 사용자들이 새 URL을 Markdown(또는 다른 곳)에 공유하자, 이전 서버의 사용자에게는 끊어진 링크가 되었습니다.

자세한 내용은 관련 이슈를 참고합니다.

이슈 또는 머지 리퀘스트 설명·댓글의 오래된 캐시#

Markdown 캐시 버전을 올린 뒤, 다른 Markdown 캐시 버전에서 생성된 설명이나 댓글을 사용자가 편집할 때 버그가 발생하는 것을 발견했습니다. 저장 후에도 캐시된 HTML 이 제대로 생성되지 않았습니다. 대부분의 경우에는 사용자가 Edit를 선택하기 전에 Markdown을 먼저 보게 되고 그 과정에서 Markdown 캐시가 갱신되므로 이런 일이 생기지 않았을 것입니다. 하지만 여러 버전을 함께 운영하기 때문에 발생 가능성이 더 큽니다. 다른 버전을 사용하는 다른 사용자가 같은 페이지를 열어 캐시를 그쪽 버전으로 갱신할 수 있기 때문입니다.

자세한 내용은 관련 이슈를 참고합니다.

프로젝트 서비스 템플릿이 잘못 복사된 사례#

서비스가 템플릿인지 여부를 나타내는 칼럼을 변경했습니다. 서비스를 생성할 때는 템플릿에서 속성을 복사하고 이 칼럼을 false로 설정합니다. 이전 서버는 여전히 이전 칼럼을 업데이트하고 있었지만, 이전 칼럼에서 새 칼럼을 갱신하는 DB 트리거가 있었기 때문에 문제가 없었습니다. 그런데 새 서버는 새 칼럼만 업데이트했고, 바로 그 트리거가 이번에는 반대로 작동해 값을 다시 잘못된 값으로 되돌렸습니다.

자세한 내용은 관련 이슈를 참고합니다.

일부 사용자에게 사이드바가 로드되지 않은 사례#

GraphQL 필드 하나의 데이터 유형을 변경했습니다. 사용자가 새 서버에서 이슈 페이지를 열었는데 GraphQL AJAX 요청이 이전 서버로 전달되면서 유형 불일치가 발생했고, 그 결과 JavaScript 오류가 나면서 사이드바가 로드되지 않았습니다.

자세한 내용은 관련 이슈를 참고합니다.

CI 아티팩트 업로드가 실패한 사례#

칼럼에 NOT NULL 제약을 추가하면서 기존 행에는 적용되지 않도록 NOT VALID 제약으로 표시했습니다. 그럼에도 이전 서버가 여전히 null 값으로 새 행을 삽입하고 있었기 때문에 문제가 되었습니다.

자세한 내용은 관련 이슈를 참고합니다.

카나리 배포와 프로덕션 배포 사이에서 릴리스 기능에 발생한 다운타임#

문제를 해결하기 위해 기존 테이블에 기본값을 지정하지 않은 채 NOT NULL 제약이 있는 새 칼럼을 추가했습니다. 다시 말해 애플리케이션이 그 칼럼에 값을 설정해야 했습니다.

이전 버전의 애플리케이션은 해당 엔터티·개념이 이전에는 없었기 때문에 NOT NULL 제약에 맞는 값을 설정하지 않았습니다.

문제는 카나리 배포가 끝난 직후부터 시작되었습니다. 그 시점에는 (칼럼을 추가하는) 데이터베이스 마이그레이션이 정상적으로 실행되었고 카나리 인스턴스가 새 애플리케이션 코드를 사용하기 시작했으므로 QA는 성공했습니다. 그런데 프로덕션 인스턴스는 여전히 이전 코드를 사용하고 있었기 때문에 새 릴리스 항목 삽입에 실패하기 시작했습니다.

자세한 내용은 Releases API와 관련된 이 이슈를 참고합니다.

노드 유형별 배포 시간 차이로 빌드가 실패한 사례#

한 프로덕션 이슈에서는 parallel 키워드를 사용하고 변수 CI_NODE_TOTAL 이 정수라는 점에 의존하는 CI 빌드가 실패했습니다. 사용자가 커밋을 푸시한 뒤 다음과 같은 일이 벌어졌기 때문입니다.

  1. 새 코드: Sidekiq 이 새 파이프라인과 새 빌드를 생성했습니다. build.options[:parallel]은 Hash 입니다.
  2. 이전 코드: 러너가 이전 버전을 실행 중인 API 노드에 job을 요청했습니다.
  3. 그 결과 새 코드 가 API 서버에서 실행되지 않았습니다. 이전 API 서버가 CI_NODE_TOTAL CI/CD 변수를 반환하려 했지만 정수 값(예를 들어 9) 대신 직렬화된 Hash 값({:number=>9, :total=>9})을 보냈기 때문에 러너의 요청이 실패했습니다.

배포 파이프라인을 보면 모든 노드가 병렬로 업데이트된 것을 확인할 수 있습니다.

GitLab.com 배포 파이프라인

다만 업데이트가 거의 같은 시각에 시작되었는데도 완료 시각은 크게 달랐습니다.

노드 유형 소요 시간 (분)
API 54
Sidekiq 21
K8S 8

parallel 키워드를 사용하면서 CI_NODE_TOTAL과 CI_NODE_INDEX에 의존하는 빌드는 Sidekiq 이 업데이트된 이후 구간에서 실패했습니다. Kubernetes(K8S)도 Sidekiq Pod를 실행하므로 이 구간은 길게는 46분, 짧게는 33분이었을 수 있습니다. 어느 쪽이든 배포가 끝난 뒤에 켤 수 있는 기능 플래그가 있었다면 이 문제를 막을 수 있었습니다.