InfoGrab DocsInfoGrab Docs

샤딩 가이드라인

요약

샤딩 이니셔티브는 대부분의 GitLab 데이터베이스 테이블을 직접 또는 간접적으로 Organization에 연결할 수 있도록 만드는 장기 프로젝트입니다. 다음 gitlab_schema를 가진 모든 테이블은 organization 레벨로 간주됩니다:

샤딩 이니셔티브는 대부분의 GitLab 데이터베이스 테이블을 직접 또는 간접적으로 Organization에 연결할 수 있도록 만드는 장기 프로젝트입니다. 이 작업에는 테이블에 organization_id, namespace_id, project_id 칼럼을 추가하고 NOT NULL 폴백 데이터를 백필하는 일이 포함됩니다. 이 작업은 Cells와 Organizations를 제공하는 데 중요합니다. 자세한 내용은 Organizations의 설계 목표를 참고합니다.

샤딩 원칙#

다음 gitlab_schema를 가진 모든 테이블은 organization 레벨로 간주됩니다:

  • gitlab_main_org
  • gitlab_ci
  • gitlab_sec
  • gitlab_main_user
  • gitlab_shared_org

그 외의 모든 테이블은 cell 로컬로 간주됩니다. cell 로컬 테이블의 데이터는 cell 사이에서 마이그레이션되지 않으므로 샤딩 키를 두면 안 됩니다.

새로 생성되는 organization 레벨 테이블은 모두 해당 테이블의 db/docs/ 파일에 sharding_key가 정의되어 있어야 합니다.

샤딩 키의 목적은 Organization isolation blueprint에 문서화되어 있지만, 간단히 말하면 이 칼럼은 데이터베이스의 특정 행을 어느 Organization이 소유하는지 판단하는 표준 방법을 제공하는 데 사용됩니다.

올바른 샤딩 키 선택#

모든 행에는 샤딩 키가 정확히 1개 있어야 하며, 가능한 한 구체적이어야 합니다. 대형 테이블에는 예외를 둘 수 없습니다.

외래 키의 실제 이름은 무엇이든 될 수 있지만 projects 또는 namespaces의 행을 참조해야 합니다.

유효한 샤딩 키의 예시는 다음과 같습니다:

  • 테이블 항목이 프로젝트에만 속하는 경우:

    sharding_key:
      project_id: projects
    
  • 테이블 항목이 프로젝트에 속하고 외래 키가 target_project_id인 경우:

    sharding_key:
      target_project_id: projects
    
  • 테이블 항목이 네임스페이스/그룹에만 속하는 경우:

    sharding_key:
      namespace_id: namespaces
    
  • 테이블 항목이 네임스페이스/그룹에만 속하고 외래 키가 group_id인 경우:

    sharding_key:
      group_id: namespaces
    
  • (gitlab_main_user에만 해당) 테이블 항목이 사용자에게만 속하는 경우:

    sharding_key:
      user_id: users
    

샤딩 키는 null을 허용하지 않아야 합니다#

선택한 sharding_key는 null을 허용하지 않아야 합니다. 각 행을 일관되게 organization에 귀속시킬 수 있어야 하고, organization을 다른 cell로 마이그레이션한 후 데이터를 잃지 않아야 합니다.

또한 Org Mover의 행 필터링을 설정하려면 REPLICA IDENTITY에 샤딩 키 칼럼이 포함되어야 합니다. 이 REPLICA IDENTITY에는 null이 아닌 칼럼만 포함해야 합니다.

여러 개의 샤딩 키 칼럼#

테이블이 서로 다른 여러 상위 엔터티에 속할 수 있는 드문 경우(예: 프로젝트와 네임스페이스 양쪽)에는 sharding_key를 여러 칼럼으로 정의할 수 있습니다. 이는 테이블의 한 행에서 샤딩 키 칼럼 중 정확히 하나만 null이 아니어야 한다는 점을 올바르게 보장하는 검사 제약 조건이 테이블에 있는 경우에만 허용됩니다. 이러한 제약 조건을 만드는 방법은 여러 칼럼에 대한 NOT NULL 제약 조건을 참고합니다.

  • 테이블 항목이 네임스페이스 또는 프로젝트에 속하는 경우:

    sharding_key:
      project_id: projects
      namespace_id: namespaces
    

예를 들어:

  • cell 사이에서 organization을 이동하려면 모든 테이블의 모든 행에 organization_id가 필요합니다.
  • 그러나 실제로는 최상위 그룹(또는 그 하위 그룹이나 프로젝트)이 소유하는 행에 organization_id를 두면 (organization_id 재작성 때문에) 최상위 그룹 전송이 비효율적이어서 실용성이 없어집니다.
  • 절충안: 모든 테이블의 모든 행에 organization_id 또는 namespace_id를 추가합니다.
  • 그러나 실제로는 프로젝트가 소유하는 테이블의 행에 namespace_id를 두면 (namespace_id 재작성 때문에) 프로젝트 전송(및 일부 하위 그룹 전송)이 비효율적이어서 실용성이 없어집니다.
  • 절충안: 모든 테이블의 모든 행에 organization_id, namespace_id, project_id 중 가장 구체적인 것을 추가합니다.
Warning

샤딩 키 칼럼이 여러 개인 테이블은 cell 사이의 효율적인 데이터 마이그레이션과 격리를 지원하기 위해 향후 별도의 테이블로 분리해야 할 수 있습니다. 꼭 필요한 경우가 아니라면 샤딩 키 칼럼이 여러 개인 새 테이블은 설계하지 않습니다.

샤딩 키는 변경 불가능해야 합니다#

sharding_key는 항상 변경 불가능한 것을 선택해야 합니다. 샤딩 키 칼럼이 계획 중인 Org Mover의 인덱스로 사용되고, organization 데이터의 격리 시행에도 사용되기 때문입니다. sharding_key를 변경하면 일관성 없는 데이터를 읽게 될 수 있습니다.

따라서 기능이 프로젝트 사이 또는 그룹/네임스페이스 사이로 데이터를 옮길 수 있는 사용자 경험을 요구한다면, 새 행을 만드는 방식으로 이동 기능을 다시 설계해야 할 수도 있습니다. 그 예는 이슈 이동 기능에서 볼 수 있습니다. 이 기능은 기존 issues 행의 project_id 칼럼을 실제로 바꾸지 않고 새 issues 행을 만들고 원래 issues 행에서 이어지는 링크를 데이터베이스에 만듭니다. 데이터 이동을 허용해야 하는 특히 까다로운 기존 기능이 있다면, 초기에 Tenant Scale 팀에 연락해 샤딩 키를 관리하는 방법에 관한 선택지를 논의해야 합니다.

샤딩 키 값이 상위 테이블에서 오는 경우#

새 샤딩 키 칼럼에서 대상 테이블(projects, namespaces, organizations, users)로 직접 외래 키를 추가하기 전에, 그 테이블이 이미 같은 샤딩 키를 가진 상위 테이블을 참조하고 있는지 확인합니다. 참조하고 있다면 desired_sharding_key.backfill_via.parent를 사용해 그 상위 테이블에서 샤딩 키를 채우고, 상위 테이블의 외래 키에 의존합니다. 이 칼럼은 여전히 일반적인 샤딩 키이며 NOT NULL 제약 조건과 변경 불가능성 같은 다른 모든 요구 사항을 그대로 유지합니다. 생략되는 것은 중복된 외래 키 하나뿐입니다.

중복된 외래 키는 업그레이드를 망가뜨릴 수 있습니다. 상위 테이블이 대상 테이블을 참조하는 부분이 loose foreign key로 관리되면 정리가 최종적으로만 일관되므로, 상위 행이 이미 삭제된 행을 정상적으로 참조할 수 있습니다. 그 값을 하드 외래 키로 보호된 칼럼에 복사하는 백필은 외래 키 위반으로 실패하고 업그레이드를 막습니다 (이슈 605940).

중복된 외래 키는 대상 테이블에 쌓이기도 하며, 이는 마이그레이션의 락 경합을 더 심하게 만듭니다 (이슈 599943).

다음 경우에만 대상 테이블에 직접 외래 키를 추가합니다:

  • 테이블에 샤딩 키를 이미 가진 상위 테이블이 없는 경우, 또는
  • 직접 참조가 상위 테이블을 통해 도달할 수 있는 엔터티와 의도적으로 다른 엔터티인 경우(예: 네임스페이스 간 공유 대상, 템플릿 프로젝트, 사용자 지정 템플릿 네임스페이스, 미러 소스). 이 경우 직접 외래 키는 의미 있는 비정규화이므로 그대로 두어야 합니다.

이러한 요구 사항은 spec/lib/gitlab/organizations/sharding_key_spec.rb가 강제하며, 이 spec은 기본적으로 직접 외래 키를 요구합니다. 테이블이 이미 외래 키나 loose foreign key로 같은 대상을 참조하는 상위 테이블에서 샤딩 키 값이 오는 경우, spec이 상위 체인을 감지해 직접 외래 키 요구 사항을 대신 면제해 줍니다. 칼럼을 예외 목록에 추가할 필요는 없습니다.

namespace_id를 샤딩 키로 사용#

namespaces 테이블에는 Group, ProjectNamespace, UserNamespace를 참조할 수 있는 행이 있습니다. UserNamespace 유형은 개인 네임스페이스라고도 합니다.

namespace_id를 샤딩 키로 사용하는 것은 좋은 선택이지만, namespace_id가 UserNamespace를 참조할 때는 예외입니다. 사용자에게 관련된 namespace 레코드가 반드시 있는 것은 아니므로 이 샤딩 키는 NULL이 될 수 있습니다. 샤딩 키에는 NULL 값이 있으면 안 됩니다.

프로젝트와 네임스페이스에 같은 샤딩 키 사용#

개발자는 테이블이 사용하는 기능이 Consolidating Groups and Projects blueprint에 따라 개발되는 경우, 프로젝트에 속할 수 있는 테이블에도 namespace_id만 사용하도록 선택할 수 있습니다. 이 경우 namespace_id는 네임스페이스가 속한 그룹이 아니라 ProjectNamespace의 ID여야 합니다.

organization_id를 샤딩 키로 사용#

일반적으로 project_id 또는 namespace_id가 가장 흔한 샤딩 키입니다. 그러나 테이블이 프로젝트나 네임스페이스에 속하지 않는 경우도 있습니다.

그런 경우에는 아래 지침을 따르는 한 organization_id를 샤딩 키로 선택할 수 있습니다:

  • sharding_key 칼럼은 여전히 변경 불가능해야 합니다.
  • organization_id는 루트 레벨 모델(예: namespaces)에만 추가하고, 리프 레벨 모델(예: issues)에는 추가하지 않습니다.
  • 그러한 테이블에 그룹이나 프로젝트와 관련된 데이터(또는 그룹이나 프로젝트에 속한 레코드)가 들어 있지 않도록 합니다. 대신 project_id 또는 namespace_id를 사용합니다.
  • 행이 많은 테이블은 좋은 후보가 아닙니다. 엔터티를 다른 organization으로 옮길 때 모든 행을 다시 써야 하고 비용이 클 수 있습니다.
  • 이 테이블을 참조하는 다른 테이블이 있는 경우, 참조하는 테이블의 레코드가 다른 organization으로 옮겨져도 애플리케이션이 계속 동작해야 합니다.

organization_id가 샤딩 키로 가장 좋은 선택이라고 판단되면 Tenant Scale 그룹의 승인을 받습니다. 이는 데이터 마이그레이션에 영향을 주고 샤딩 키 선택을 다시 검토해야 할 수 있으므로 매우 중요합니다.

예시로, 기존 테이블에 organization_id를 샤딩 키로 추가한 이 이슈를 참고합니다.

organization_id로 테이블 샤딩#

organization_id로 샤딩되도록 새 테이블을 추가하거나 기존 테이블을 수정할 때는 다음을 수행해야 합니다:

  1. 전송 서비스 지원을 추가합니다. 그룹이나 사용자가 새 organization으로 전송될 때 레코드의 organization_id를 업데이트합니다.
  2. 팩토리에서 공통 organization을 사용합니다. RSpec 팩토리가 공통 organization과 자동으로 연결되도록 합니다. Namespaces 팩토리의 after build 블록을 참고합니다.

크로스 스키마 참조#

Cells 아키텍처에서는 organization 데이터를 cell 사이에서 안전하게 마이그레이션할 수 있어야 합니다. 크로스 스키마 참조는 일반적으로 허용되지 않습니다.

핵심 원칙: organization 데이터는 마이그레이션할 수 있어야 합니다#

organization이 다른 cell로 이동하면 organization 레벨 테이블에 저장된 모든 데이터가 전송되어야 합니다. 이는 다음을 의미합니다:

  • organization 데이터는 cell 로컬 데이터에 의존할 수 없습니다. 단, 그 의존성이 일관되거나 자가 복구되는 경우는 예외입니다.
  • cell 로컬 데이터는 organization 데이터를 참조할 수 있습니다. organization 데이터는 안정적이고 organization과 함께 이동하기 때문입니다.

허용되는 패턴#

다음 크로스 스키마 참조는 허용됩니다:

From To Why
gitlab_main_cell_local gitlab_main_org cell 로컬 데이터는 org 데이터를 안전하게 참조할 수 있습니다. org 데이터는 organization과 함께 이동합니다.
gitlab_ci_cell_local gitlab_ci CI/CD cell 로컬 데이터는 CI/CD org 데이터를 참조할 수 있습니다.

구현 지침#

organization 데이터가 cell 로컬 데이터를 참조해야 하는 경우:

마이그레이션이 차단되지 않도록 Loose Foreign Key를 사용합니다:

# config/gitlab_loose_foreign_keys.yml
org_table:
  - table: cell_local_table
    column: cell_local_id
    on_delete: async_delete

다만 마이그레이션 후 참조를 자가 복구하거나 다시 생성하는 애플리케이션 로직도 구현해야 합니다. 참조된 cell 로컬 데이터는 대상 cell에 존재하지 않거나 ID가 다를 수 있습니다. 애플리케이션은 다음 중 하나를 해야 합니다:

  • 진실 공급원에서 데이터를 다시 계산하거나 다시 가져와 참조를 다시 생성합니다
  • 누락되었거나 오래된 참조를 적절히 처리합니다
  • 마이그레이션 과정의 일부로 참조를 검증하고 복구합니다

cell 로컬 데이터가 organization 데이터를 참조해야 하는 경우:

일반 외래 키를 사용합니다.

class AddForeignKeyToCellLocalTable < Gitlab::Database::Migration[2.2]
  disable_ddl_transaction!

  def up
    add_foreign_key :cell_local_table, :org_table,
      column: :org_table_id,
      on_delete: :cascade
  end

  def down
    remove_foreign_key :cell_local_table, :org_table
  end
end

검증#

spec/lib/gitlab/database/no_cross_db_foreign_keys_spec.rb 테스트가 이러한 원칙을 강제합니다. 크로스 데이터베이스 외래 키 오류로 실패하면 다음 중 하나를 수행합니다:

  1. Loose Foreign Key를 사용합니다(org에서 cell 로컬로 향하는 참조에 권장).
  2. 이슈 번호와 함께 allowed_cross_database_foreign_keys에 추가합니다(기존 FK만 해당).

교훈: organization 데이터에서 불안정한 식별자 피하기#

organization 데이터가 외부 소스(예: Gitaly)를 참조할 때는 cell 사이에서 일관되지 않을 수 있는 식별자를 저장하지 않습니다.

예시: programming_languages 테이블은 Gitaly에서 데이터를 받습니다. 한 cell에서 생성된 ID는 다음 이유로 다른 cell과 다를 수 있습니다:

  • cell마다 초기 언어 세트가 다릅니다
  • 새 언어는 런타임에 발견됩니다
  • cell 사이에서 삽입 순서가 다릅니다

organization 데이터(예: repository_languages)가 이러한 불안정한 ID를 저장하면 데이터가 cell 사이에서 일관성을 잃고 안정적으로 마이그레이션할 수 없습니다.

해결책:

  1. 전역적으로 안정적인 식별자 사용: organization 데이터가 외부 데이터를 참조해야 한다면 모든 cell에서 일관된 식별자를 사용합니다(예: 사전 정의된 목록의 식별자).
  2. 계산된 데이터는 저장하지 않기: 데이터가 즉석에서 계산되고 organization과 함께 이동할 필요가 없다면 organization 테이블에 ID를 저장하지 않습니다.
  3. 참조를 자가 복구 가능하게 만들기: cell 로컬 데이터에 대한 참조를 저장해야 한다면 마이그레이션 후 다시 생성하거나 검증할 수 있게 합니다.
  4. Loose Foreign Key 사용: organization 데이터에서 cell 로컬 데이터로 향하는 참조에는 마이그레이션이 차단되지 않도록 Loose Foreign Key를 사용합니다.

자세한 사례 연구는 이슈 519895를 참고합니다.

샤딩 키 구현#

테이블에 샤딩 키를 추가하려면 다음 단계를 따릅니다. 샤딩 키가 없는 수백 개의 테이블에 sharding_key를 백필해야 합니다. 반복 작업을 최소화하기 위해 gitlab-housekeeper를 사용해 sharding_key를 백필하는 방법을 선언적으로 기술하는 방식을 도입했고, 이를 통해 수동으로 처리하는 대신 원하는 변경 사항이 담긴 MR을 생성할 수 있습니다.

애플리케이션 레벨에서 샤딩 키 존재 보장#

샤딩 키를 정의할 때는 애플리케이션 레벨에서 값이 채워지도록 해야 합니다. 모든 ApplicationRecord 모델에는 populate_sharding_key 헬퍼가 포함되어 있어 샤딩 키 로직을 정의하는 편리한 방법을 제공하며, 샤딩 키 로직을 테스트하는 대응 matcher도 함께 제공됩니다. 예를 들어:

# in model.rb
populate_sharding_key :project_id, source: :merge_request, field: :target_project_id

# in model_spec.rb
it { is_expected.to populate_sharding_key(:project_id).from(:merge_request, :target_project_id) }

더 많은 헬퍼 예시와 RSpec matcher 예시를 참고합니다.

desired_sharding_key 구성 정의#

백필 과정을 자동화하려면 테이블의 YAML 구성에 desired_sharding_key를 정의합니다. 예시는 이 MR에 추가되었습니다:

--- # db/docs/security_findings.yml
table_name: security_findings
classes:
- Security::Finding

# ...

desired_sharding_key:
  project_id:
    references: projects
    backfill_via:
      parent:
        foreign_key: scanner_id
        table: vulnerability_scanners
        table_primary_key: id # Optional. Defaults to 'id'
        sharding_key: project_id
        belongs_to: scanner

이 YAML은 배치 백그라운드 마이그레이션에서 백필할 상위 테이블과 그 테이블의 sharding_key를 지정합니다. 또한 모델에 추가되어 before_save에서 sharding_key를 채우는 belongs_to 관계도 지정합니다.

상위 테이블에도 desired_sharding_key가 있는 경우

상위 테이블에도 desired_sharding_key 구성이 있고 그 테이블 자체가 백필을 기다리고 있다면 awaiting_backfill_on_parent 필드를 포함합니다:

desired_sharding_key:
  project_id:
    references: projects
    backfill_via:
      parent:
        foreign_key: package_file_id
        table: packages_package_files
        table_primary_key: id # Optional. Defaults to 'id'
        sharding_key: project_id
        belongs_to: package_file
    awaiting_backfill_on_parent: true

이 desired_sharding_key 구조가 sharding_key 백필에 적합하지 않은 예외 사례도 있습니다. 그런 경우에는 테이블을 소유한 팀이 필요한 머지 리퀘스트를 직접 만들어야 합니다.

칼럼, 트리거, 인덱스, 외래 키 추가#

이 단계에서는 샤딩 키 칼럼과 인덱스, 외래 키, 필요한 트리거를 추가합니다.

1. 설정 단계:

  1. Housekeeper에 필요한 키를 설정합니다: export HOUSEKEEPER_TARGET_PROJECT_ID=278964(GitLab 프로젝트의 프로젝트 ID).

  2. 자신의 PAT를 새로 만듭니다: export HOUSEKEEPER_GITLAB_API_TOKEN=<your-pat>.

  3. 로컬 master 브랜치를 업데이트합니다: git checkout master && git pull origin master --rebase.

  4. 다음 명령으로 sharding-key-backfill-keeps 브랜치로 전환합니다:

    git checkout sharding-key-backfill-keeps
    

    이 브랜치는 MR에서도 찾을 수 있습니다.

  5. 이 브랜치를 master 위로 리베이스하고 변경 사항을 origin에 다시 푸시합니다. 이렇게 하면 이 브랜치가 master의 변경 사항을 반영합니다:

    git pull origin master --rebase
    
  6. 다음 명령을 실행해 리베이스된 변경 사항을 브랜치에 다시 푸시하고, LEFTHOOK=0은 생략합니다(그러지 않으면 RuboCop이 실패합니다):

    LEFTHOOK=0 git push --force-with-lease -o ci.skip
    
  • bundle install과 마이그레이션을 실행합니다.

이 브랜치에는 어떤 변경 사항도 푸시하지 않습니다. 계속 리베이스만 합니다.

2. 자동화된 MR 생성 단계:

소형 테이블과 대형 테이블의 샤딩 키 keep은 keeps 디렉터리에 저장합니다. 파일 이름은 backfill_desired_sharding_key_*.rb로 시작합니다.

소형 테이블 keep을 살펴봅니다:
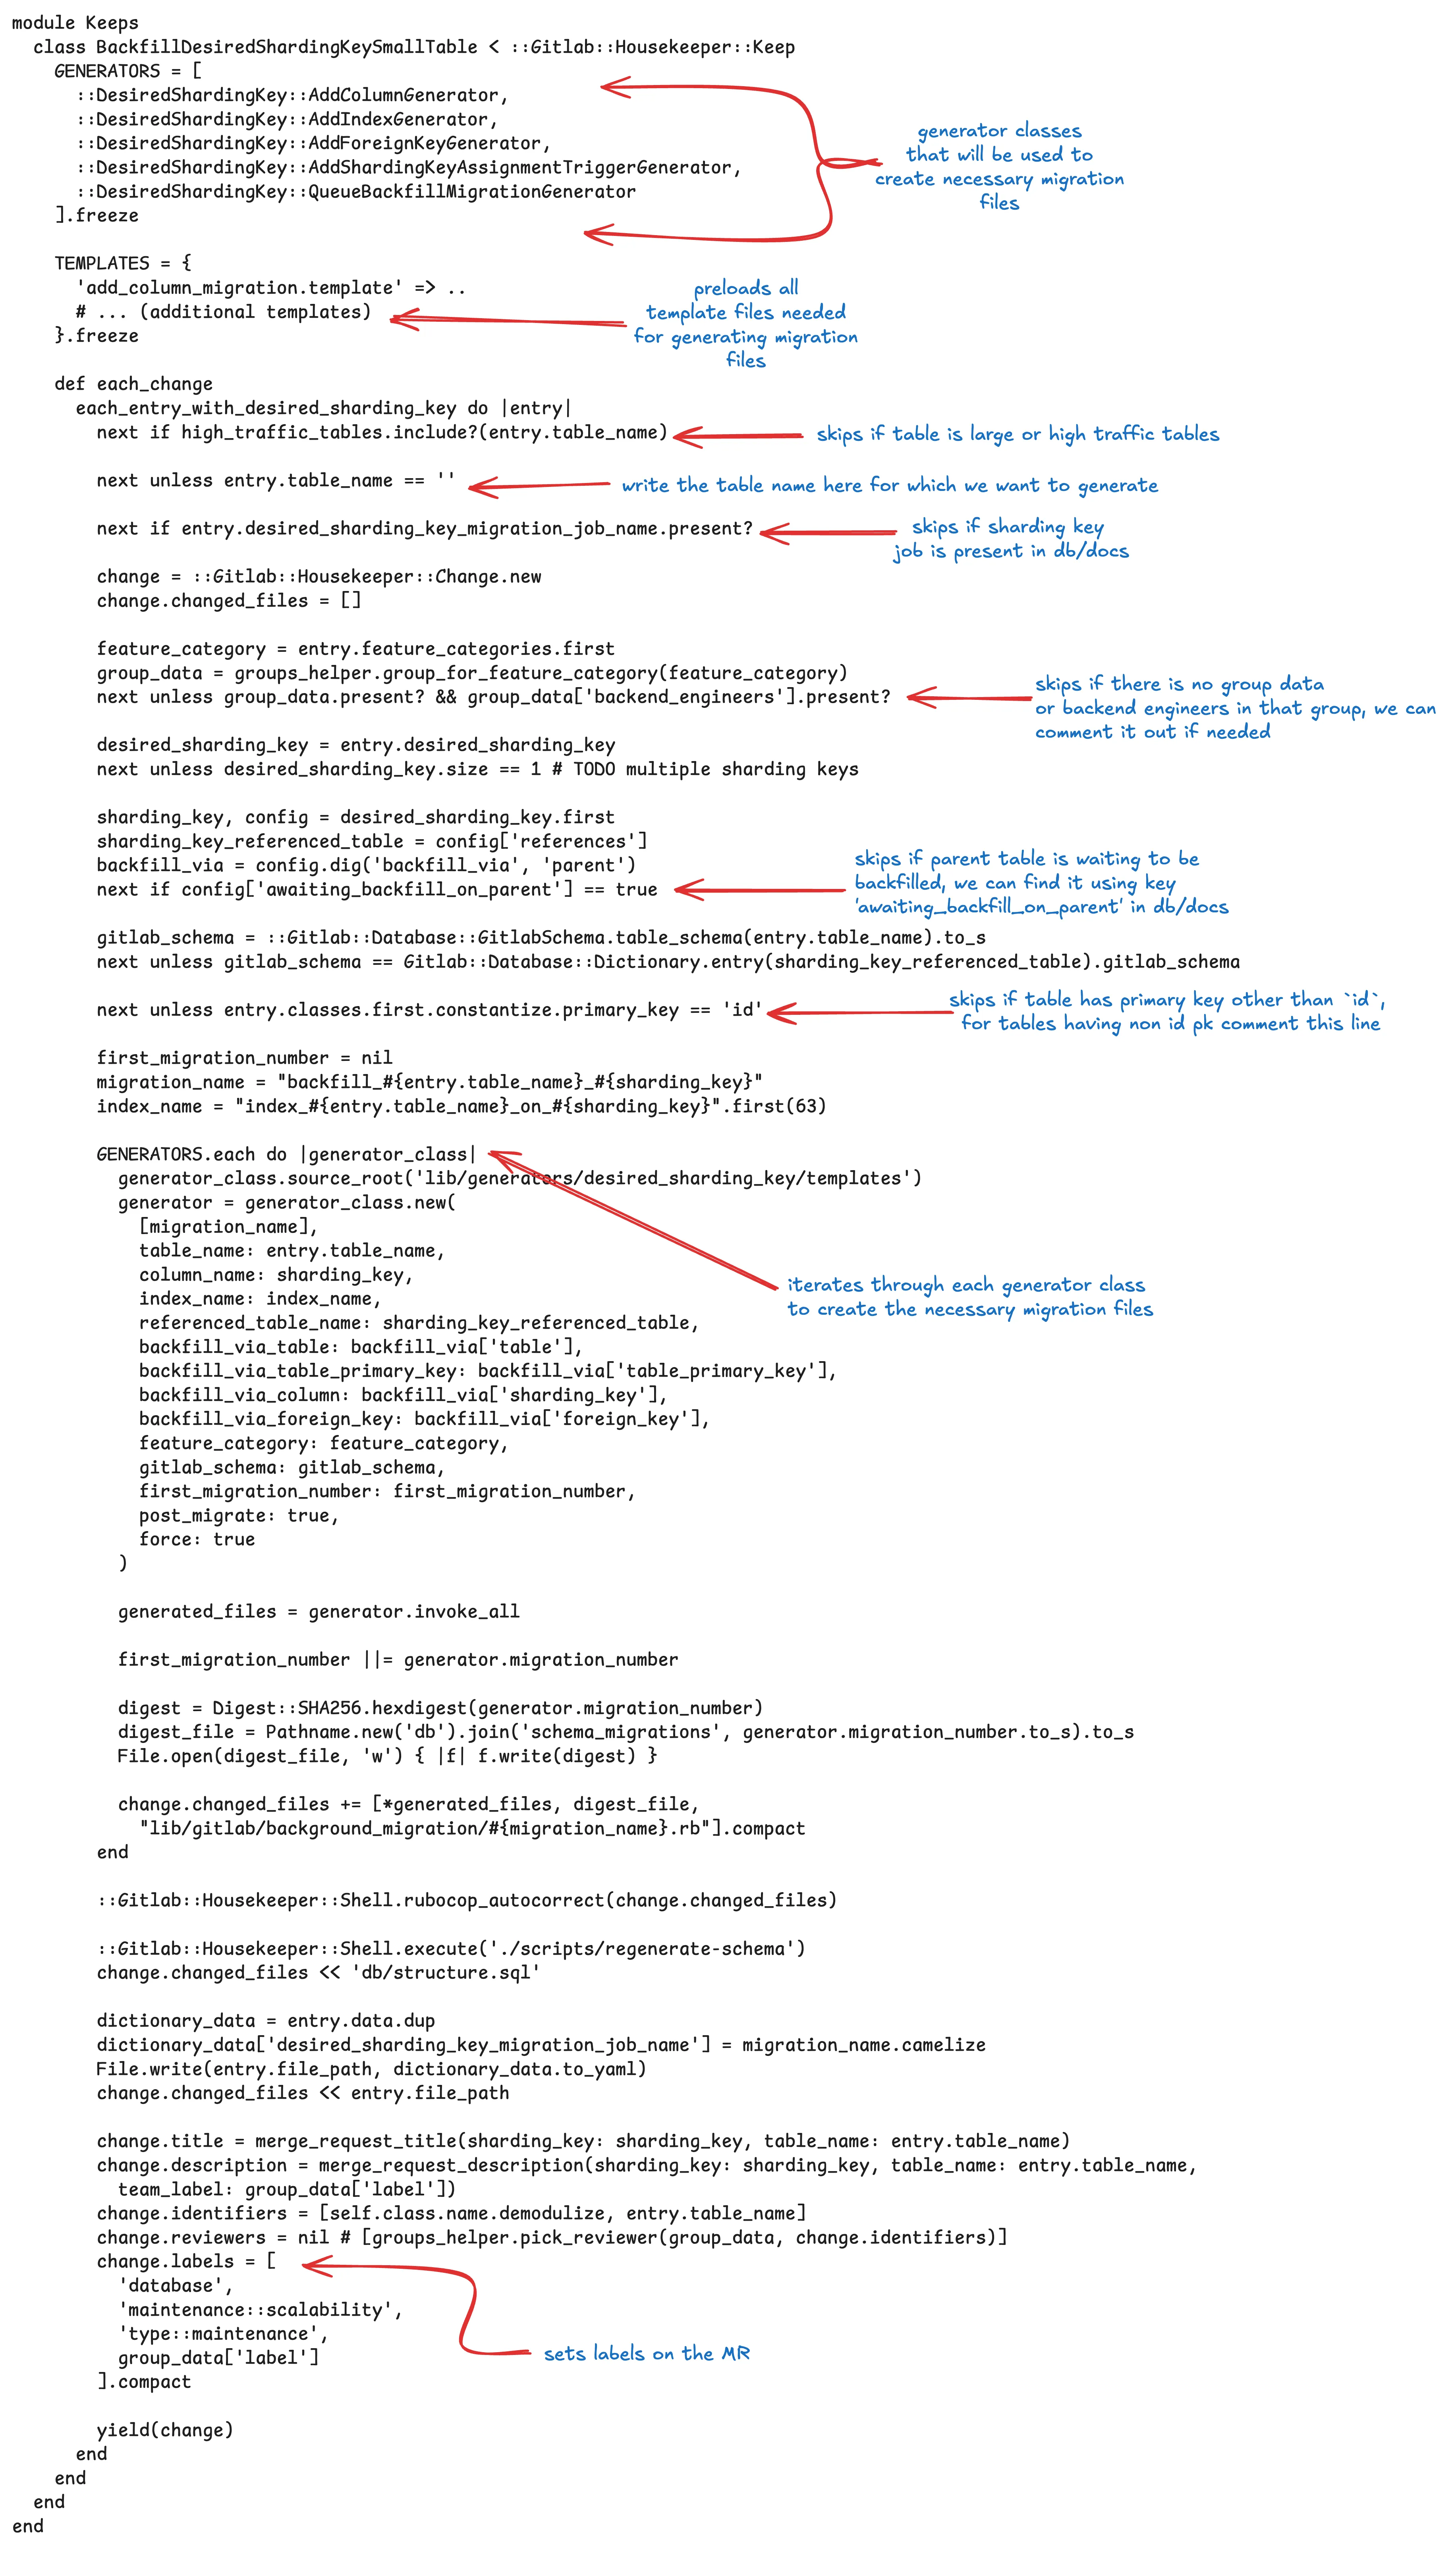
데이터베이스 항목을 순회하며 샤딩 키를 추가하는 Housekeeper Keep 클래스 코드.

이 keep 파일에는 다음을 수행하는 코드가 들어 있습니다:

  • 소형 테이블에서 desired sharding key를 백필하는 Housekeeper::Keep 클래스를 정의합니다
  • 변경 유형에 ::Keeps::DesiredShardingKey::CHANGE_TYPES를 포함하도록 설정합니다
  • database_yaml_entries의 항목을 순회합니다
  • 각 항목에 대해 필요하면 인덱스, 트리거, 외래 키를 포함해 샤딩 키 칼럼을 추가합니다
  1. keep 파일을 열고 next unless entry.table_name == 'table name'을 추가합니다. 여기서 테이블 이름은 마이그레이션을 만들려는 테이블의 이름입니다.

  2. 테이블의 desired_sharding_key 구성을 기준으로 빠르게 점검합니다. 구성이 올바른지, 상위 테이블의 샤딩 키에 기대한 대로 NOT NULL 제약 조건이 있는지 확인합니다. 그렇지 않다면 그 테이블은 건너뛰고 다른 테이블로 넘어갑니다. 테이블에 문제가 없으면 계속 진행할 수 있습니다.

  3. 테이블의 기본 키를 확인합니다. 터미널에서 다음 명령을 실행합니다:

    • gdk psql
    • \d <table_name>
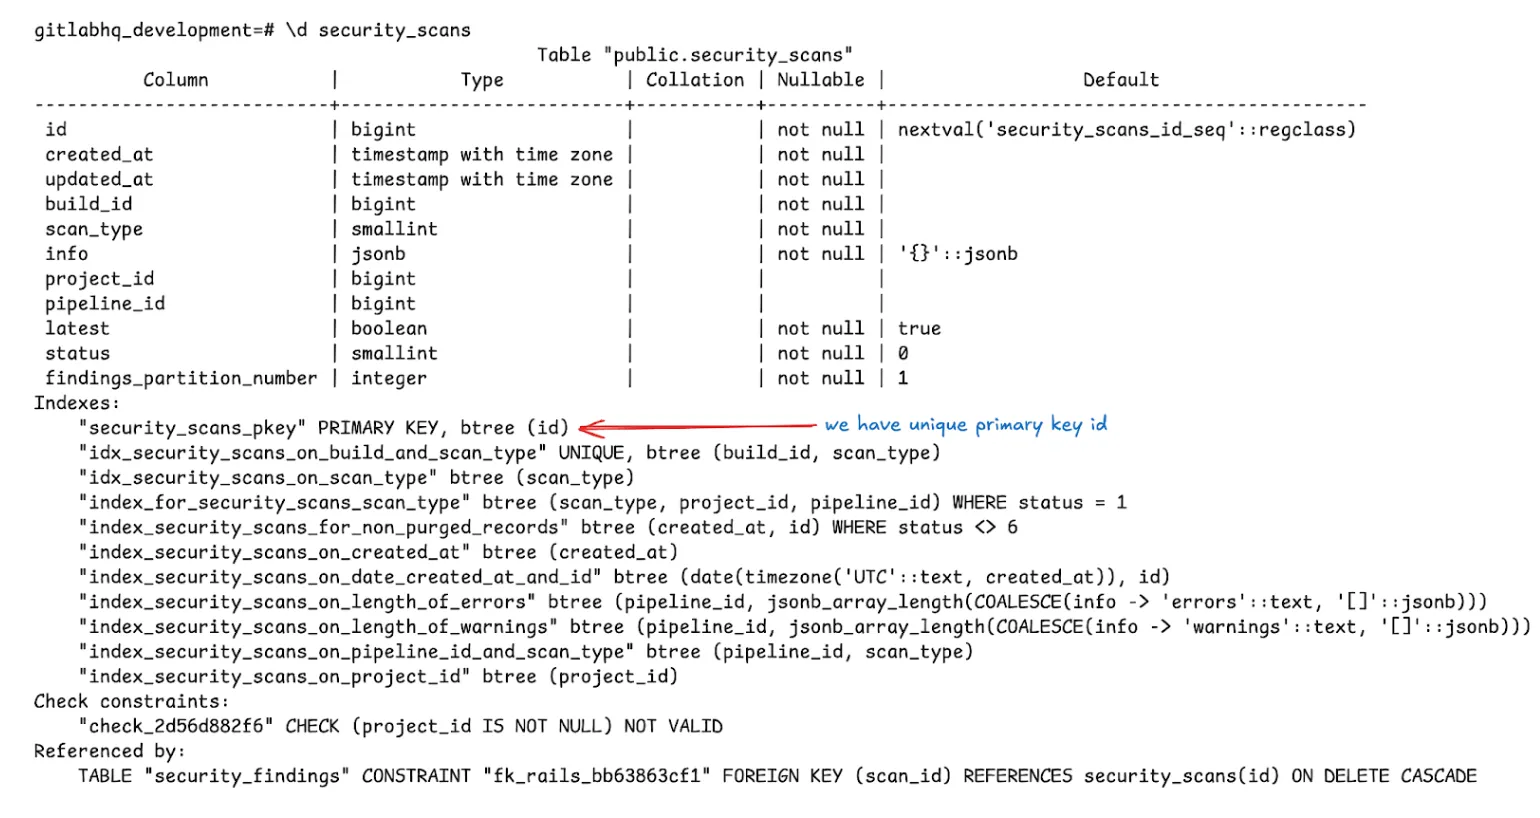
  4. 위 명령을 실행하면 인덱스, pk 등 테이블에 관한 유용한 정보를 얻을 수 있습니다. 예를 들어 security_scans 테이블은 다음과 같습니다:

    security_scans 테이블의 칼럼, 기본 키, 인덱스, 외래 키 관계를 보여 주는 데이터베이스 스키마 출력.

    출력에 표시되는 내용입니다:

    • 테이블: public.security_scans
    • 칼럼: id(bigint, not null), created_at(timestamp), updated_at(timestamp), build_id(bigint, not null), scan_type(smallint, not null) 및 기타 필드
    • 기본 키: security_scans_pkey(id에 대한 btree)
    • 인덱스: index_security_scans_on_build_id와 index_security_scans_on_project_id 포함
    • 외래 키: ci_builds와 projects에 대한 참조 포함
  5. 기본 키가 복합 키이거나 유일하지 않은 경우가 많아 keep에서 수동 수정이 필요하므로 이 확인은 중요합니다.

  6. 실행을 드라이런합니다. 드라이런은 생성될 변경 사항을 보여 주고 아무것도 커밋하지 않습니다:

    • bundle exec gitlab-housekeeper -k Keeps::BackfillDesiredShardingKeySmallTable -d
  7. 드라이런 결과가 괜찮으면 -d 플래그 없이 같은 명령을 실행합니다:

    • bundle exec gitlab-housekeeper -k Keeps::BackfillDesiredShardingKeySmallTable

    • 위 명령을 실행하면 변경 사항이 담긴 MR이 생성됩니다

대형 테이블에도 같은 방법을 따르고 대형 테이블 keep을 사용합니다. 유일한 차이는 성능 때문에 테이블에 FK를 두지 않는다는 점입니다.

유용한 요령 몇 가지:

1. :id가 아닌 기본 키를 가진 테이블

  1. 첫 번째 diff, 두 번째 diff, 세 번째 diff에서 :id를 ID가 아닌 기본 키로 바꿉니다.

  2. 이 diff에서 이 줄을 주석 처리합니다.

  3. 이 예시에서 한 것처럼 이 파일에 let(:batch_column) 줄을 추가합니다.

    예시 MR: !165940 (merged). 테이블이 gitlab_ci db를 사용한다면 마이그레이션 파일에 migration: :gitlab_ci를 지정해야 합니다.

2. 복합 기본 키(둘 이상)를 가진 테이블

  1. 테이블 정보를 가져와 기본 키 칼럼 중 하나에 UNIQUE 인덱스가 정의되어 있는지 확인하고, 정의되어 있다면 위에서 한 것처럼 그 칼럼을 기본 키이자 배치 칼럼으로 사용합니다.

  2. 어느 칼럼도 유일하지 않다면 변경 사항을 직접 추가해야 합니다.

  3. deployment_merge_requests 테이블을 예로 듭니다. 이 테이블은 유일하지 않은 복합 기본 키 "deployment_merge_requests_pkey" PRIMARY KEY, btree (deployment_id, merge_request_id)를 가진 테이블입니다.

  4. 커서 기반 배치 처리를 사용했습니다.

  5. 먼저 keep으로 변경 사항을 생성한 후 그 변경 사항을 편집합니다.

  6. 큐 백필 post migrate 파일을 열고 모든 변경 사항을 제거한 후 새로 추가합니다. 예를 들어:
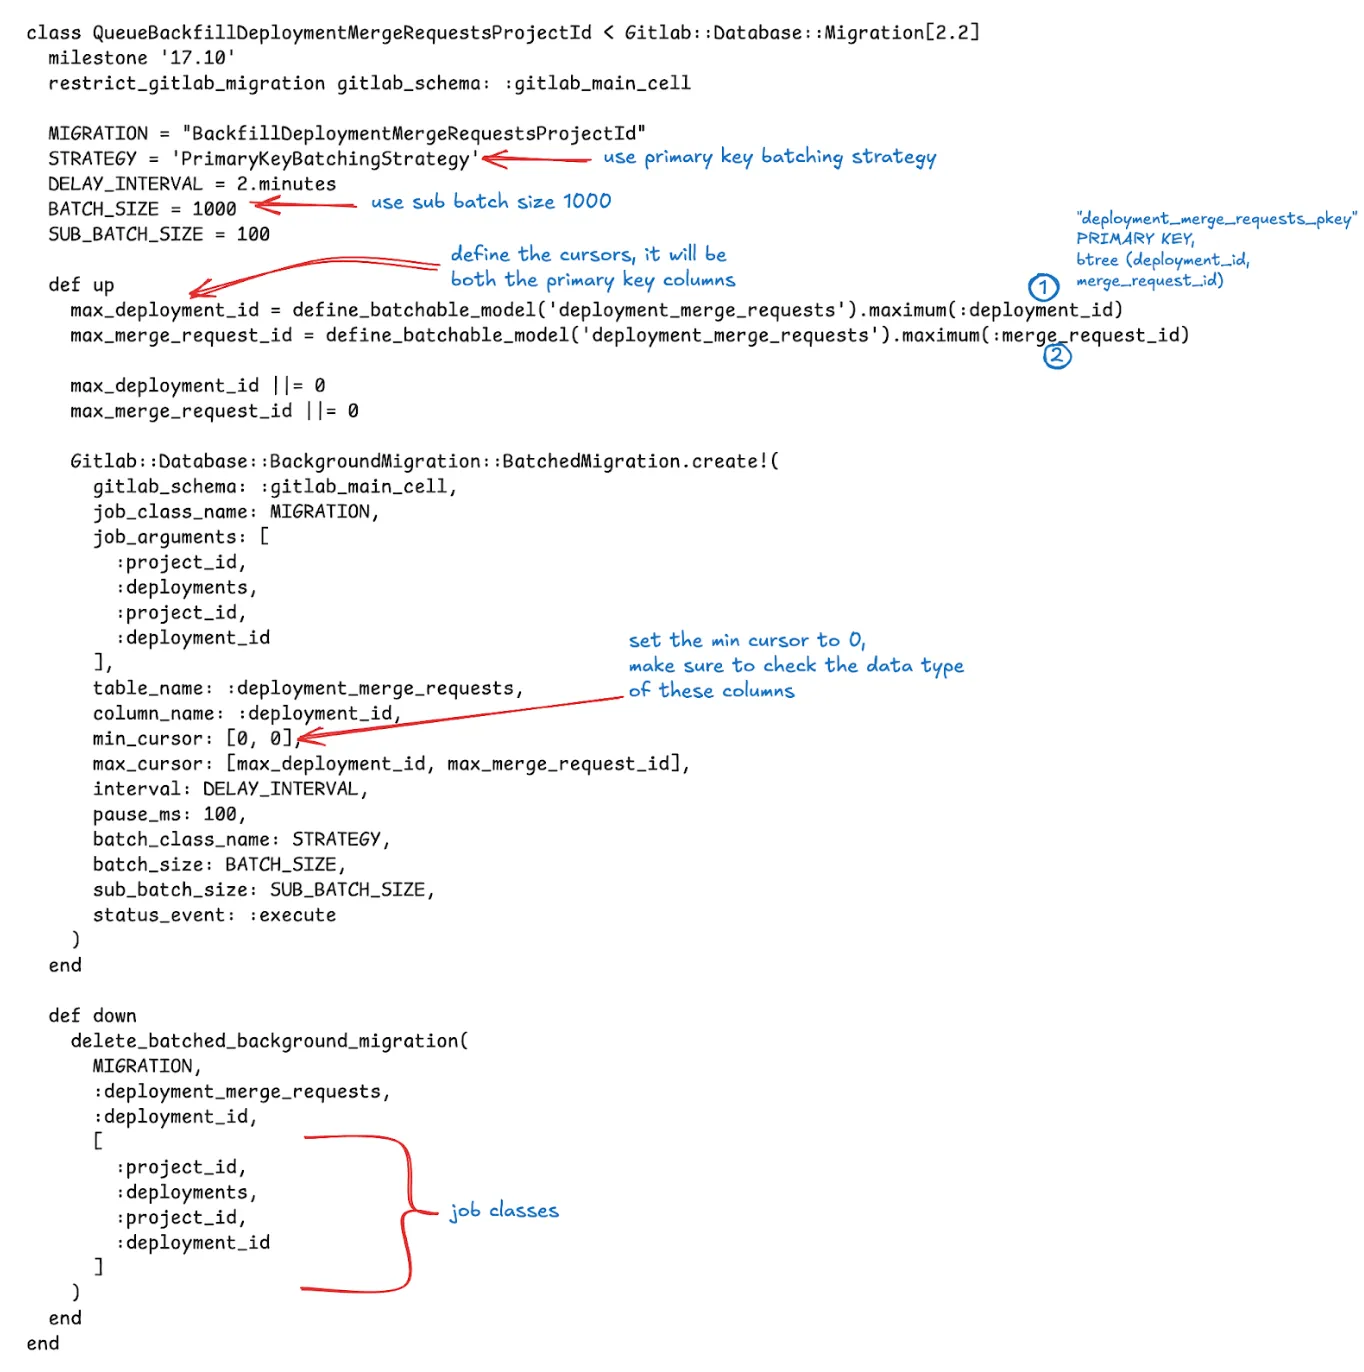
    deployment_id와 merge_request_id 칼럼을 사용하는 커서 기반 배치 처리 마이그레이션 코드.

    예시 MR: !183738 (merged)

  7. 위 변경 방식은 이런 특성을 가진 다른 테이블에도 사용할 수 있습니다.

  8. lib/gitlab/background_migration/backfill_*.rb를 열고 keep이 생성한 모든 변경 사항을 제거한 후 다음을 추가합니다:
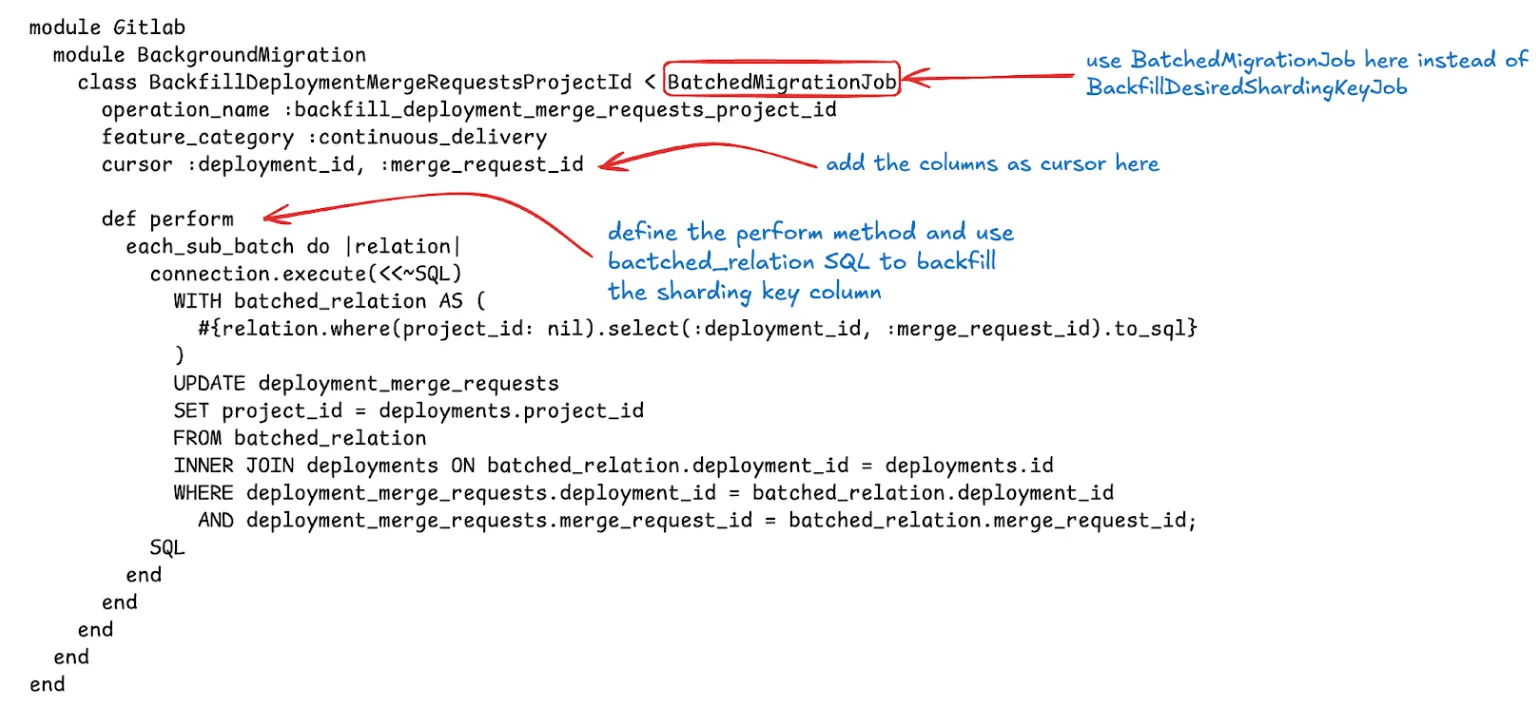
    커서 기반 순회로 샤딩 키를 업데이트하는 백그라운드 마이그레이션 job.

    !183738을 참고합니다.

  9. 테이블이 대형이면 schema_spec.rb의 무시 FK 목록 :ignored_fk_columns_map에 샤딩 키를 추가합니다.

  10. spec도 반드시 함께 업데이트합니다.

    추가 예시: !183047 (merged), !176714 (merged).

3. 다른 데이터베이스에 있는 테이블

  • 테이블은 ci db에 있고 샤딩 키는 main db에 있는 경우가 있을 수 있습니다.

  • 예를 들어 dast_site_profiles_builds는 sec db에 있고 샤딩 키 테이블 projects는 main db에 있습니다.

  • 이 경우 LFK(loose foreign key)를 추가해야 할 수 있습니다. 예: housekeep이 만든 MR, 그 뒤에 LFK를 추가했습니다.

  • 백필 spec과 큐 spec에 migration: :gitlab_sec를 반드시 추가합니다.

  • 서로 다른 db에 있으므로 일반 FK는 동작하지 않습니다.

  • 상위 테이블 dast_site_profiles에는 projects에 대한 LFK가 있습니다.

  • dast_site_profiles_builds 테이블이 상위 테이블 dast_site_profiles에 CASCADE 삭제가 설정된 FK 관계를 가지고 있으면, 연관된 dast_site_profiles 레코드가 삭제될 때 레코드도 삭제됩니다.

  • 다만 dast_site_profiles_builds에도 LFK 항목을 추가하는 것이 좋습니다.

     dast_site_profiles_builds:
       - table: projects
         column: project_id
         on_delete: async_delete
    

파이널라이제이션 마이그레이션#

칼럼이 추가되고 백필이 끝나면 마이그레이션을 파이널라이즈해야 합니다. 큐에 들어간 마이그레이션의 상태는 #chat-ops-test Slack 채널에서 확인할 수 있습니다.

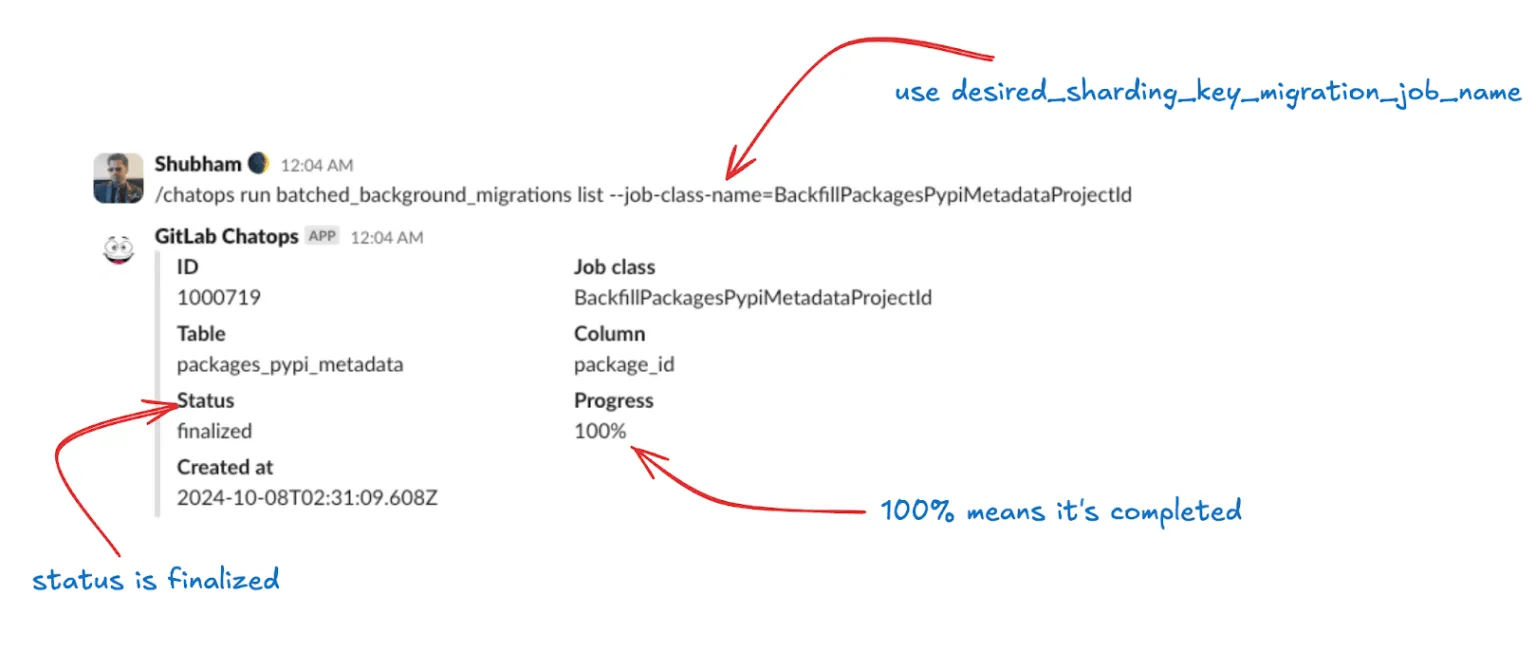
  • 특정 job의 상태를 확인하려면 /chatops gitlab run batched_background_migrations list --job-class-name=<desired_sharding_key_migration_job_name>을 사용합니다

  • 출력은 다음과 같습니다:

    진행률과 배치 개수를 포함해 배치 백그라운드 마이그레이션 상태를 보여 주는 ChatOps 응답.

    ChatOps 출력에 표시되는 내용입니다:

    • job 클래스 이름
    • 테이블 이름
    • 상태(예: finished, active, paused)
    • 진행률
  1. 100%가 되면 master에서 새 브랜치를 만들고 다음을 실행합니다: bundle exec rails g post_deployment_migration finalize_<table><sharding_key>

    이 명령은 배포 후 마이그레이션 파일을 만듭니다. 그 파일을 편집합니다. 예를 들어 subscription_user_add_on_assignments 테이블의 경우 다음과 같습니다:

    class FinalizeBackfillSubscriptionUserAddOnAssignmentsOrganizationId < Gitlab::Database::Migration[2.2]
      milestone '17.6'
      disable_ddl_transaction!
    
      restrict_gitlab_migration gitlab_schema: :gitlab_main_org
    
      def up
        ensure_batched_background_migration_is_finished(
          job_class_name: 'BackfillSubscriptionUserAddOnAssignmentsOrganizationId',
          table_name: :subscription_user_add_on_assignments,
          column_name: :id,
          job_arguments: [:organization_id, :subscription_add_on_purchases, :organization_id, :add_on_purchase_id],
          finalize: true
        )
      end
    
      def down; end
    end
    
  2. job_class_name, table_name, column_name, job_arguments를 제외하면 다른 모든 테이블에서도 비슷합니다. job 인자가 올바른지 확인합니다. 샤딩 키 추가 및 백필 MR에서 job 인자를 대조할 수 있습니다.

  3. 작업이 끝나면 bin/rails db:migrate를 실행하고 db/docs의 finalized_by 키를 업데이트합니다. 예시 MR: !169834.

  • 여기까지입니다. git commit 후 MR을 만듭니다.

NOT NULL 제약 조건 추가#

마지막 단계는 샤딩 키에 NOT NULL 제약 조건이 있는지 확인하는 것입니다.

소형 테이블

  1. bundle exec rails g post_deployment_migration <table_name>_not_null로 배포 후 마이그레이션을 만듭니다

    예를 들어 subscription_user_add_on_assignments 테이블의 경우:

    class AddSubscriptionUserAddOnAssignmentsOrganizationIdNotNull < Gitlab::Database::Migration[2.2]
      milestone '17.6'
      disable_ddl_transaction!
    
      def up
        add_not_null_constraint :subscription_user_add_on_assignments, :organization_id
        end
    
      def down
        remove_not_null_constraint :subscription_user_add_on_assignments, :organization_id
      end
    end
    
  2. bin/rails db:migrate를 실행합니다.

  3. 해당 db/docs.*.yml 파일, 이 경우 db/docs/subscription_user_add_on_assignments.yml을 열고 desired_sharding_key와 desired_sharding_key_migration_job_name 구성을 제거한 후 sharding_key를 추가합니다.

    sharding_key:
      organization_id: organizations
    

대형 테이블 또는 런타임을 초과하는 테이블

이 경우 샤딩 키를 추가하기 전에 비동기 검증을 추가해야 합니다. MR 2개로 진행하는 과정입니다. packages_package_files 테이블을 예로 듭니다.

1단계(MR 1): packages_package_files의 샤딩 키에 NOT NULL 추가:

  1. validate: false로 not null 제약 조건을 추가하는 배포 후 마이그레이션을 만듭니다.
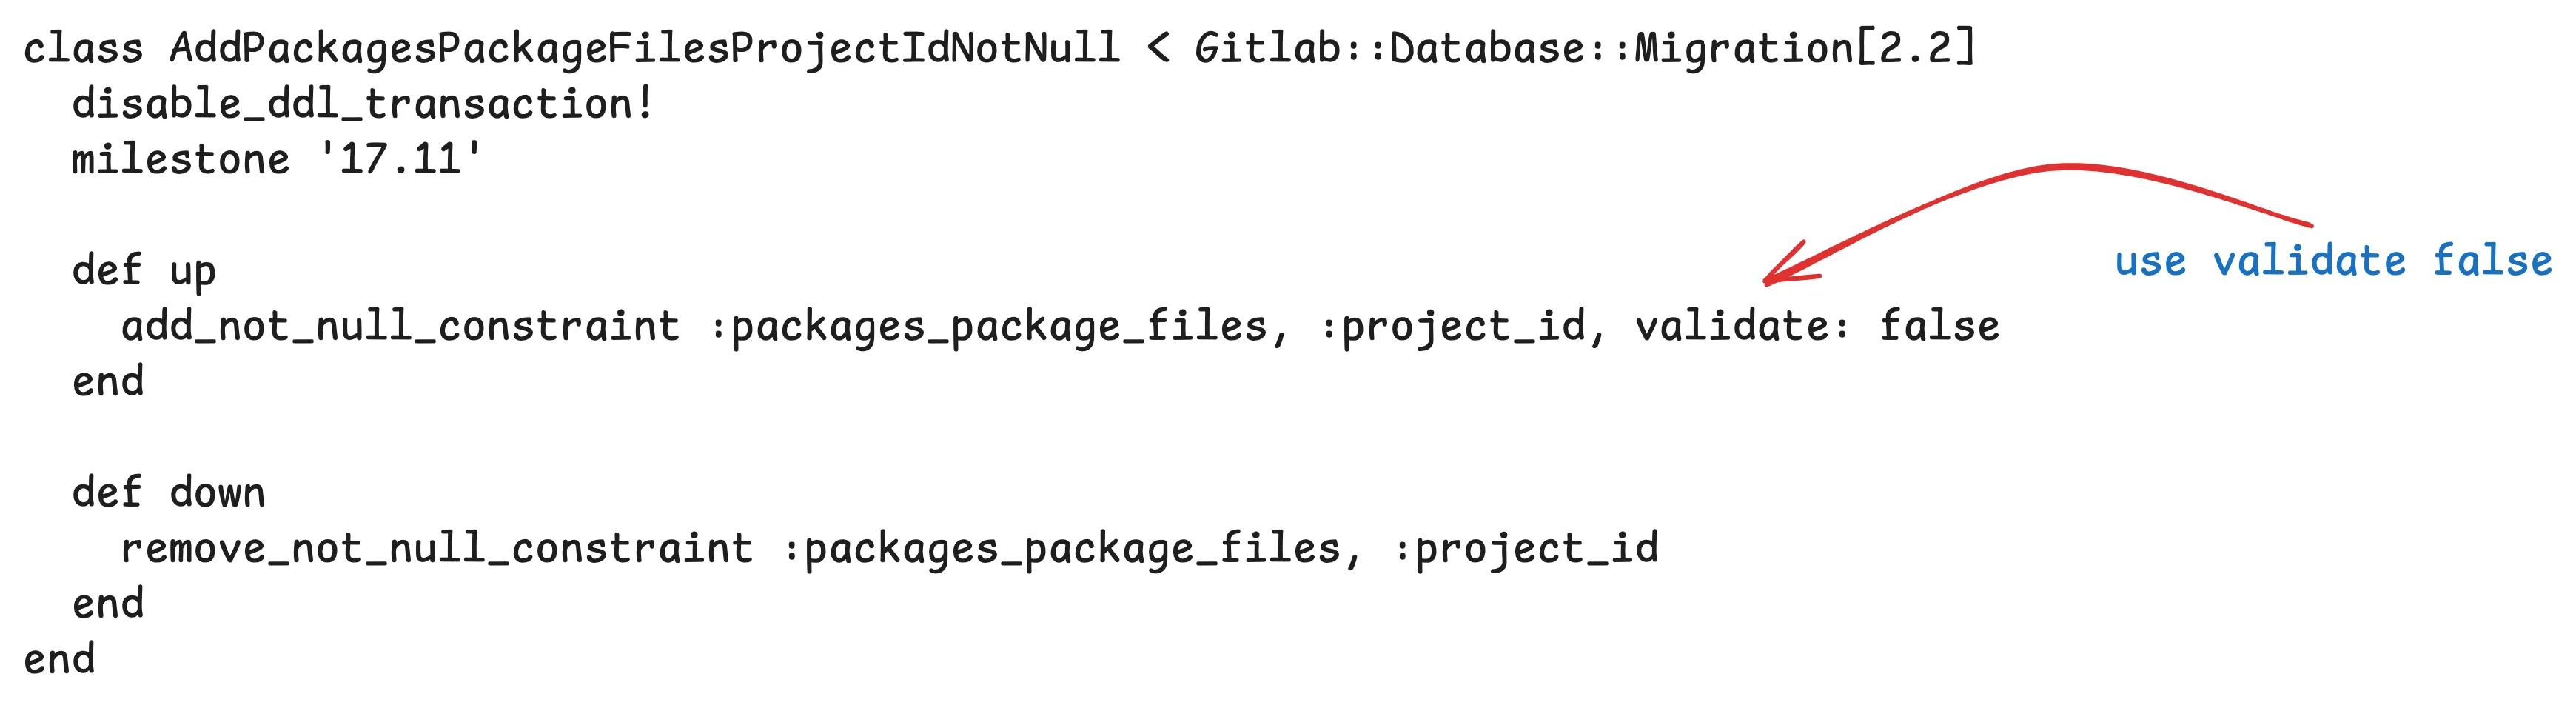
    비동기 검증을 위해 project_id에 검증되지 않은 not null 제약 조건을 추가하는 마이그레이션.

    class AddPackagesPackageFilesProjectIdNotNull < Gitlab::Database::Migration[2.2]
      milestone '17.11'
      disable_ddl_transaction!
    
      def up
        add_not_null_constraint :packages_package_files, :project_id, validate: false
      end
    
      def down
        remove_not_null_constraint :packages_package_files, :project_id
      end
    end
    
  2. 비동기 제약 조건 검증을 준비하는 또 다른 배포 후 마이그레이션을 만듭니다.

    class PreparePackagesPackageFilesProjectIdNotNullValidation < Gitlab::Database::Migration[2.2]
      disable_ddl_transaction!
      milestone '17.11'
    
      CONSTRAINT_NAME = :check_43773f06dc
    
      def up
        prepare_async_check_constraint_validation :packages_package_files, name: CONSTRAINT_NAME
      end
    
      def down
        unprepare_async_check_constraint_validation :packages_package_files, name: CONSTRAINT_NAME
      end
    end
    
  3. bin/rails db:migrate를 실행하고 변경 사항으로 MR을 만듭니다.

2단계(MR 2): packages_package_files에서 project_id NOT NULL 검증:

  1. 1단계의 MR이 머지되면 준비가 되도록 며칠 기다립니다. 상태는 https://console.postgres.ai/에서 확인할 수 있으며, joe 인스턴스 봇에 테이블 정보를 요청하면 됩니다. Check constraints를 확인합니다.

    • 샤딩 키 project_id가 NOT VALID로 표시됩니다.
    Check constraints:
      "check_43773f06dc" CHECK (project_id IS NOT NULL) NOT VALID
    
  2. 표시되면 not null 제약 조건을 검증하는 새 배포 후 마이그레이션을 만들 수 있습니다. down 마이그레이션은 no-op입니다.

  3. bin/rails db:migrate를 실행하고 structure.sql에서 다음 add constraint를 제거한 후 테이블 정의에 추가합니다:

    • 제거:
    ALTER TABLE packages_package_files
         ADD CONSTRAINT check_43773f06dc CHECK ((project_id IS NOT NULL)) NOT VALID;
    
    • 추가:
    CREATE TABLE packages_package_files (
        .
        .
        CONSTRAINT check_43773f06dc CHECK ((project_id IS NOT NULL)),
    );
    
  4. 해당 db/docs.*.yml 파일, 이 경우 db/docs/packages_package_files.yml을 열고 desired_sharding_key와 desired_sharding_key_migration_job_name 구성을 제거한 후 sharding_key를 추가합니다.

  5. 이 마이그레이션을 되돌리는 것은 #no-op으로 의도된 것이므로 pipeline:skip-check-migrations 레이블을 붙여 MR을 만듭니다.

Note

파이프라인이 FK 누락을 문제로 삼을 수 있습니다. FK를 sharding_key_spec.rb의 allowed_to_be_missing_foreign_key에 추가해야 합니다. FK 생략이 허용되는 경우에 관한 지침은 샤딩 키 칼럼에서 외래 키를 생략하는 경우를 참고합니다.

샤딩 키 칼럼에서 외래 키를 생략하는 경우#

샤딩 키 칼럼은 외래 키 제약 조건으로 상위 테이블(projects, namespaces, organizations)을 참조해야 합니다. 시간 기반 파티션 관리(partitioned_by의 retain_for로 구성)를 통해 고정된 보존 기간이 지난 데이터를 테이블이 자동으로 삭제하는 경우에는 외래 키를 생략할 수 있습니다. 오래된 파티션이 전체 단위로 삭제되므로, 참조 무결성은 연쇄 FK 제약 조건이 아니라 보존 정책으로 유지됩니다. sliding_list 파티셔닝 전략을 사용하는 테이블도 마찬가지이며, 이 경우 모든 행이 오래된 것으로 간주되면 파티션이 분리되고 삭제됩니다.

예시 1: retain_for를 사용한 고정 보존

web_hook_logs_daily는 일별로 파티셔닝되며 7일보다 오래된 파티션을 삭제합니다:

partitioned_by :created_at, strategy: :daily, retain_for: 7.days

오래된 파티션이 자동으로 삭제되므로 projects를 참조하는 web_hook_logs_daily.project_id의 외래 키는 필요하지 않습니다.

예시 2: sliding list 파티셔닝

security_findings는 sliding_list 전략을 사용하며, 파티션의 모든 findings가 제거된 스캔과 연관되고 security_scan_stale_after_days보다 오래되면 그 파티션을 분리합니다 (이 값은 구성할 수 있고 기본값은 3개월입니다):

partitioned_by :partition_number,
  strategy: :sliding_list,
  next_partition_if: ->(partition) { partition_full?(partition) || oldest_record_stale?(partition) },
  detach_partition_if: ->(partition) { detach_partition?(partition.value) }

오래된 파티션이 분리되고 결국 삭제되므로, projects를 참조하는 security_findings.project_id의 외래 키는 필요하지 않습니다.

이 이유로 외래 키를 생략할 때는 보존 동작을 설명하는 주석과 함께 spec/lib/gitlab/organizations/sharding_key_spec.rb의 allowed_to_be_missing_foreign_key에 칼럼을 추가합니다:

# No LFK needed: daily partitions are dropped after 7 days via retain_for
'web_hook_logs_daily.project_id', # https://gitlab.com/gitlab-org/gitlab/-/issues/524820

# No LFK needed: sliding_list partitions are detached once findings are stale and purged
'security_findings.project_id', # https://gitlab.com/gitlab-org/gitlab/-/work_items/588191

전송 서비스 지원 추가#

  1. 테이블이 organization_id로 샤딩되면 config/organizations/transfer_support.yml에 전송 지원 상태도 등록해야 합니다. 이 파일은 organization 전송(사용자나 그룹이 organization 사이를 이동할 때) 중에 각 테이블이 처리되는지 여부를 추적합니다.

    • {,ee/}app/services/**/organizations/transfer/*_service.rb의 전송 서비스 중 하나에 전송 로직을 구현했다면 supported로 설정합니다.
    • organization 전송에 변경이 필요하지 않은 테이블이면 no_work_needed로 설정합니다.
    • 전송 지원이 아직 구현되지 않은 기존 테이블은 https://gitlab.com/gitlab-org/gitlab/-/issues/<id> 또는 /-/work_items/<id> 형식의 추적 이슈 URL로 설정합니다. 새 테이블은 반드시 supported를 사용해야 합니다.

    알파벳 순서로 항목을 추가합니다:

    # config/organizations/transfer_support.yml
    your_table_name: supported
    
  2. update_organization_id_for 헬퍼를 사용해 적절한 전송 서비스에 테이블을 추가합니다:

    # app/services/organizations/transfer/users_service.rb
    def update_associated_organization_ids(user_ids)
      update_organization_id_for(PersonalAccessToken) { |relation| relation.for_users(user_ids) }
      update_organization_id_for(YourModel) { |relation| relation.where(user_id: user_ids) }
    end
    

팩토리에서 공통 organization 사용#

organization_id로 샤딩된 모델의 RSpec 팩토리는 공통 organization과 자동으로 연결되어야 합니다. 이렇게 하면 명시적인 organization 설정 없이도 테스트가 올바르게 동작합니다.

# spec/factories/your_models.rb
factory :your_model do
  organization { association(:common_organization) }
  # or derive from a related model
  organization { user&.organization || association(:common_organization) }
end

실패 디버깅#

Kibana 사용

백필 job을 큐에 넣은 후 실패 알림을 받는 경우가 있습니다. 한 가지 방법은 Kibana 로그를 사용하는 것입니다.

참고: Kibana 로그는 7일만 보관합니다

최근의 BackfillPushEventPayloadsProjectId BBM 실패를 예로 듭니다.

  • 실패는 백필된 원래 MR의 댓글로도 보고됩니다. 예: MR !183123
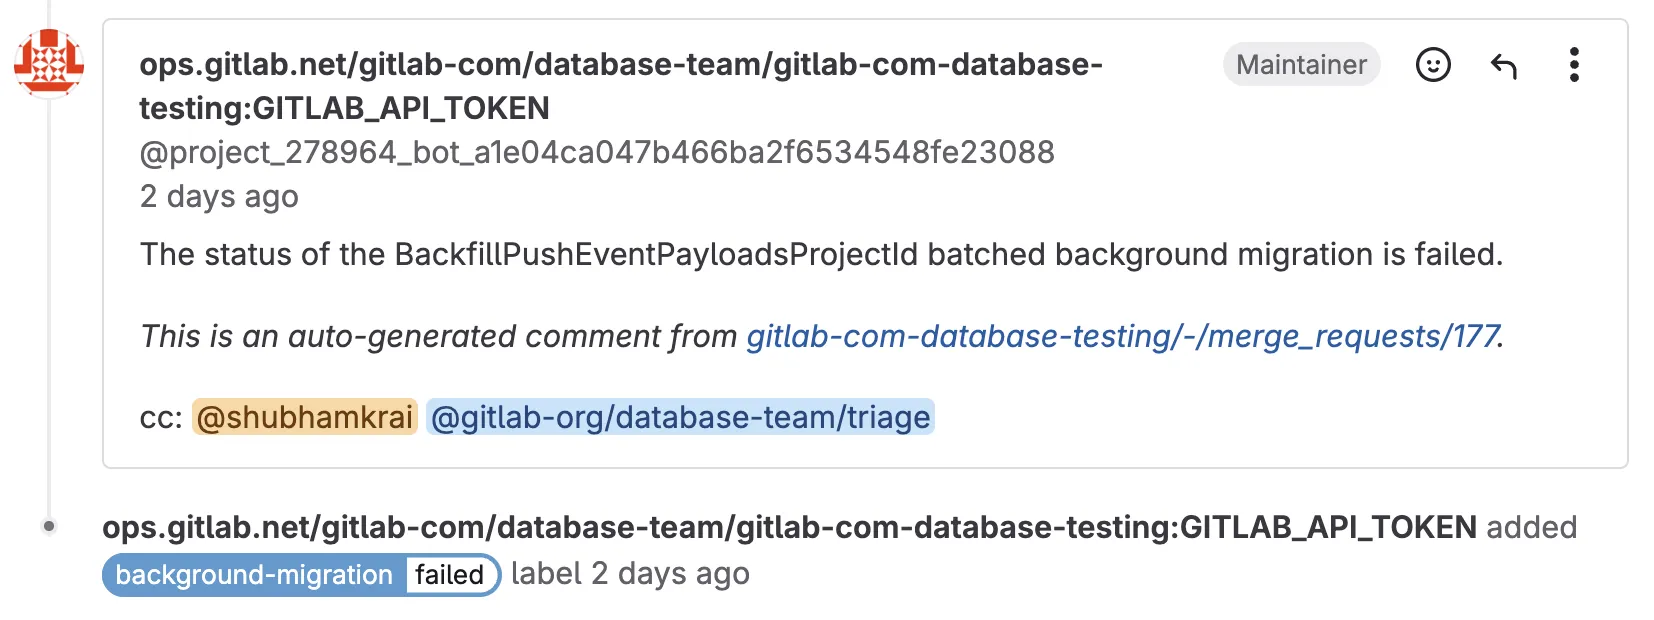
    배치 백그라운드 마이그레이션 실패 알림을 보여 주는 머지 리퀘스트 댓글.

  • #chat-ops-test Slack 채널에서 /chatops gitlab run batched_background_migrations list --job-class-name=<desired_sharding_key_migration_job_name>으로 job 상태를 확인할 수도 있습니다.
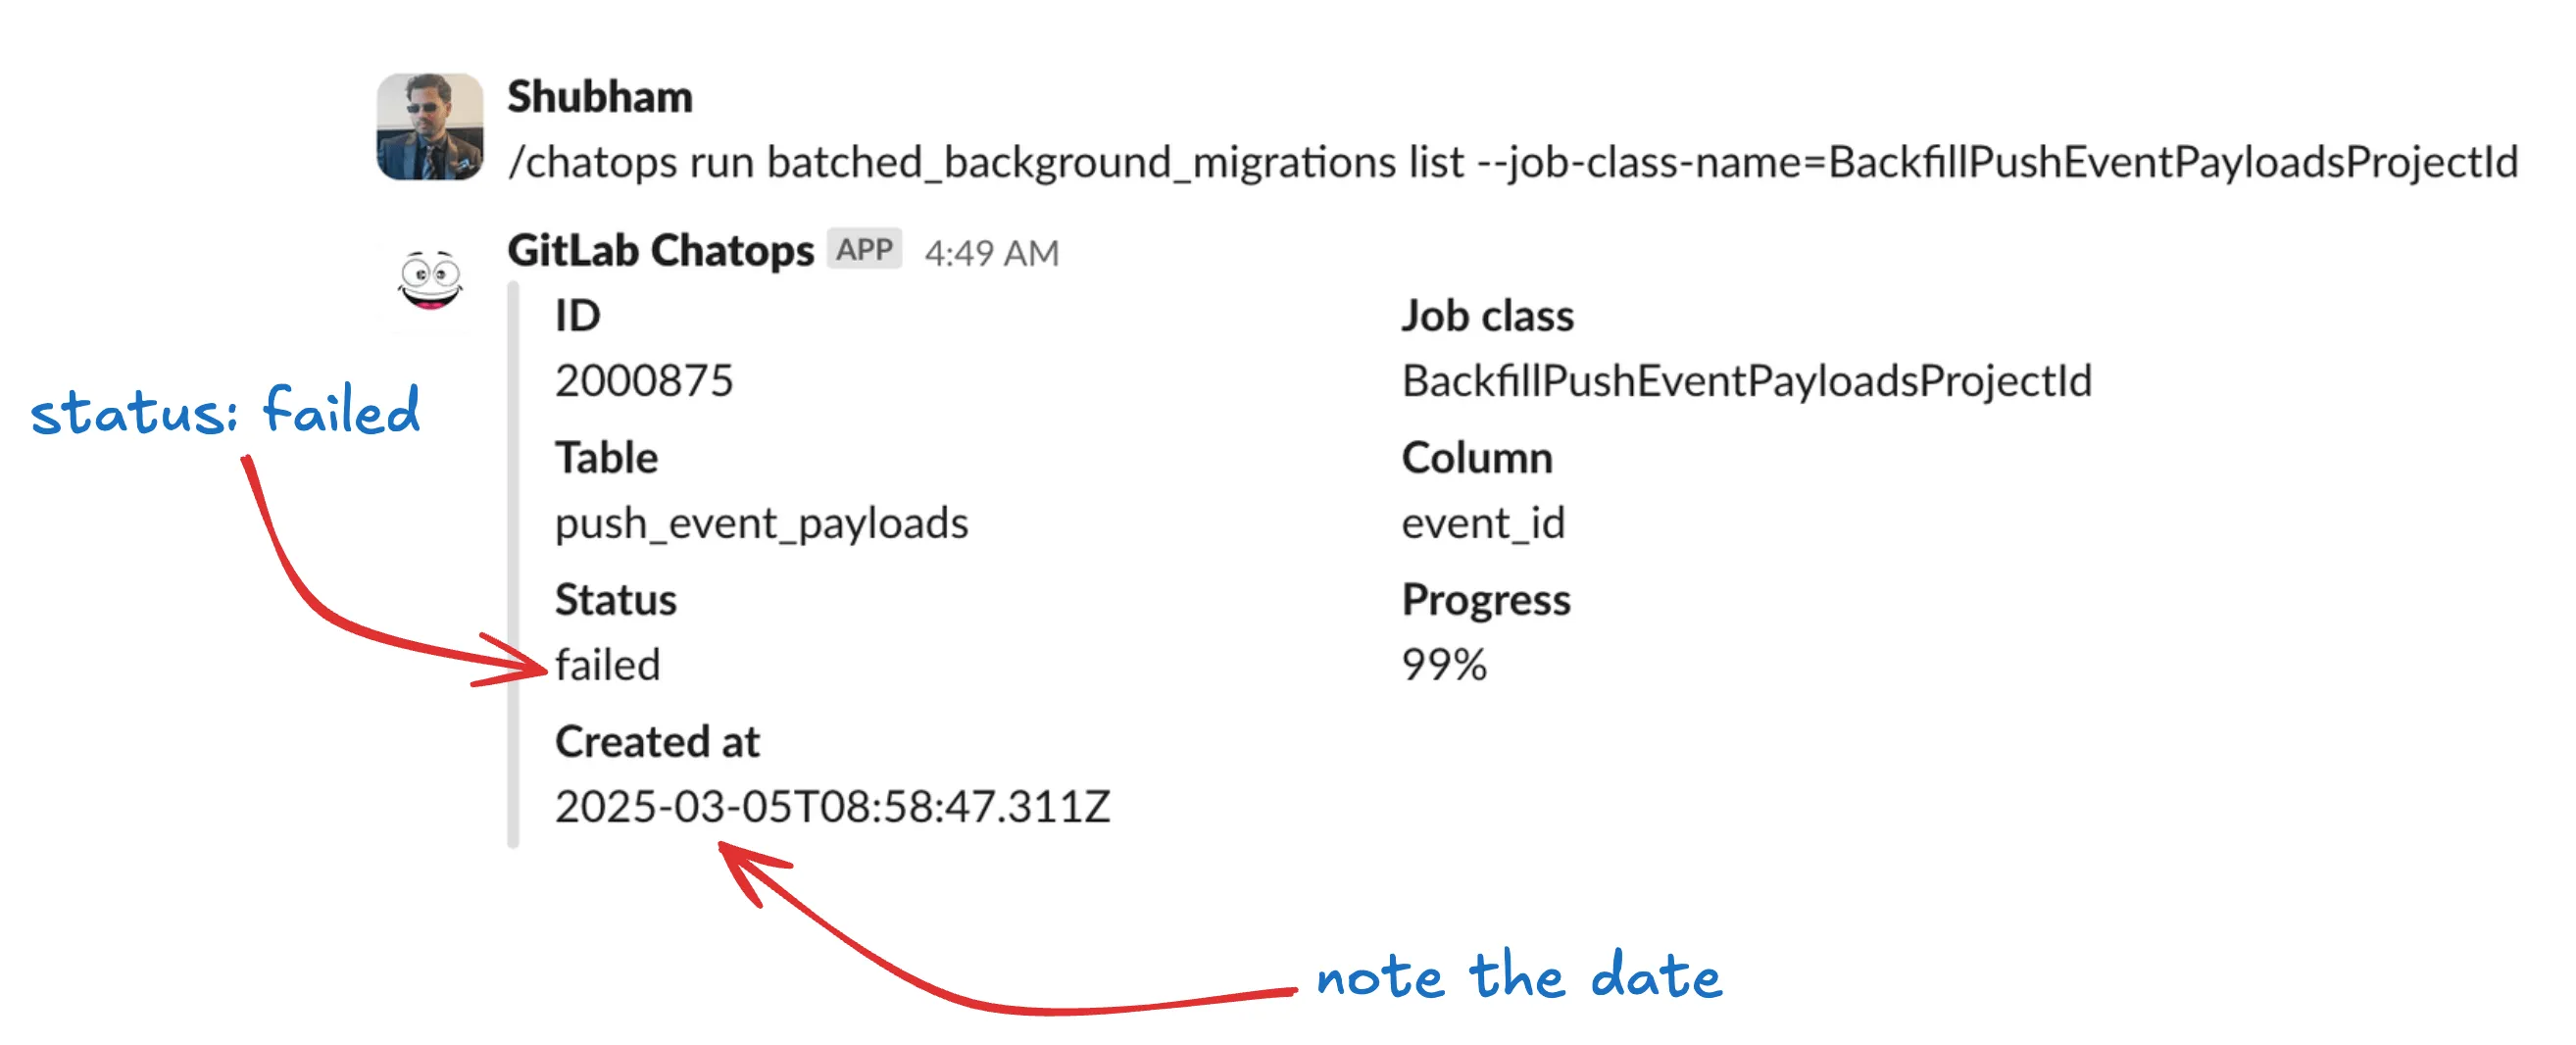
    배치 백그라운드 마이그레이션이 실패한 상태를 보여 주는 ChatOps 출력.

  • Kibana 대시보드로 실패 원인을 파악합니다.

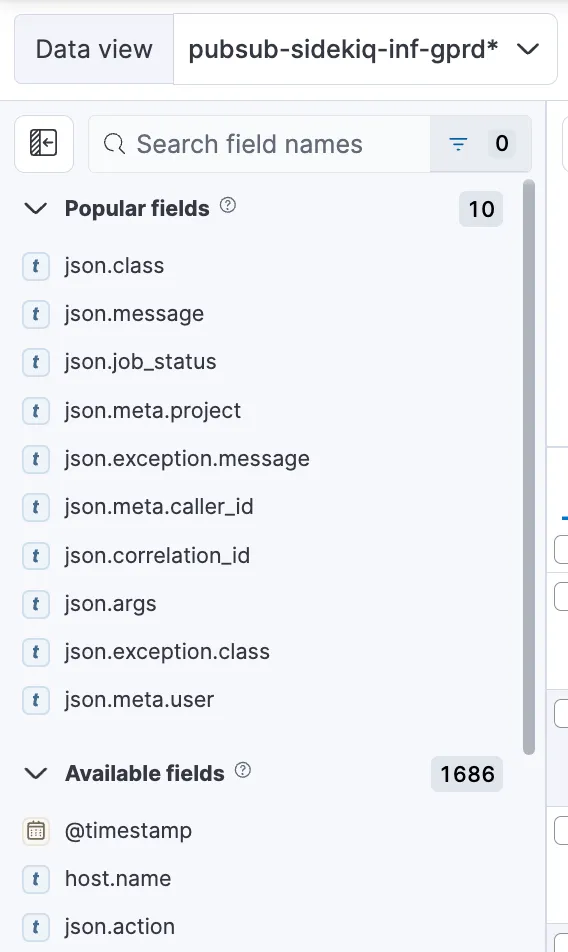
  1. 데이터 뷰가 pubsub-sidekiq-inf-gprd*로 설정되어 있는지 확인합니다.
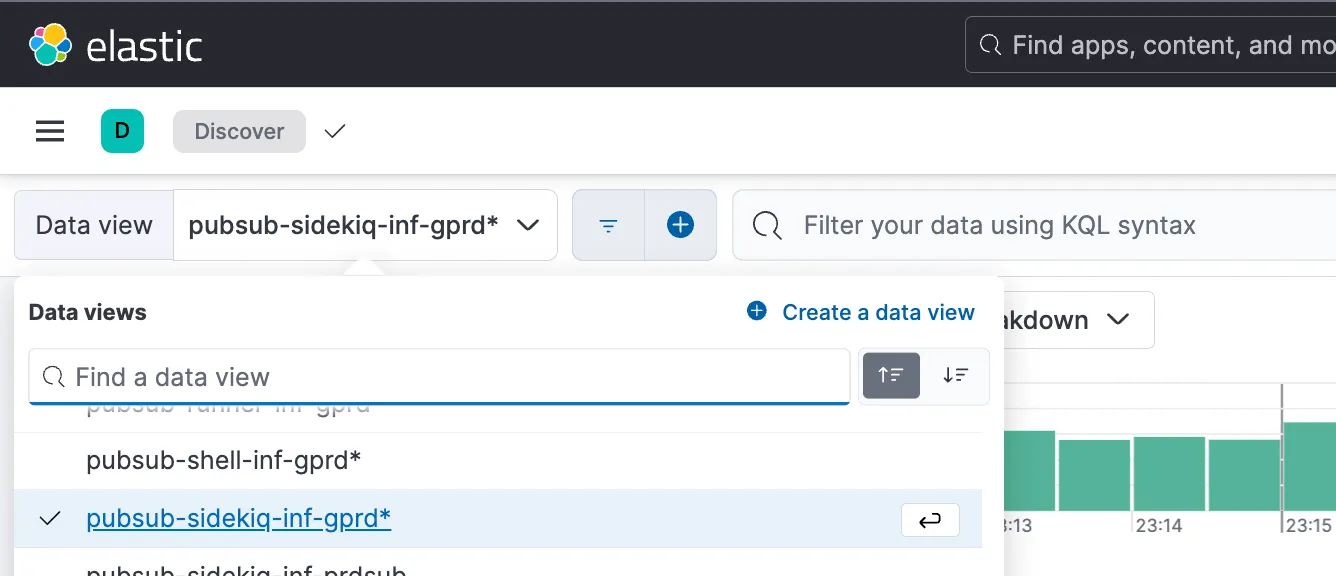
    pubsub Sidekiq 인덱스 패턴이 표시된 Kibana 데이터 뷰 선택기.

  2. 왼쪽에서 사용 가능한 모든 필드를 볼 수 있습니다. 필요한 것은 json.job_class_name, 즉 desired sharding key 마이그레이션 job 이름과 json.new_state: failed뿐입니다.

    job_class_name과 new_state를 포함해 사용 가능한 로그 필드를 보여 주는 Kibana 필드 패널.

  3. 원하는 로그를 얻기 위해 그 필터를 추가합니다.

    검색 조건을 추가할 준비가 된 Kibana 필터 인터페이스.

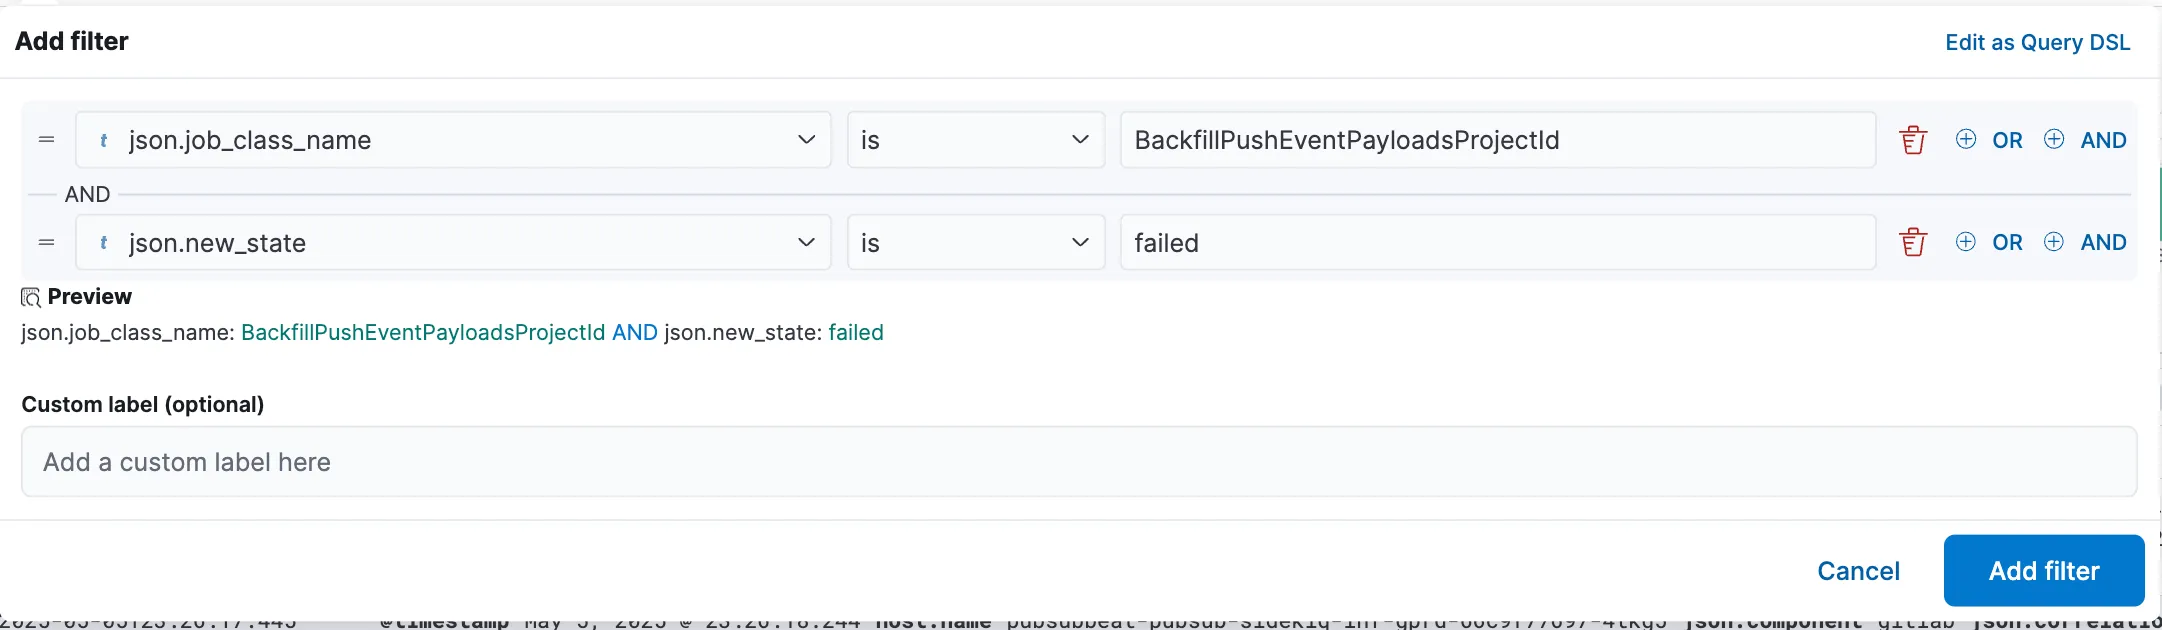
  4. 이 경우 json.job_class_name을 BackfillPushEventPayloadsProjectId로, json.new_state를 failed로 설정하고 필터를 적용합니다.

    job 클래스 이름과 실패 상태 파라미터를 설정하는 Kibana 필터 구성.

  5. 올바른 기간을 선택합니다. 이 마이그레이션은 며칠 전에 실패로 보고되었으므로 최근 7일만 표시하도록 필터링합니다.
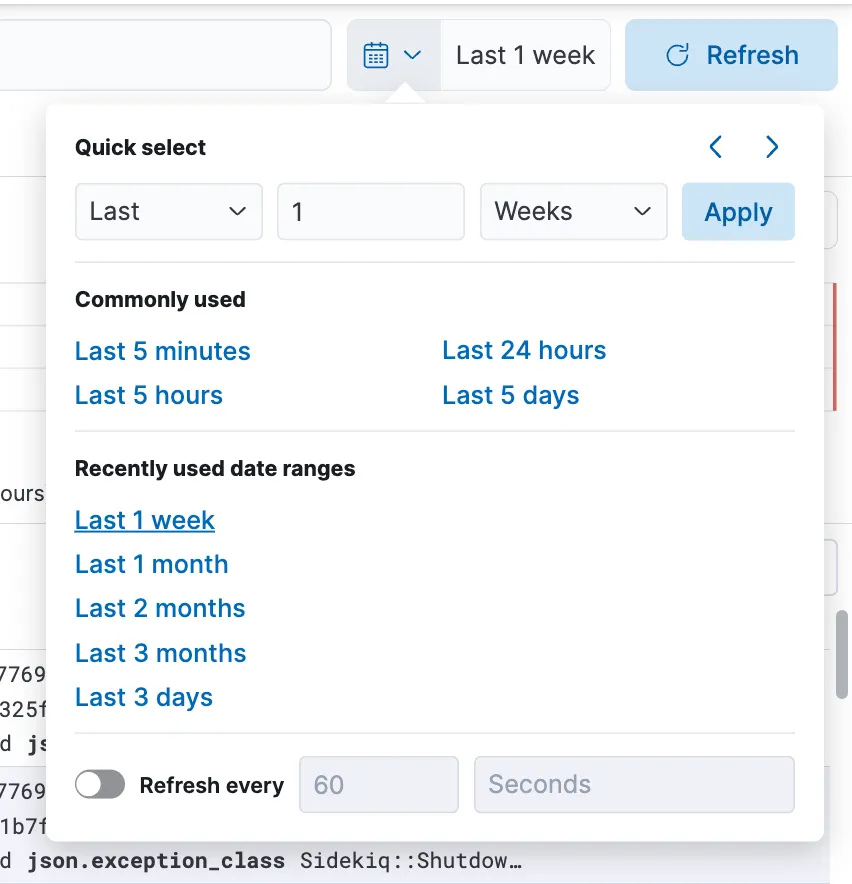
    최근 7일의 로그를 표시하도록 설정된 Kibana 시간 선택기.

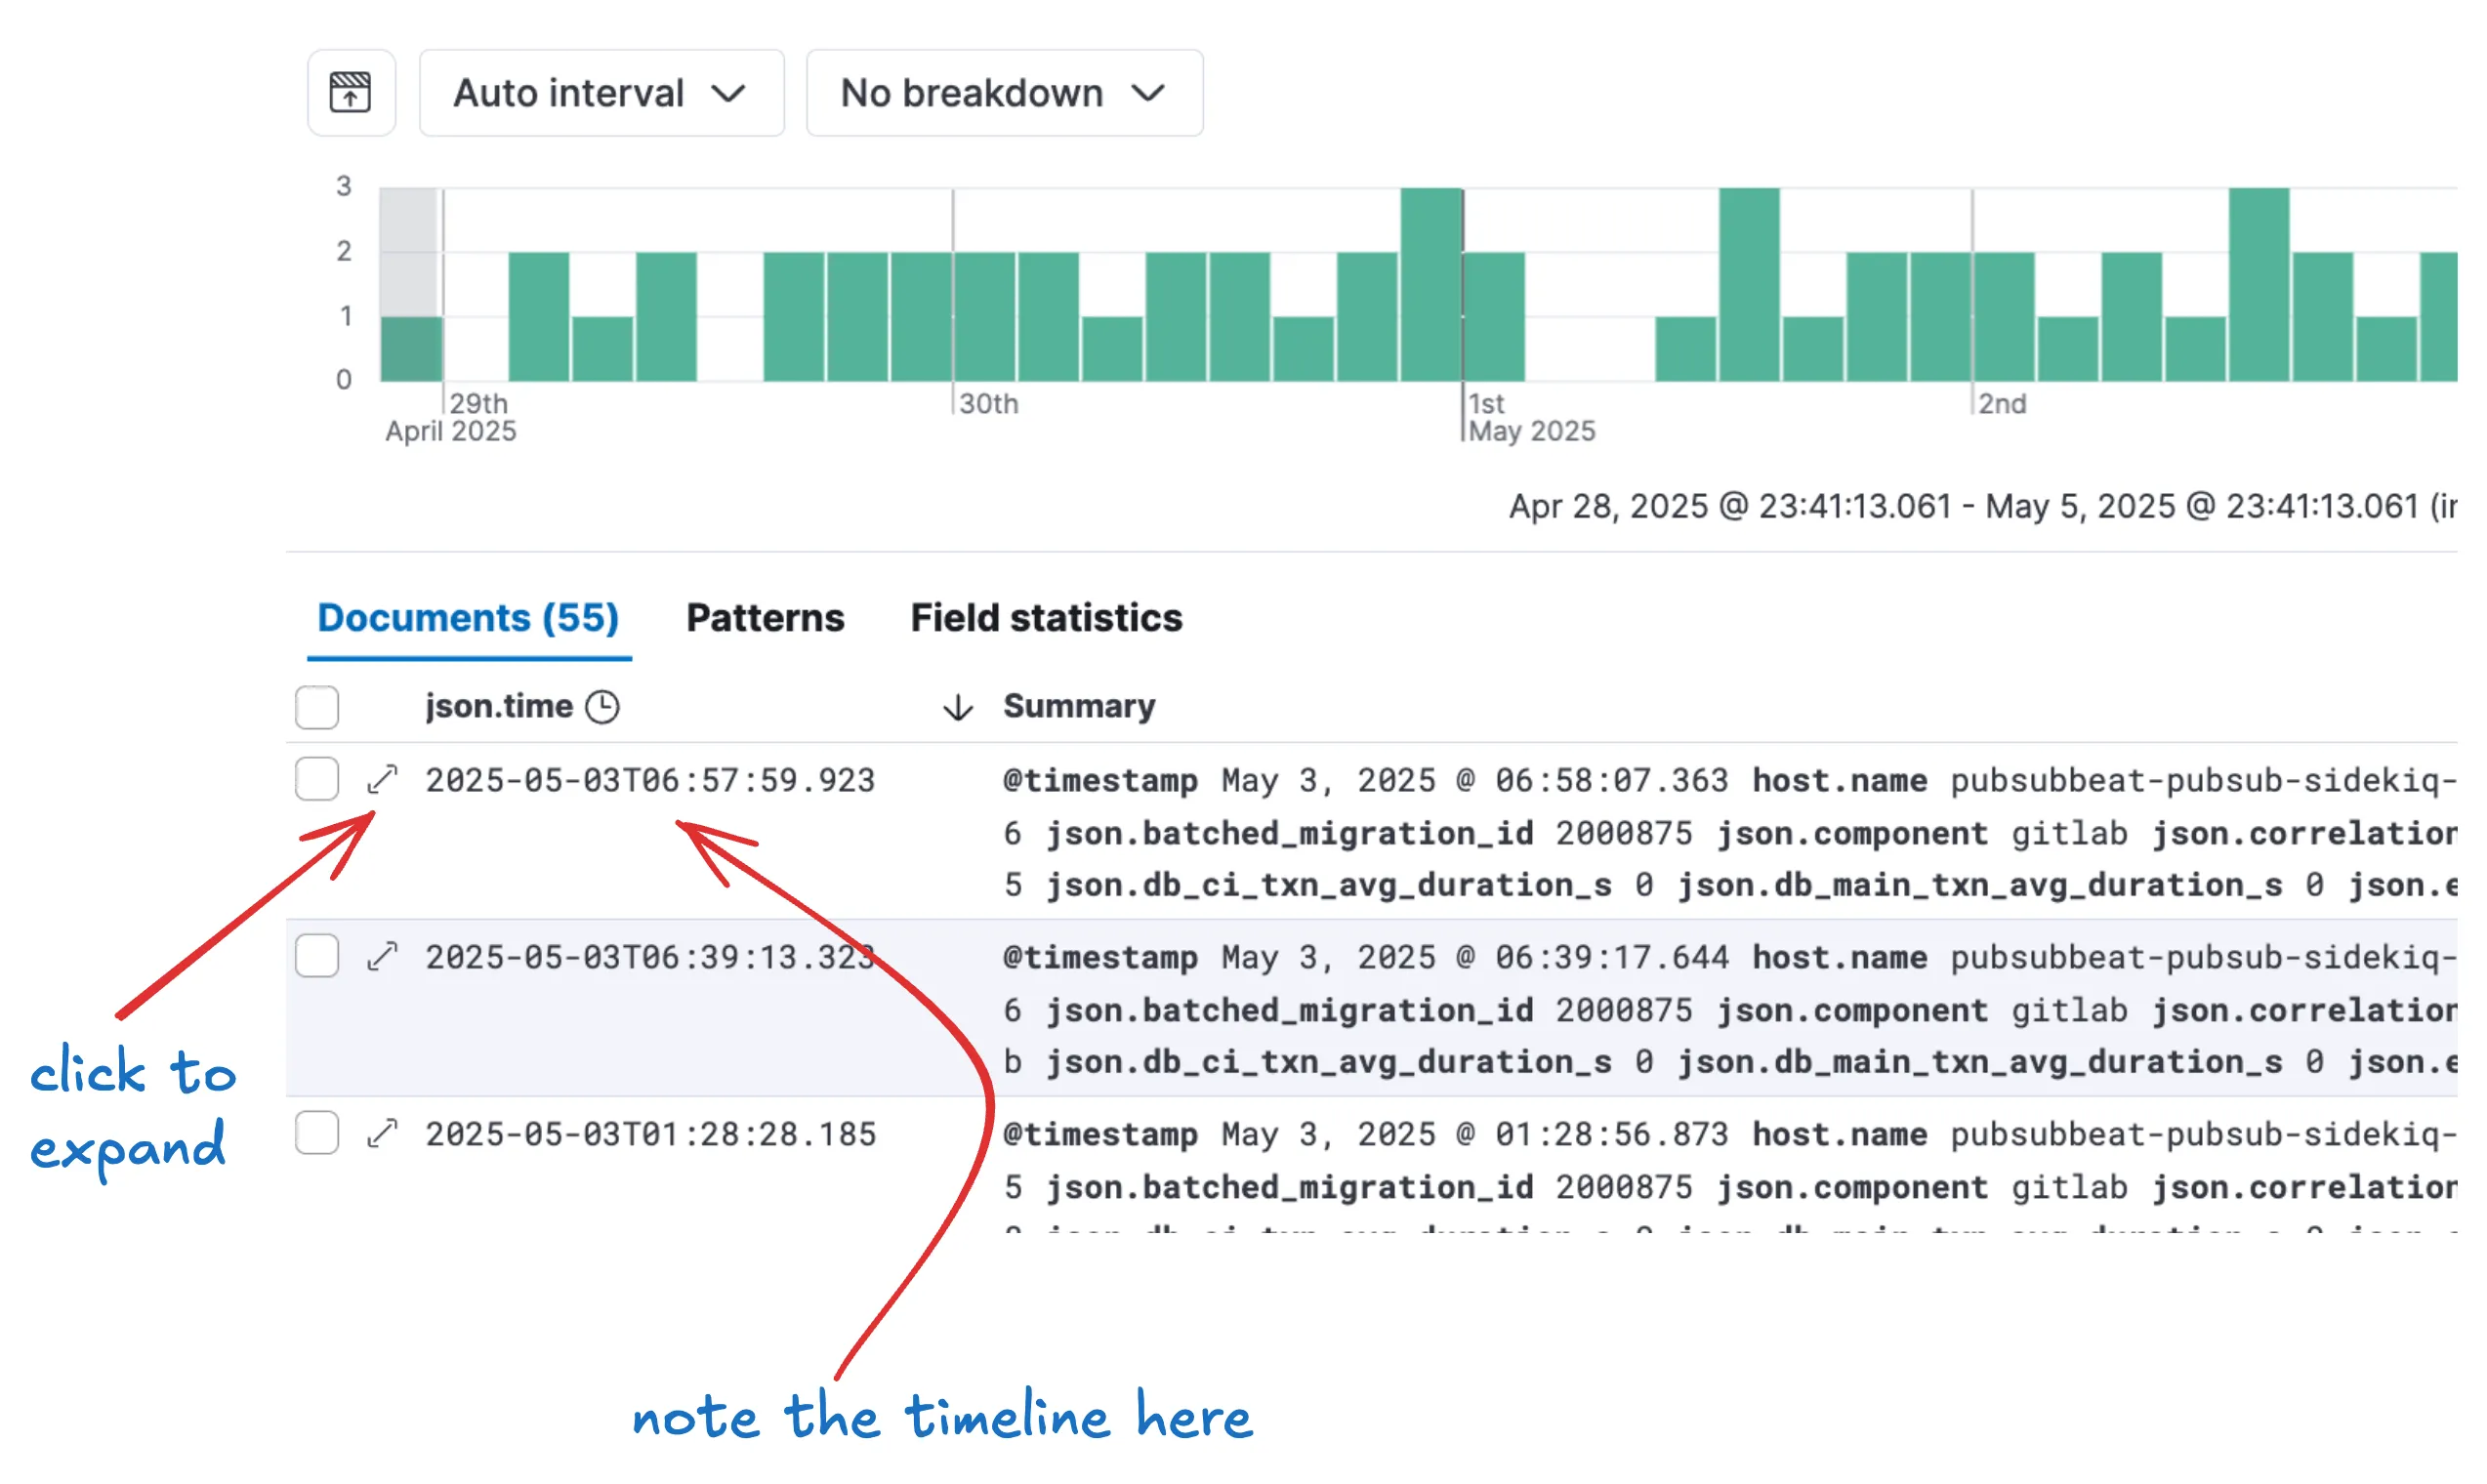
  6. 그러면 추가한 필터가 적용된 원하는 로그가 표시됩니다.

    실패한 마이그레이션 job의 필터링 결과를 보여 주는 Kibana 로그 화면.

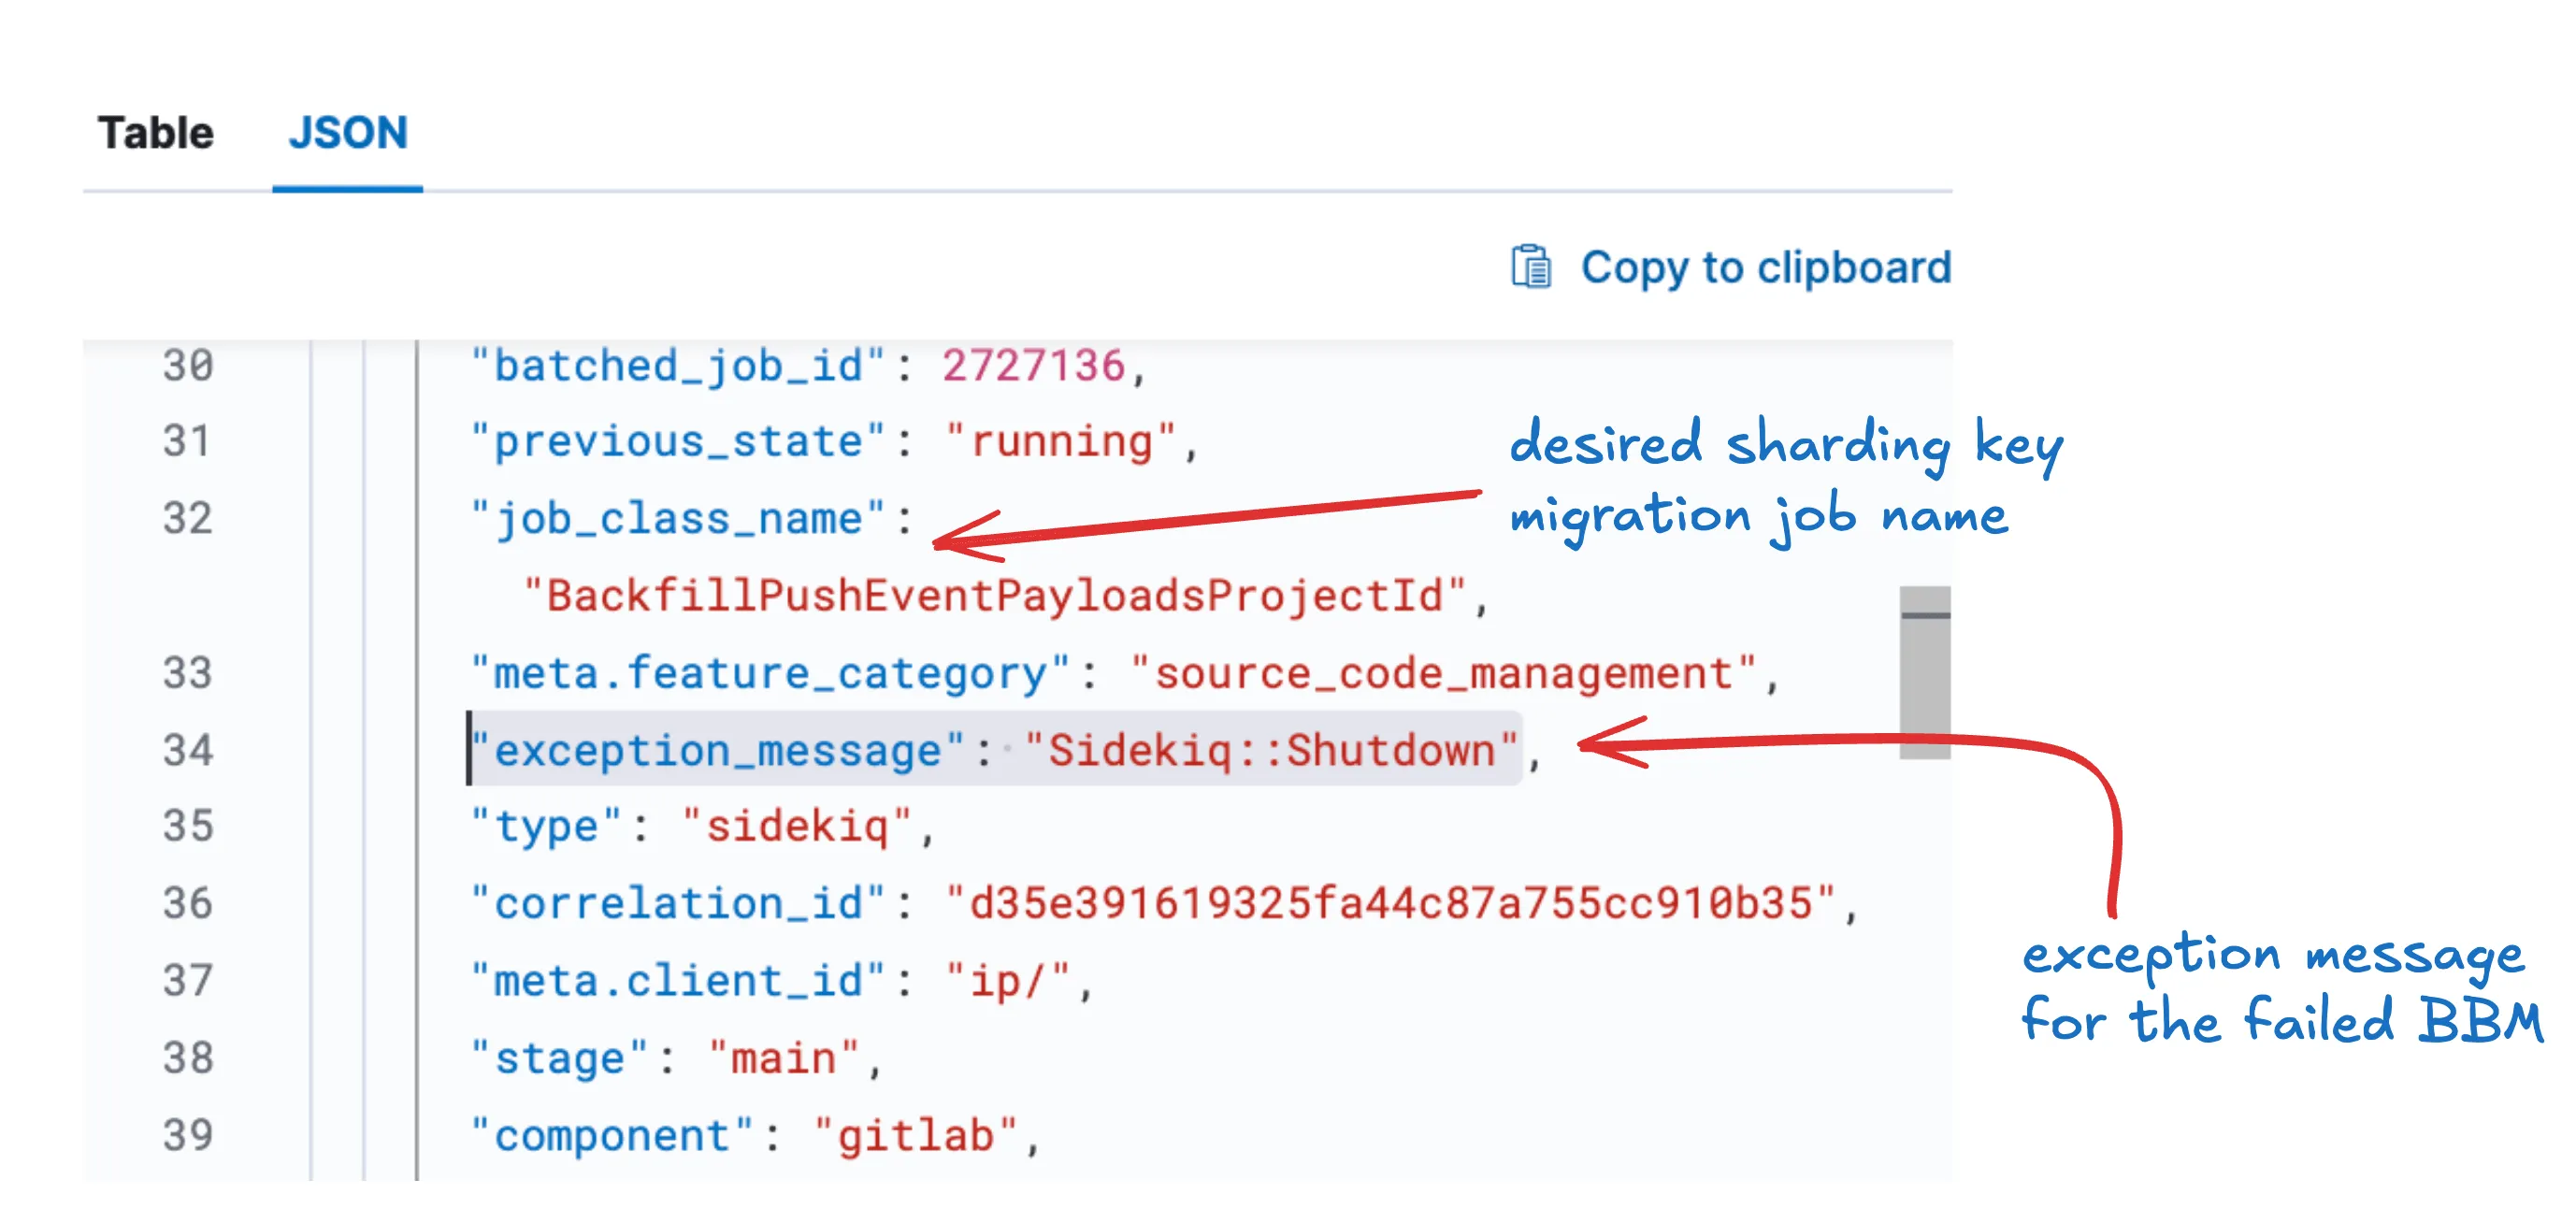
  7. 로그를 펼쳐 json.exception_message를 찾습니다.

    예외 메시지와 오류 세부 정보가 드러난 펼쳐진 Kibana 로그 항목.

  • 보시다시피 이 BBM은 Sidekiq::Shutdown 때문에 실패했습니다.
  • 이를 해결하려면 마이그레이션을 다시 큐에 넣으면 됩니다.

Grafana 사용

로그는 7일까지만 보관하므로 Kibana에서 아무것도 찾지 못할 때가 있습니다. 이 경우 Grafana 대시보드를 사용할 수 있습니다.

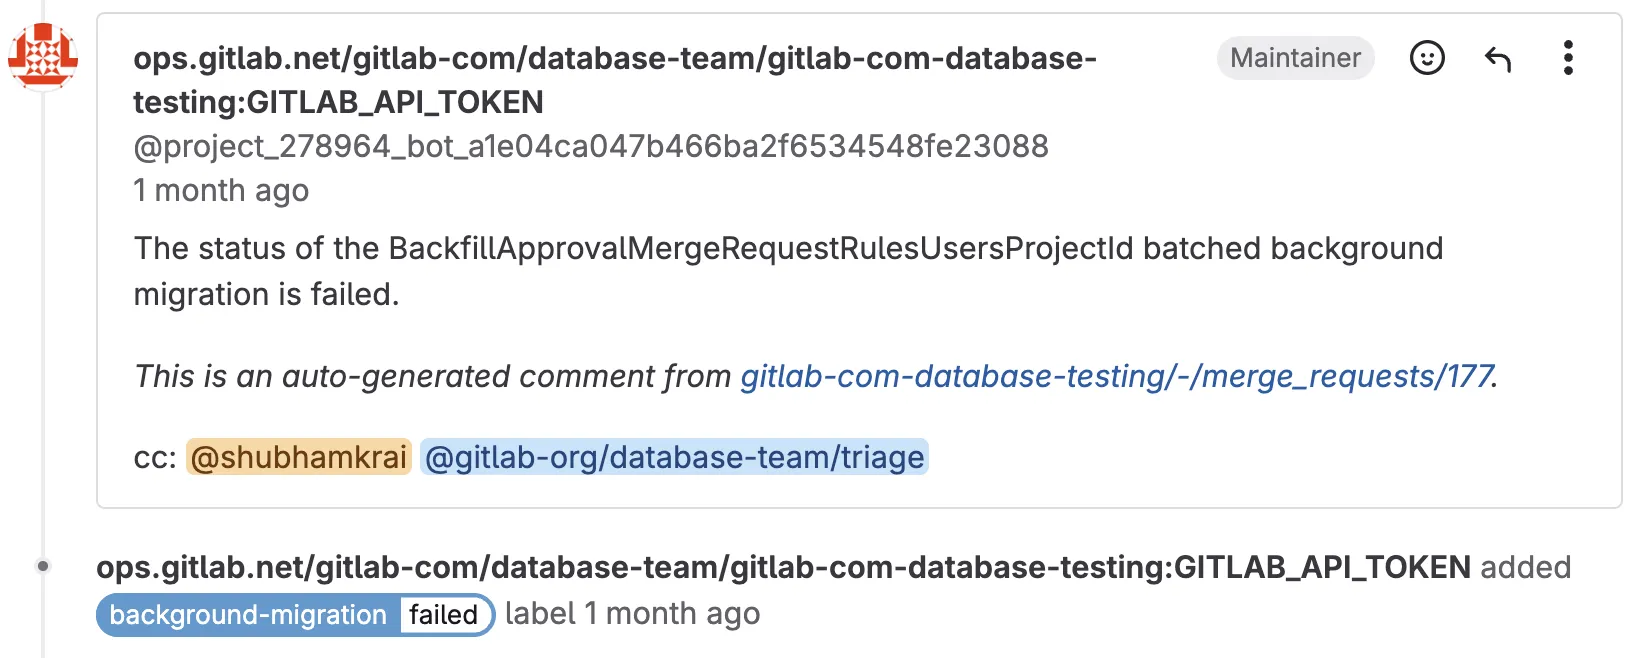
최근의 BackfillApprovalMergeRequestRulesUsersProjectId BBM 실패를 예로 듭니다.

  • 원래 MR에서 태그됩니다.

    마이그레이션 실패에 관해 팀원을 태그하는 머지 리퀘스트 댓글.

  1. #chat-ops-test Slack 채널에서 /chatops gitlab run batched_background_migrations list --job-class-name=<desired_sharding_key_migration_job_name>으로 job 상태를 확인할 수도 있습니다.
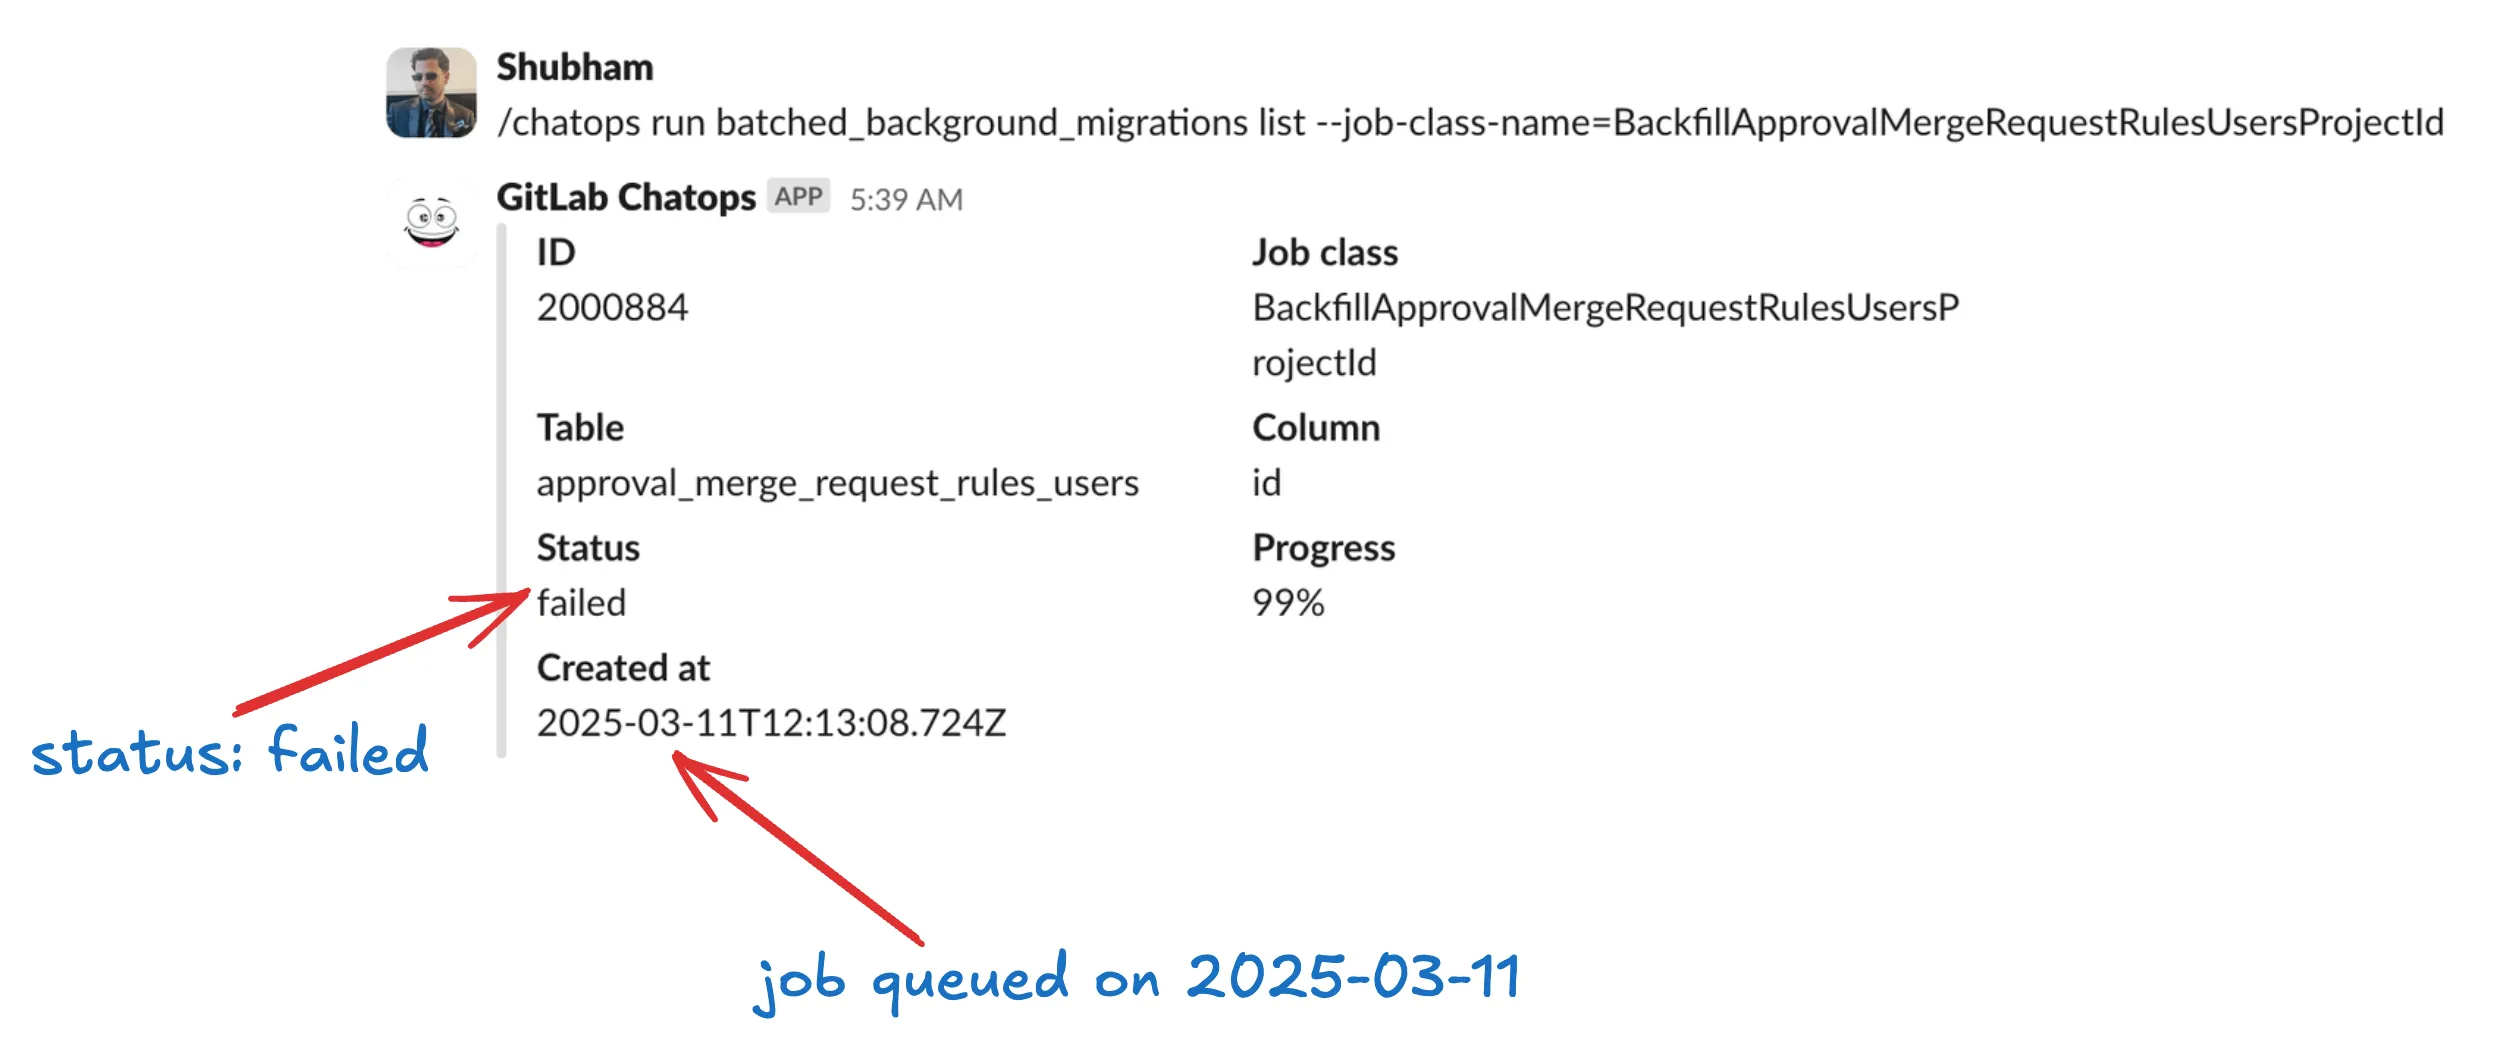
    실패한 마이그레이션 상태와 진행 세부 정보를 보여 주는 ChatOps 명령 출력.

  2. Kibana 대시보드를 확인합니다. 이 job에는 로그가 없습니다.

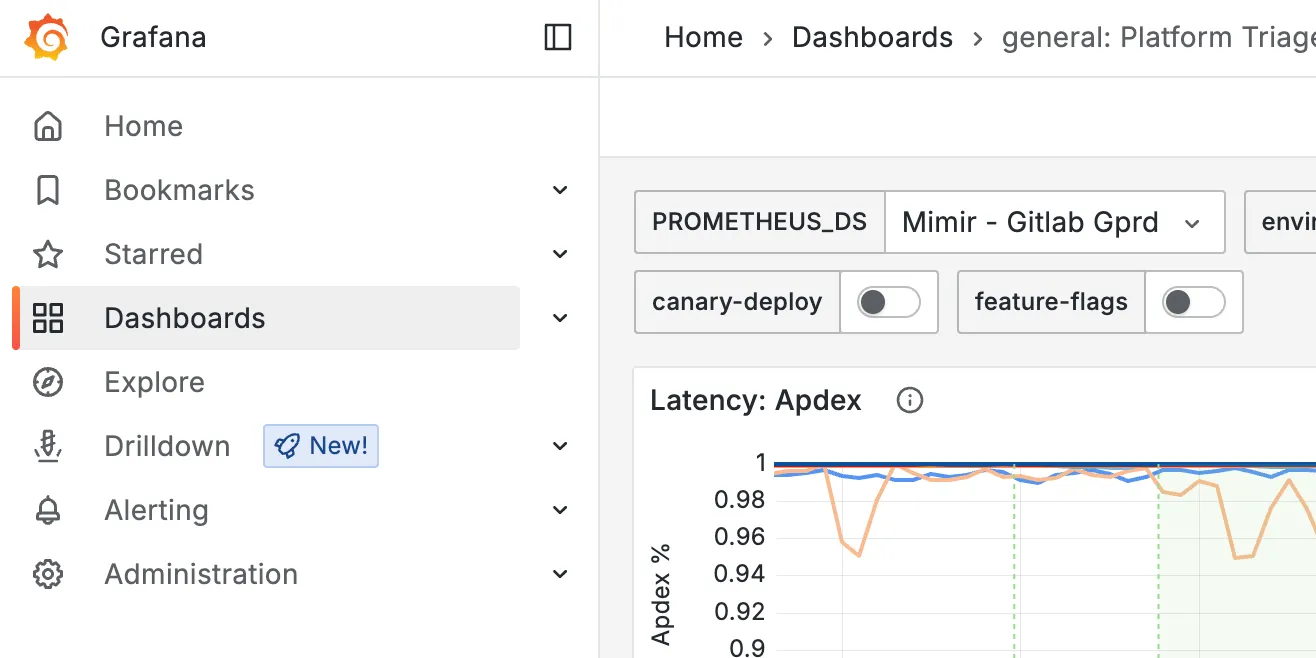
  3. Grafana 대시보드로 이동합니다.

    내비게이션 옵션과 Explore 기능이 있는 Grafana 홈페이지.

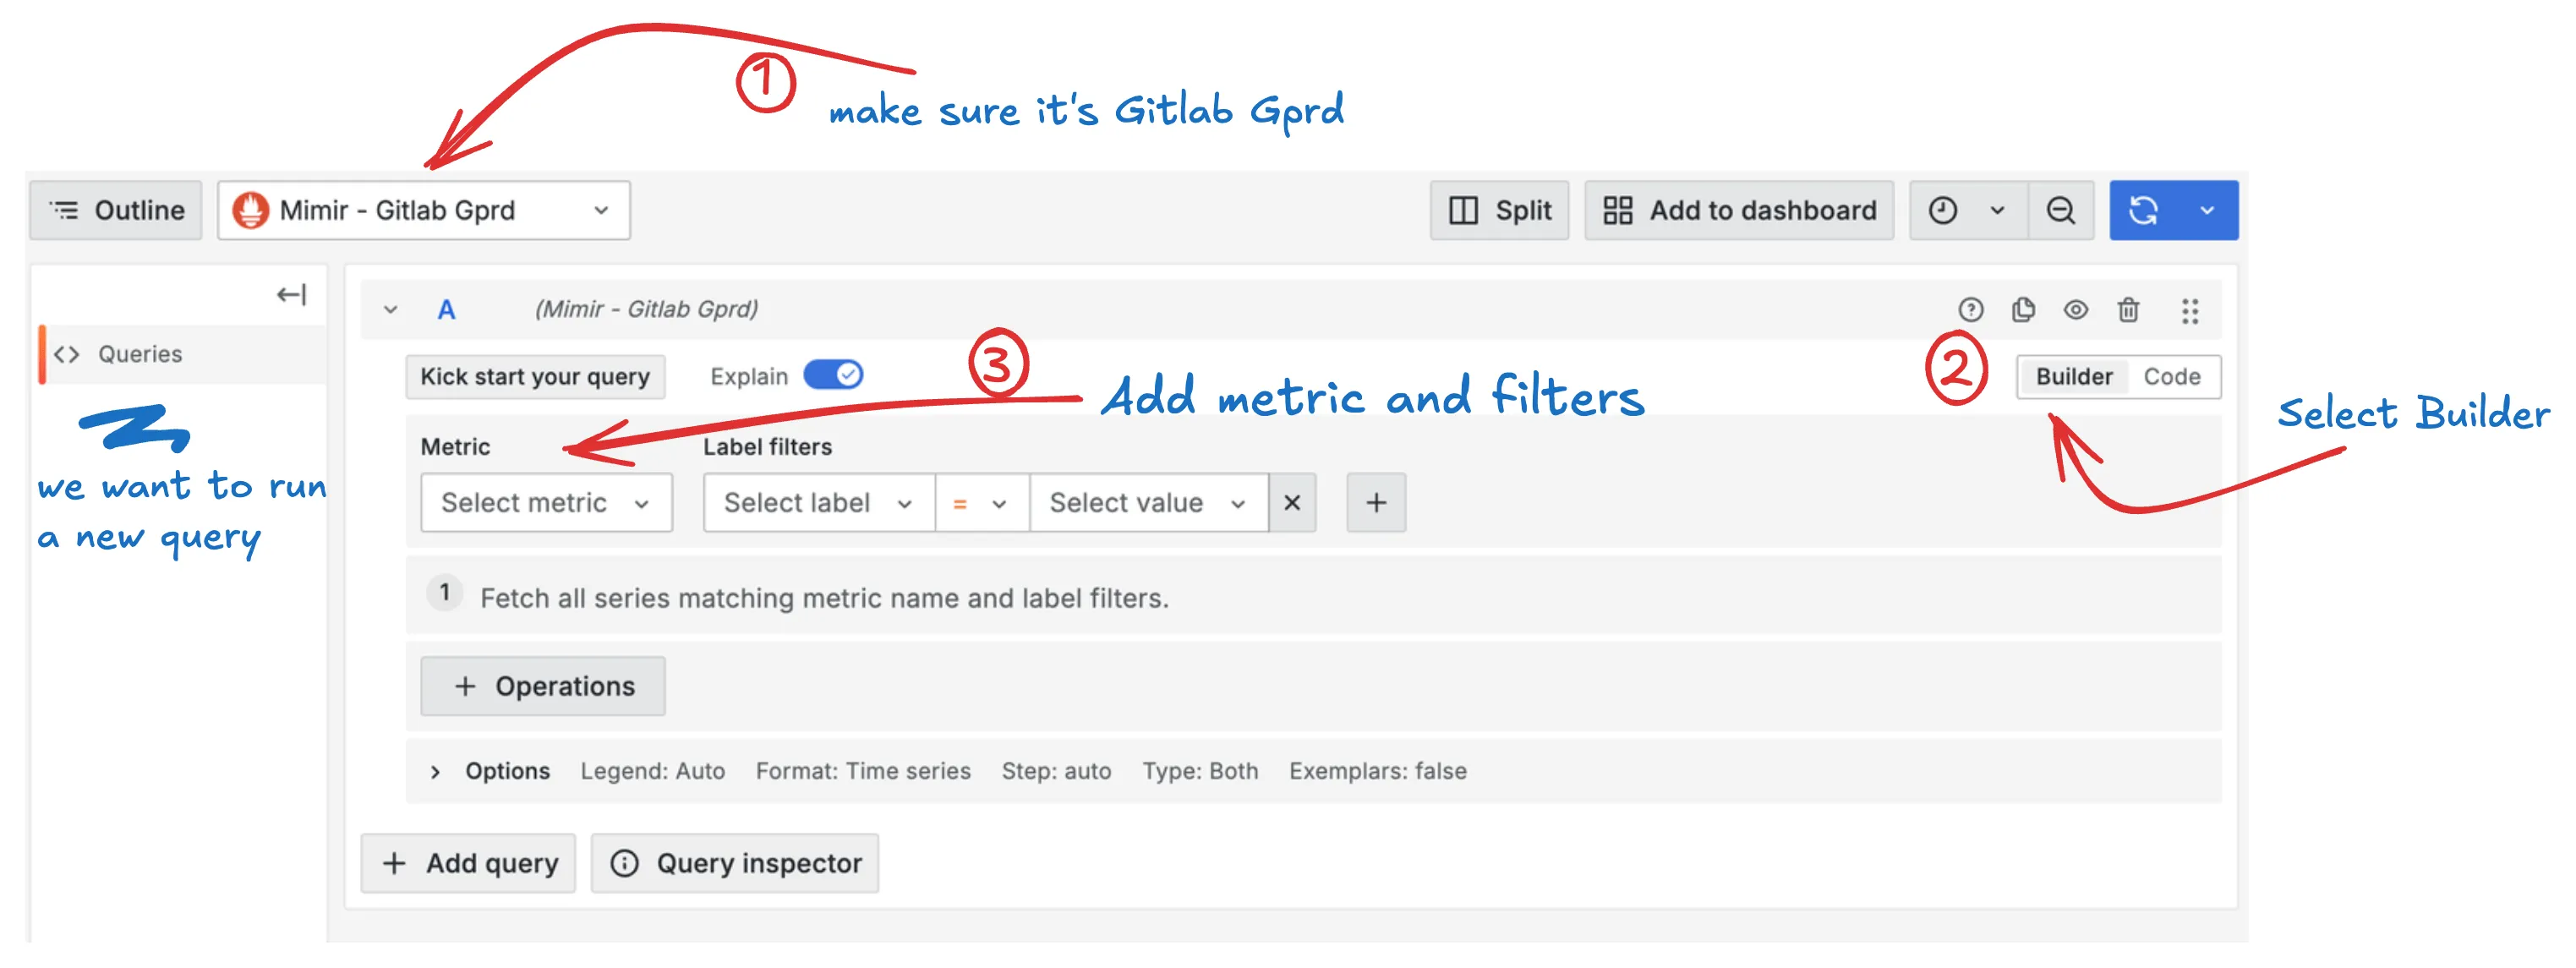
  4. Explore를 클릭하고 새 쿼리를 추가합니다.

    메트릭과 기간을 위한 쿼리 빌더가 있는 Grafana Explore 화면.

  5. 샤딩 키 실패를 디버깅하는 가장 쉬운 방법은 테이블 크기 이상을 확인하는 것입니다.
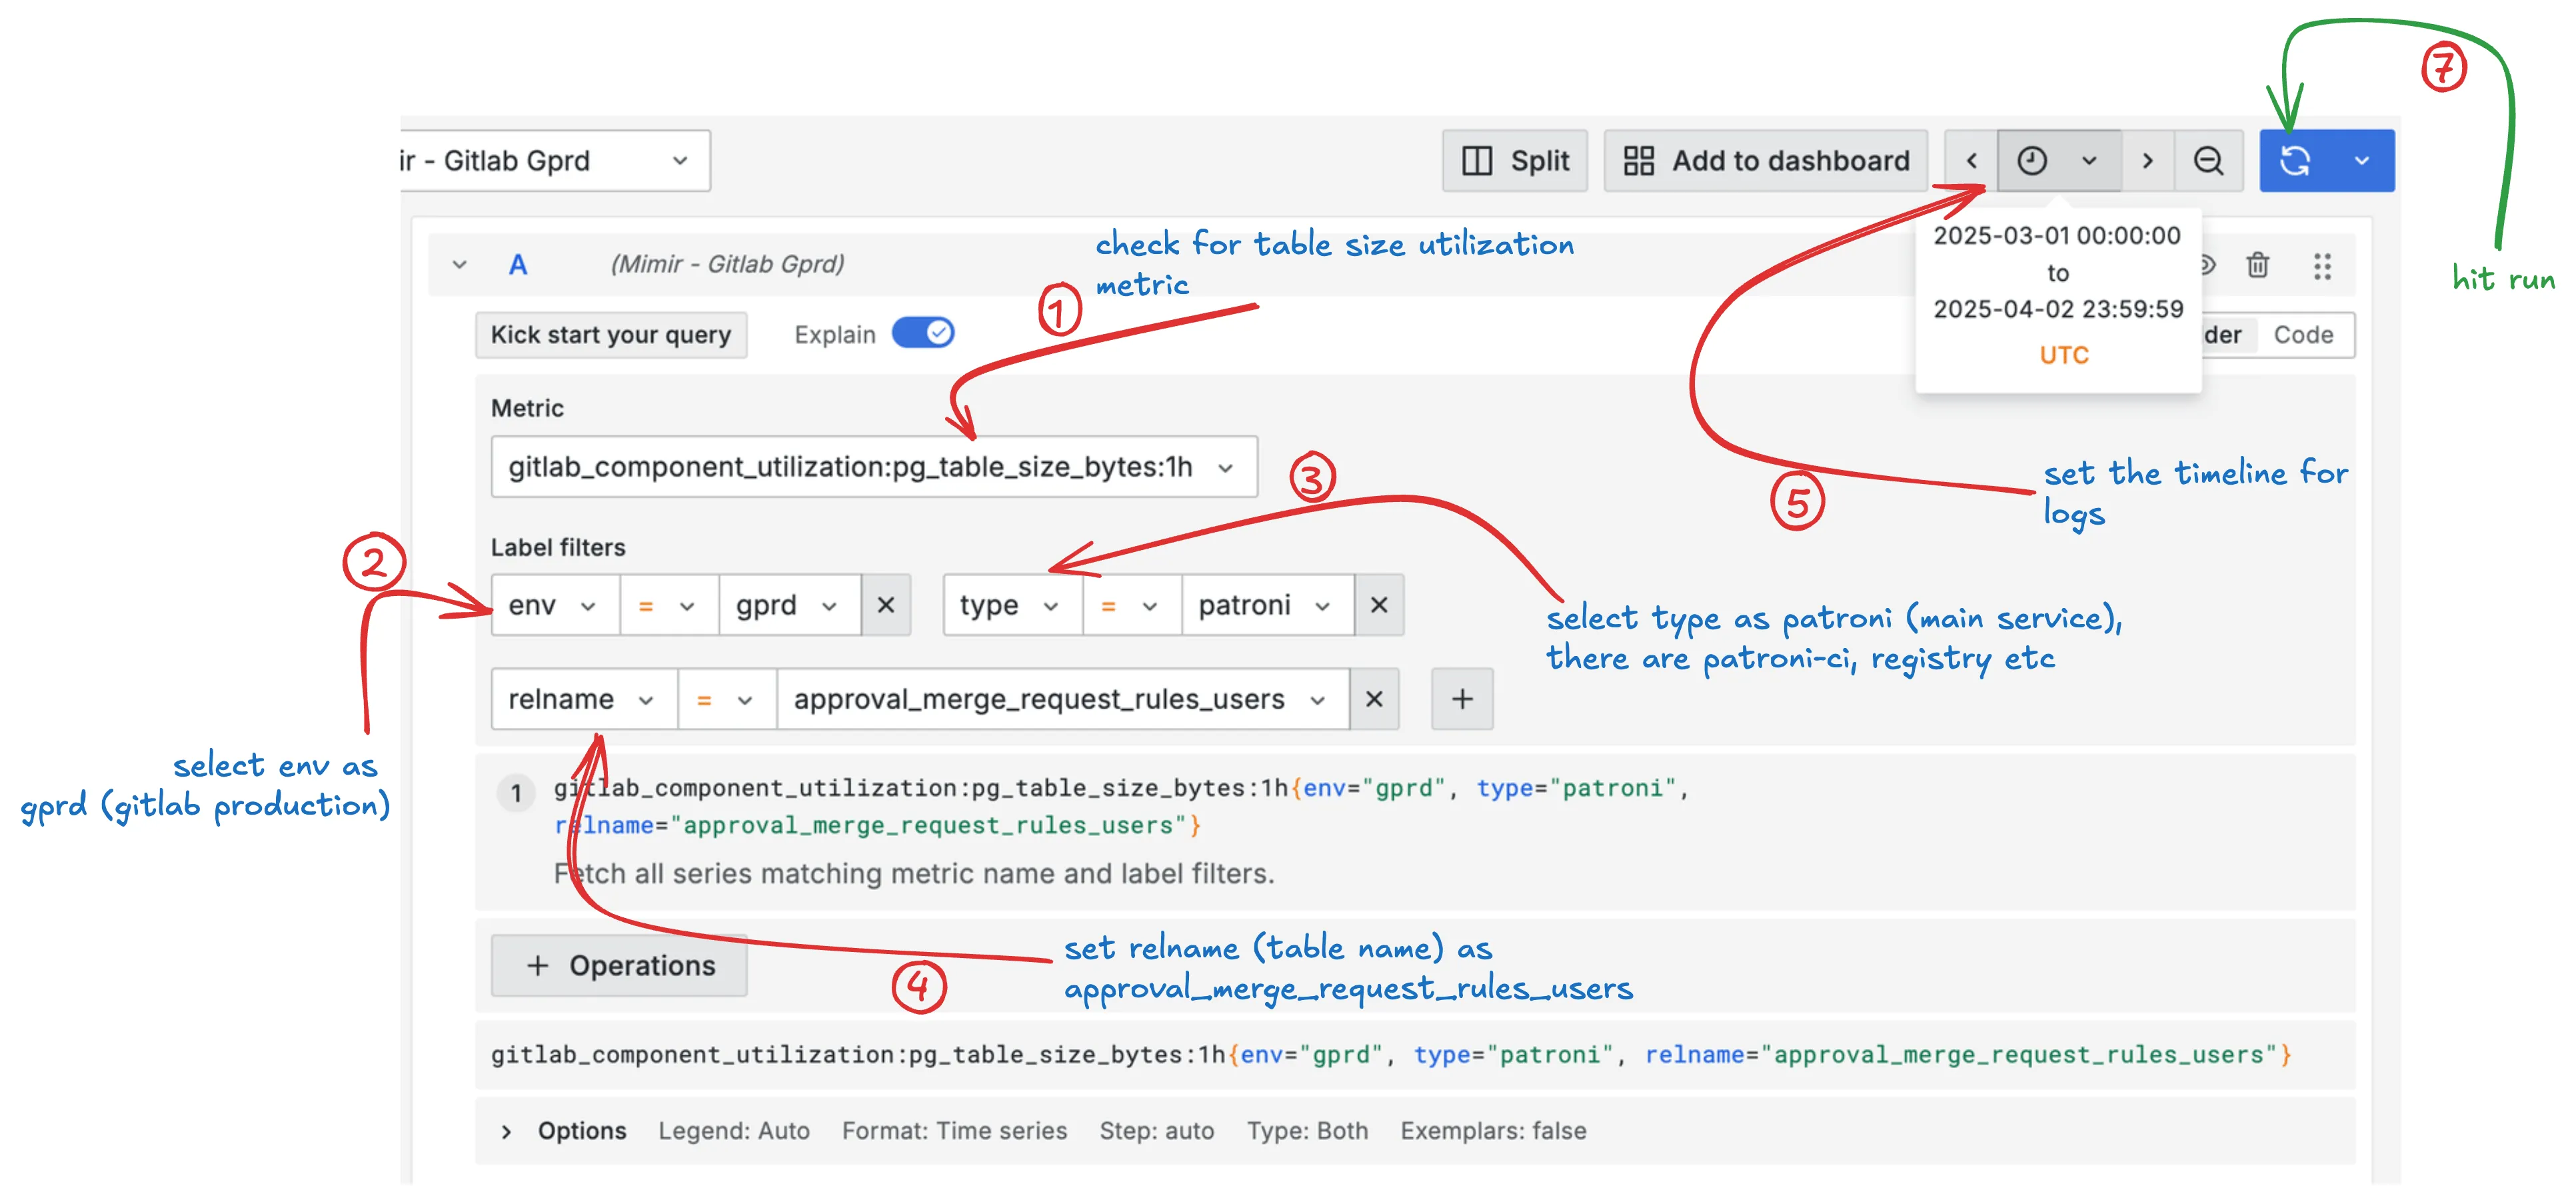
    테이블 크기 메트릭과 레이블 필터를 보여 주는 Grafana 메트릭 브라우저.

  • 메트릭: gitlab_component_utilization:pg_table_size_bytes:1h.
  • 레이블 필터:
    • env: gprd.
    • type: patroni.
    • relname: approval_merge_request_rules_users.
  1. 기간: job 생성 날짜보다 최소 며칠 앞선 시점부터 선택합니다. MR에서 실패가 2025-03-31에 보고되었고 job은 2025-03-11에 생성된 것을 볼 수 있습니다. 기간은 2025-03-01부터 2025-04-02까지로 선택했습니다. 상황에 맞게 조정할 수 있습니다.

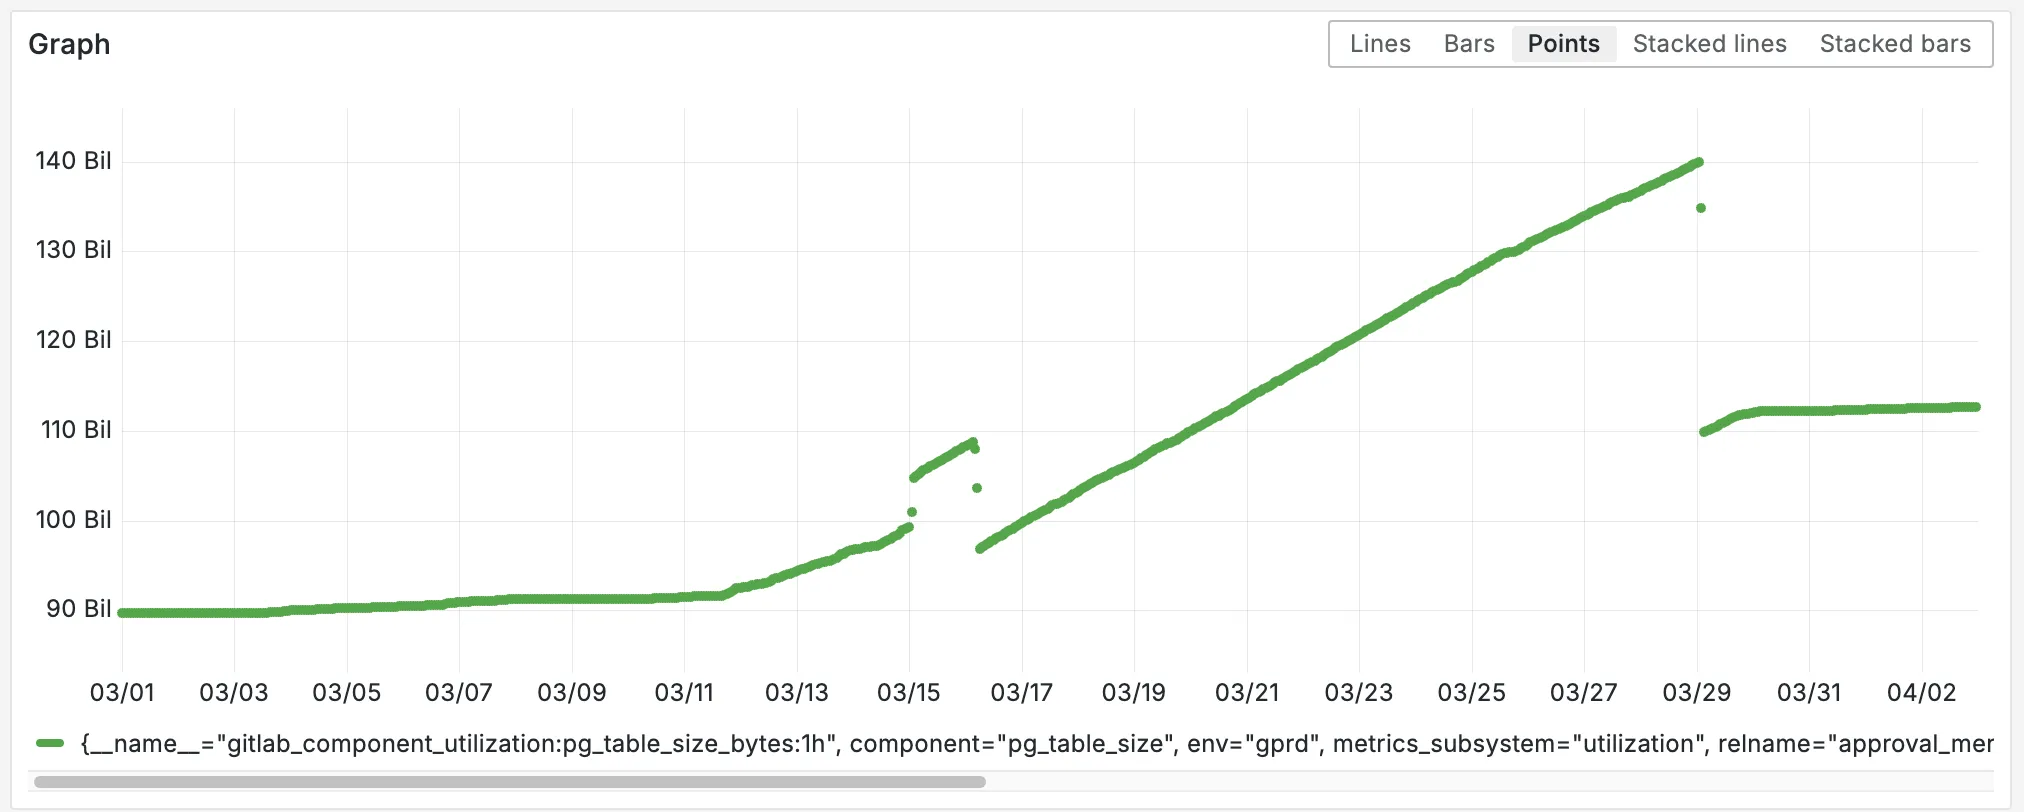
  2. 쿼리를 실행하면 선택한 기간에 대한 그래프가 생성됩니다.

    2025년 3월 초부터 90 GB 기준선을 보여 주는 Grafana 테이블 크기 그래프.

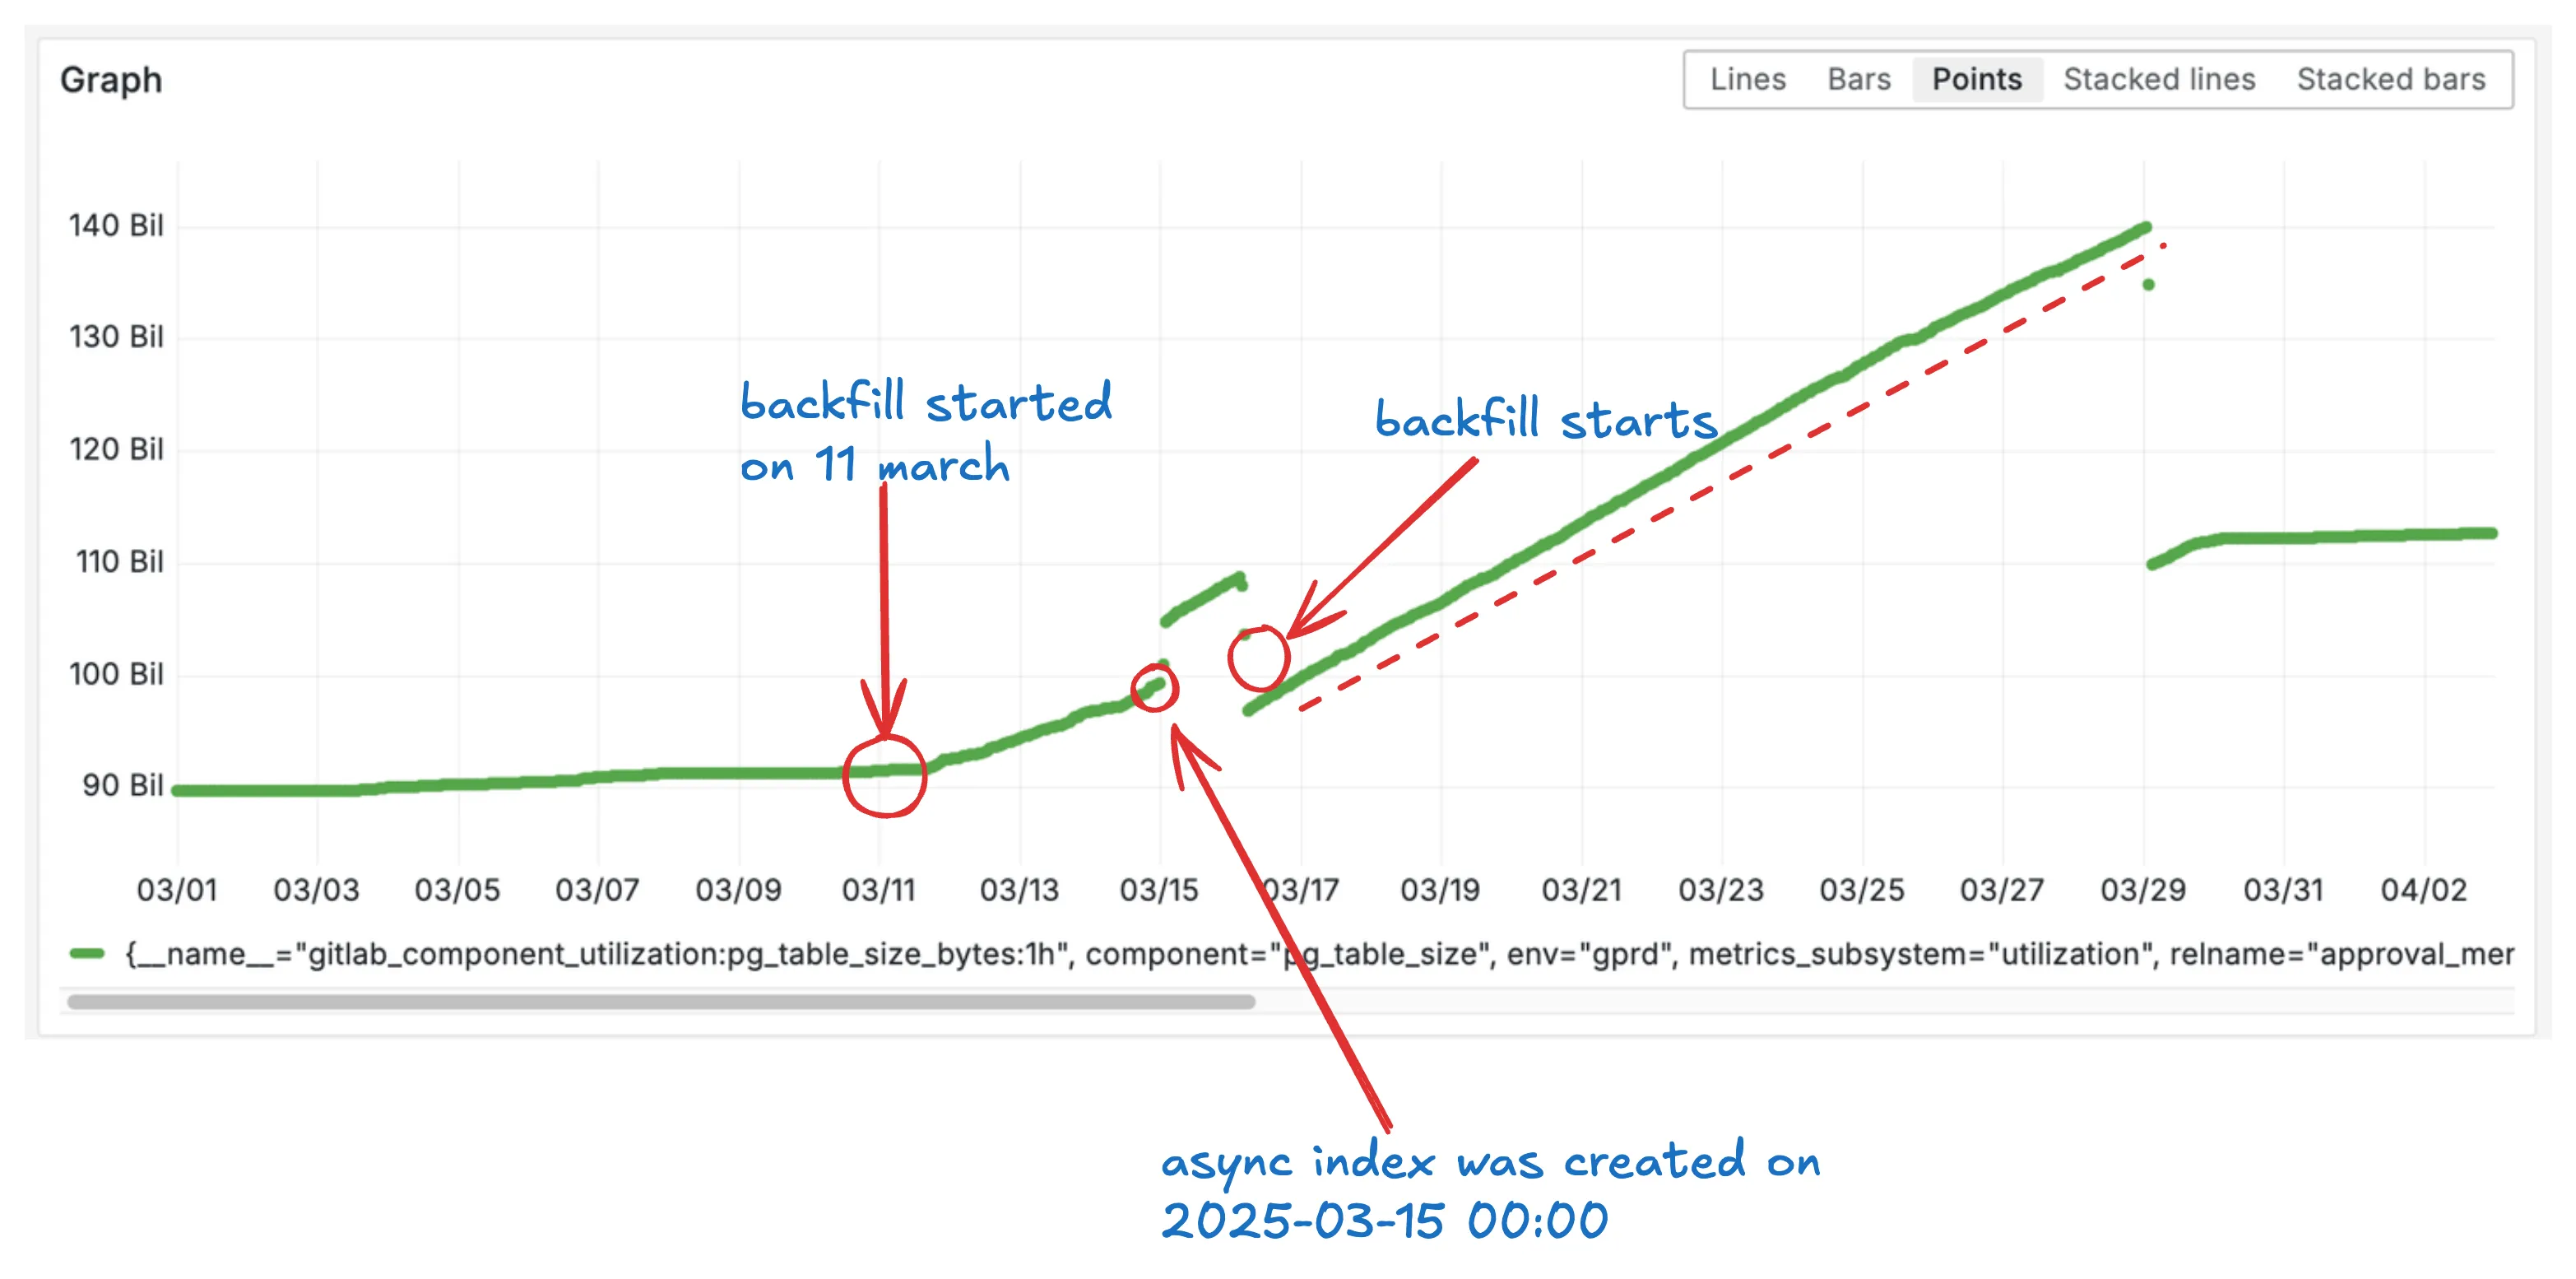
  3. 이 그래프를 해석합니다. 백필 job은 2025-03-11에 시작되었습니다. 이 날짜부터 테이블 크기가 조금씩 증가하는 것을 볼 수 있습니다.
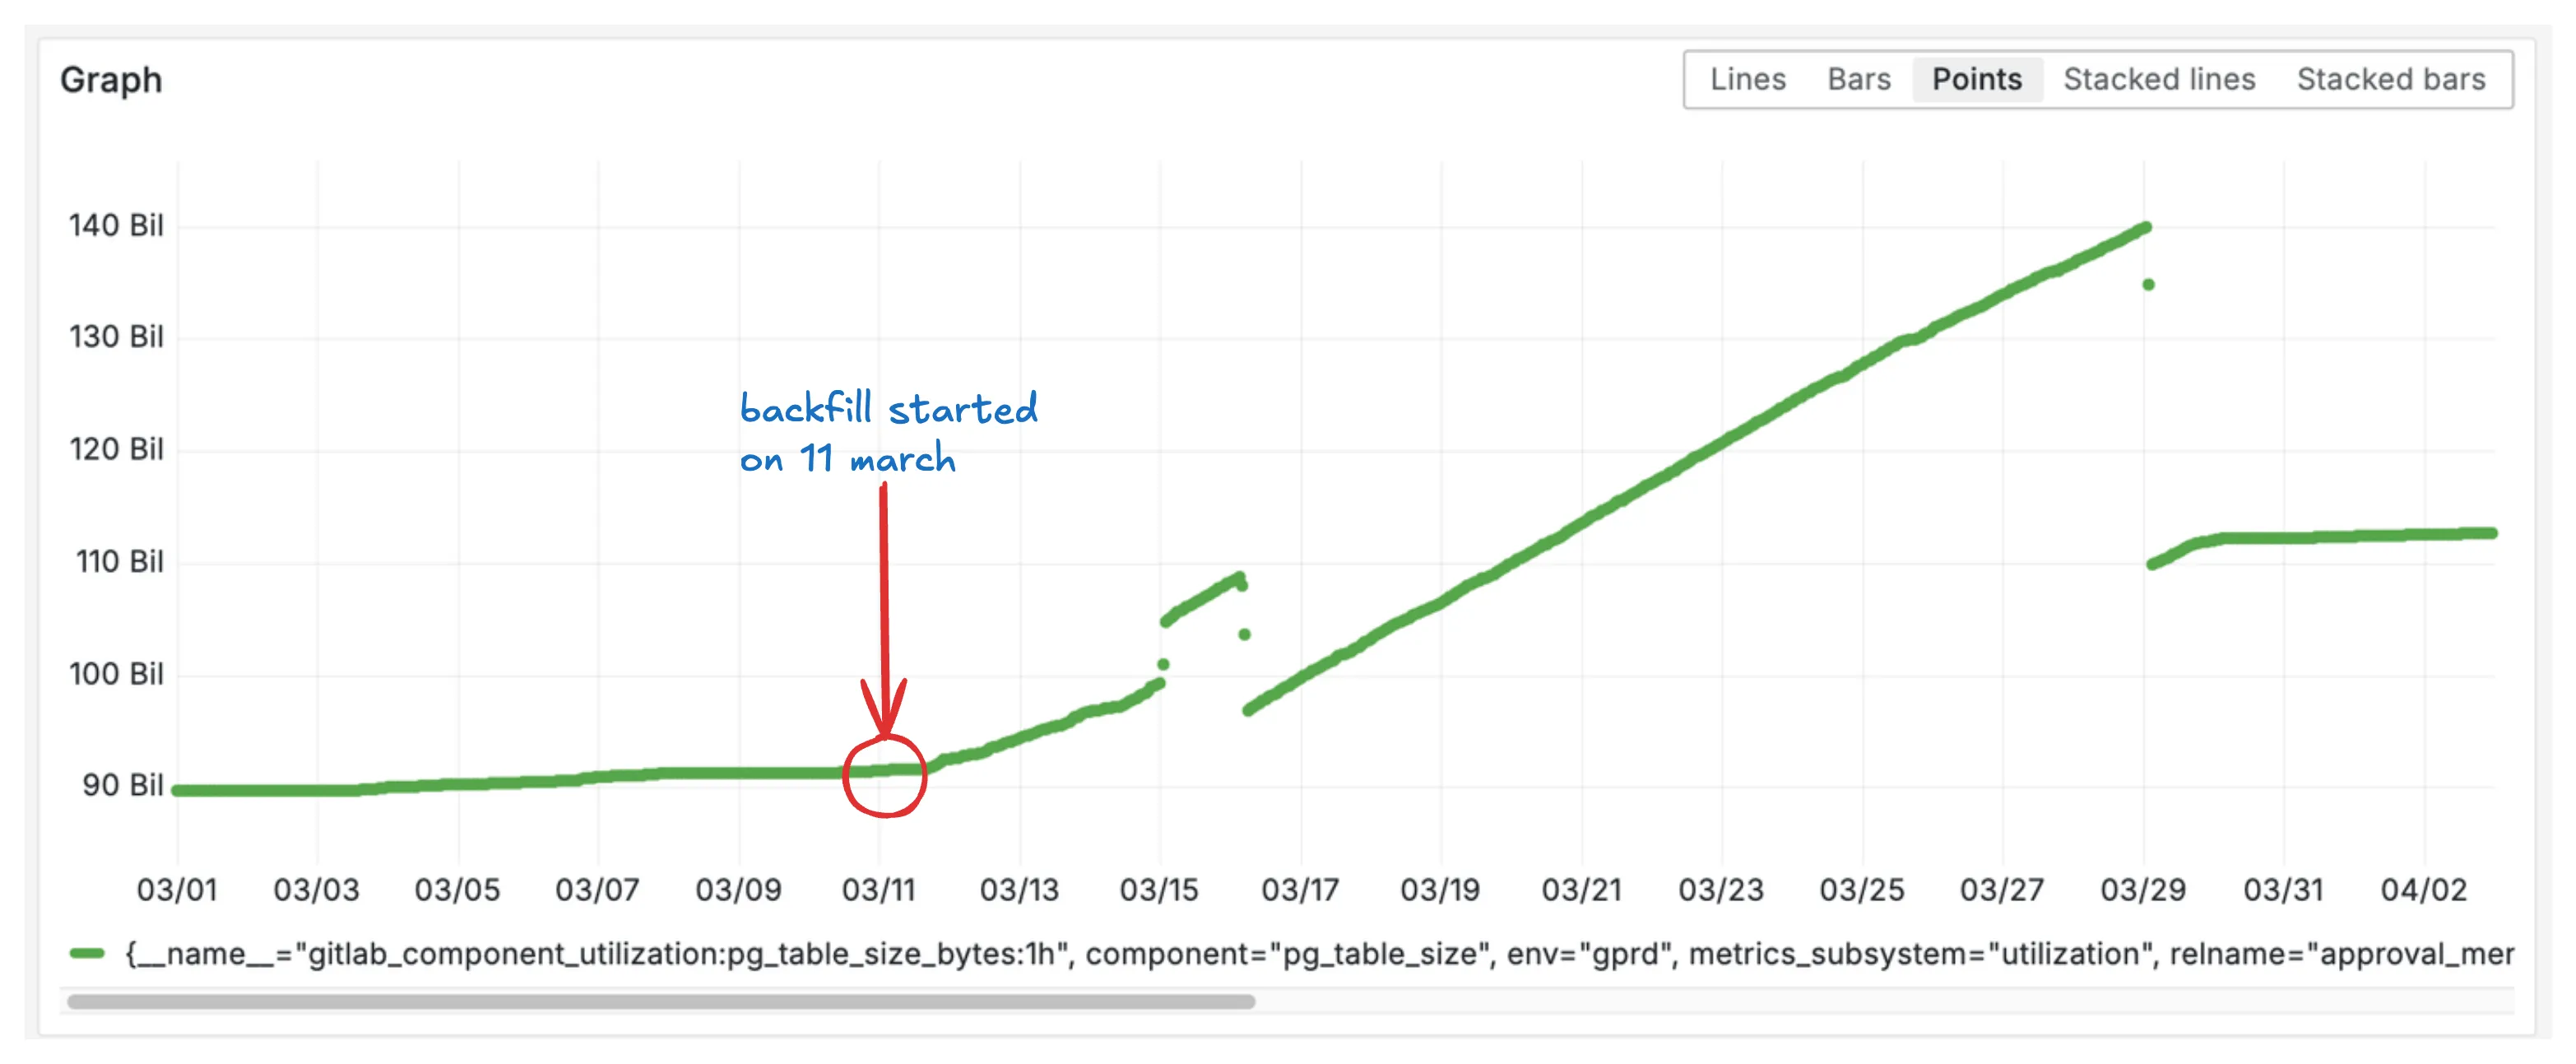
    백필이 시작된 2025년 3월 11일부터 테이블 크기가 점진적으로 증가하는 그래프.

    이는 매우 정상적인 현상입니다.

  4. post 마이그레이션에 추가한 변경 사항을 살펴봅니다. 먼저 prepare_async 인덱스를 추가했습니다. postgres.ai에서 크기를 확인합니다. 크기는 10 GB입니다. 그래프의 급증에서 볼 수 있듯이 2025-03-15 00:00에 생성되었습니다.
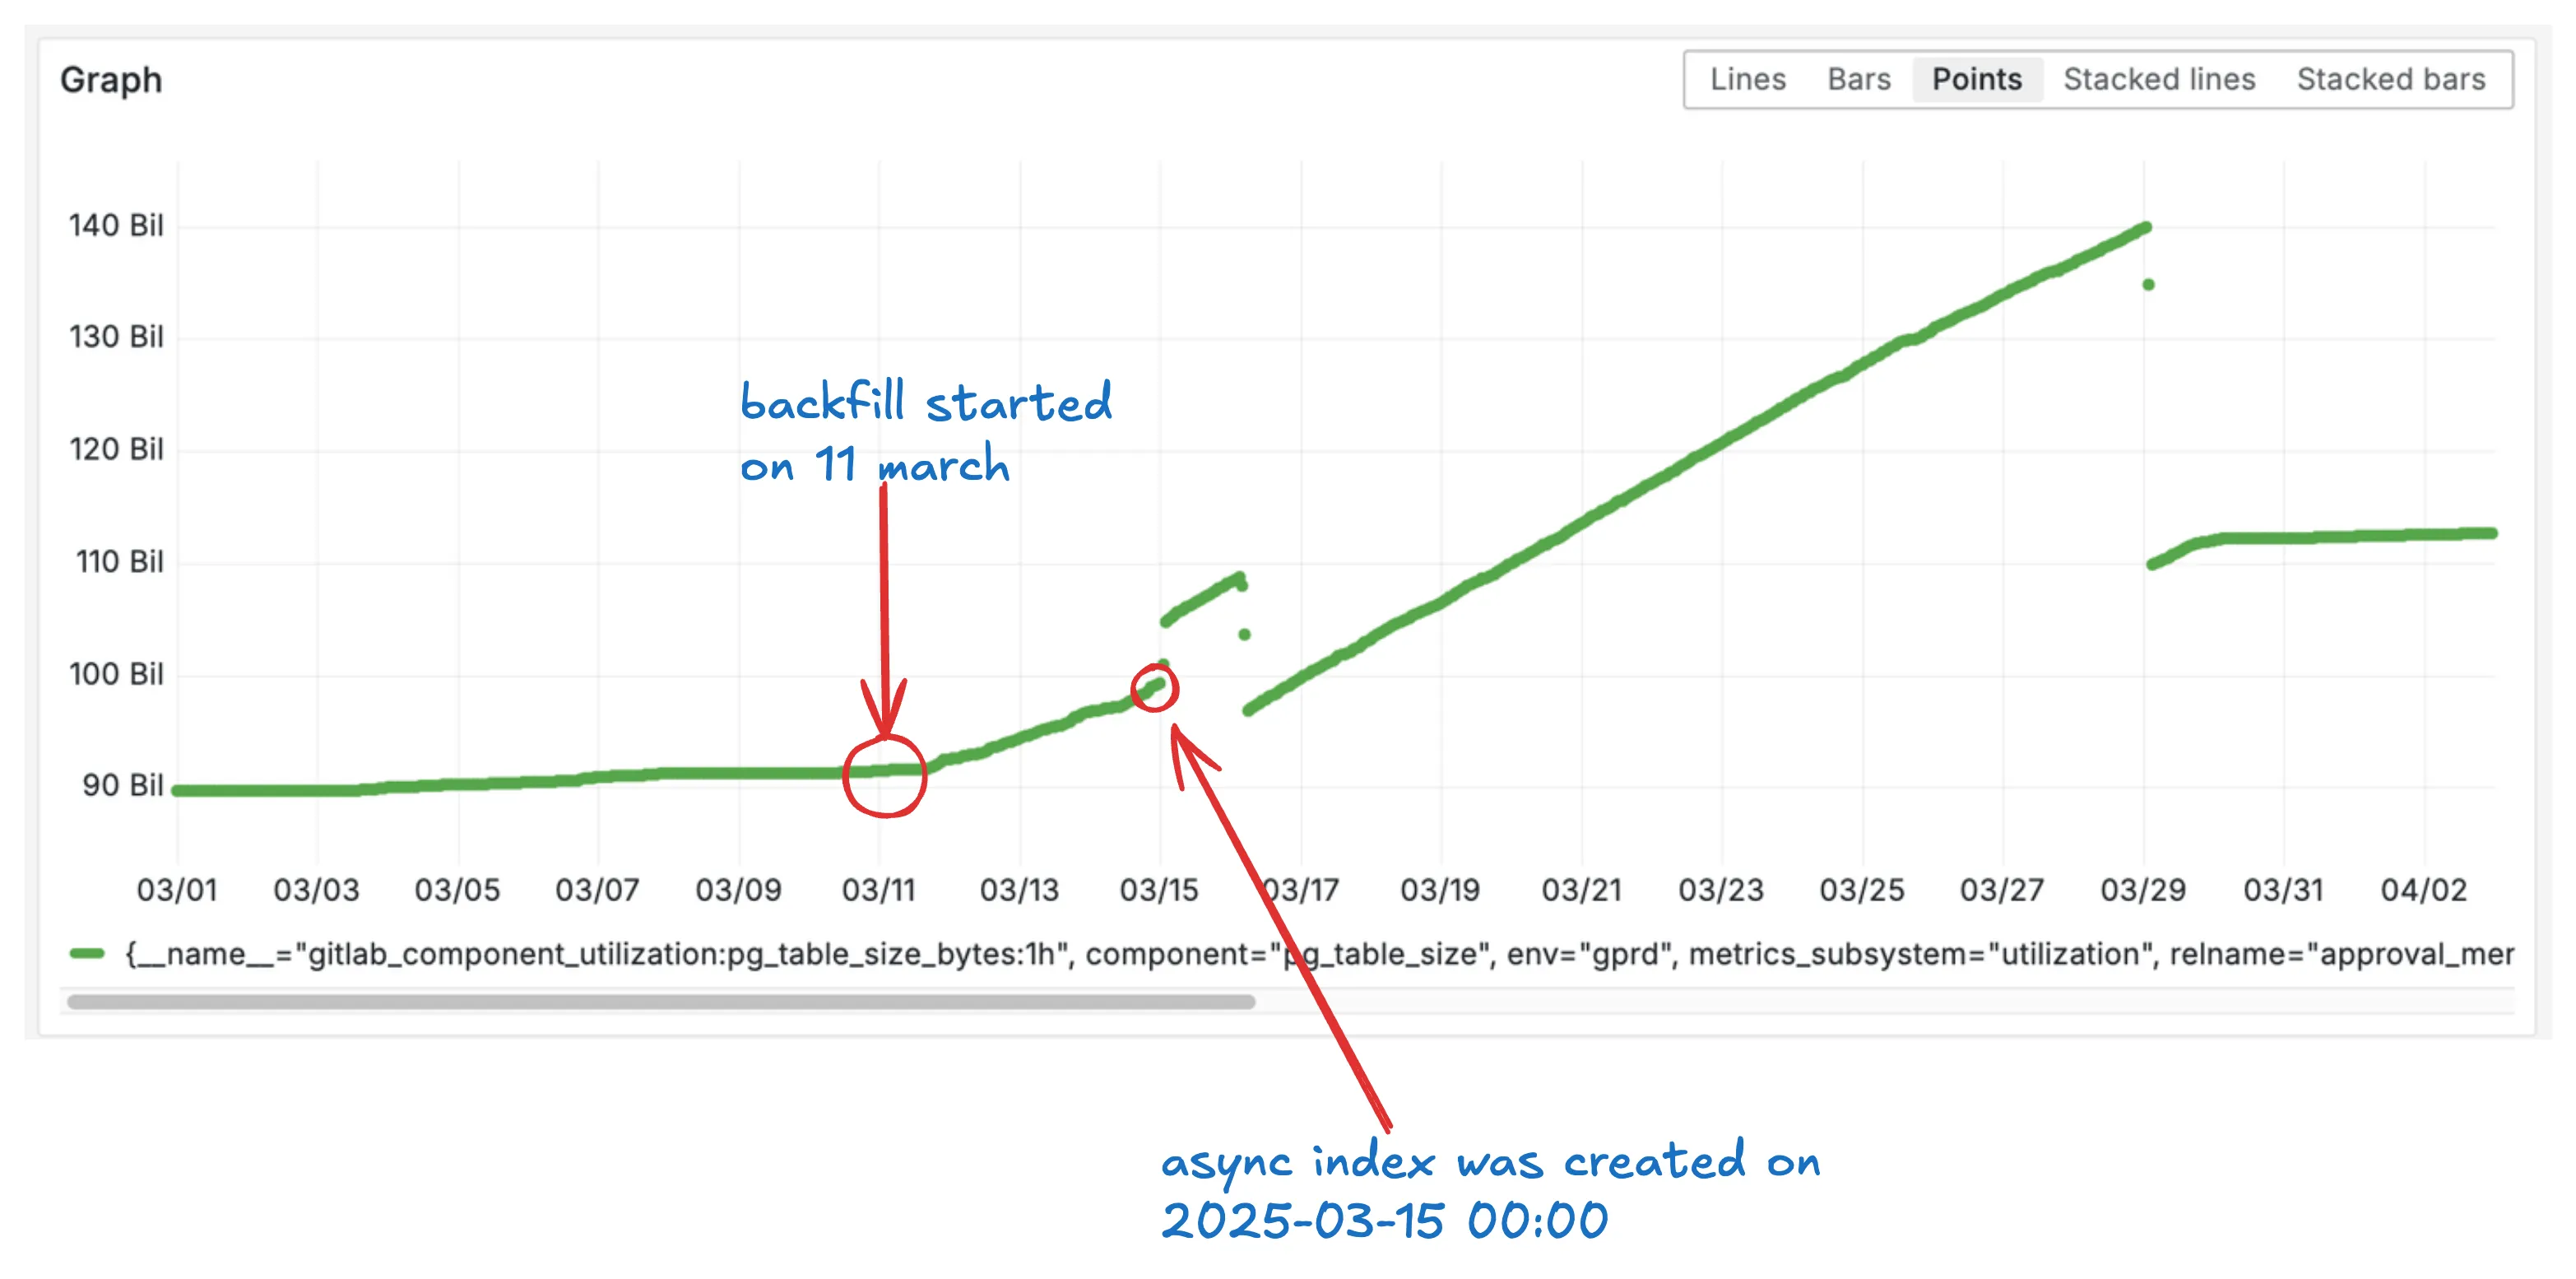
    비동기 인덱스 생성으로 2025년 3월 15일에 10 GB가 증가한 급격한 상승.

  5. 인덱스가 생성되면 백필이 시작됩니다.

    인덱스 생성 후 테이블 크기가 계속 증가해 110 GB에 가까워지는 그래프.

  6. BBM은 2025-03-29에 실패합니다. 그래프에서 이 시점에 테이블 크기가 줄어든 것을 볼 수 있습니다.
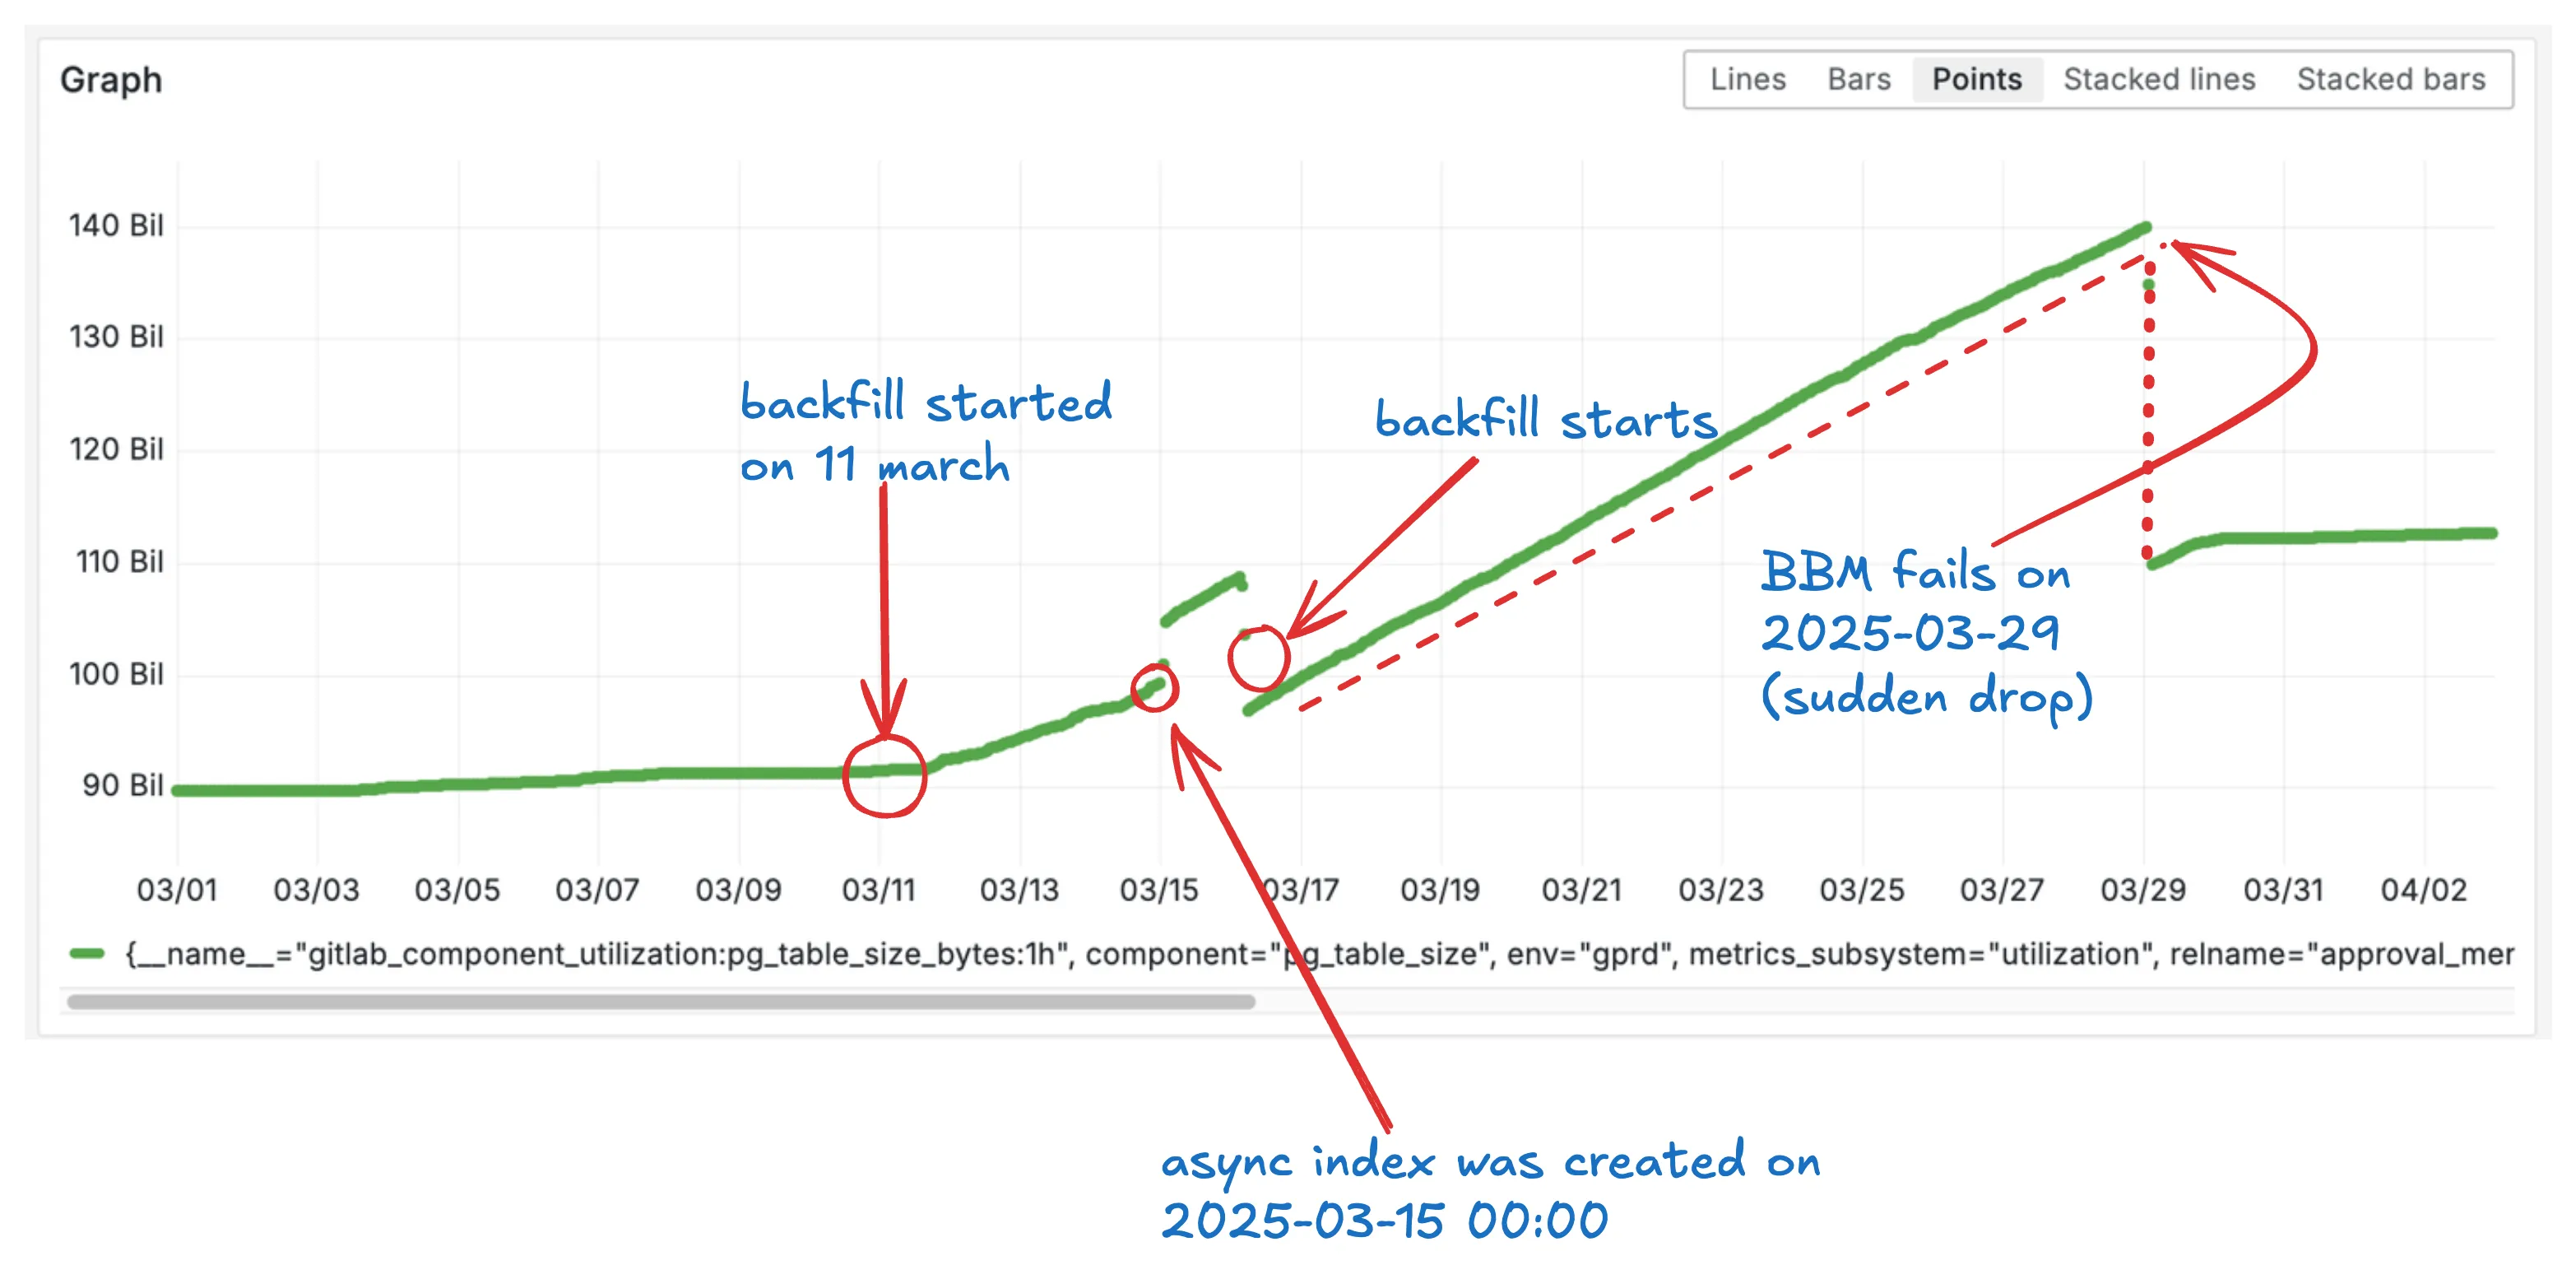
    마이그레이션 실패와 롤백을 나타내는 2025년 3월 29일의 급격한 테이블 크기 감소.

  • 인덱스와 칼럼 백필로 테이블 크기가 백필 이전보다 약 20 GB 늘었고, 이는 약 90 GB에서 약 110 GB로 테이블 크기가 약 22% 증가한 것입니다.
  • 모든 테이블을 100 GB 미만으로 유지하는 것이 목표입니다.

미해결 상태로 종료된 이슈 업데이트#

데이터베이스 YAML 문서에 링크된 이슈 중 일부는 종료되었고, 새 이슈로 대체된 경우도 있지만 YAML 파일은 여전히 원래 URL을 가리킵니다. 진행 상황을 정확하게 측정하려면 이러한 링크가 올바른 항목을 가리키도록 업데이트해야 합니다.

샤딩 이슈에 더 많은 정보 추가#

모든 샤딩 이슈에는 담당자와 연관된 마일스톤이 있어야 하고, 해당하는 경우 블로커에 링크해야 합니다. 이는 작업을 계획하고 완료 날짜를 추정하는 데 도움이 됩니다. 또한 문제나 우려 사항이 있을 때 연락할 사람을 각 이슈에 지정하게 합니다. 또한 블로커 이슈를 강조해 프로젝트 작업을 시각화하는 데 도움이 되므로 블로커 해결을 도울 수 있습니다.

블로커는 의존성일 수 있습니다. 예를 들어 notes 테이블은 다른 테이블이 진행되기 전에 완전히 마이그레이션되어야 합니다. 다운스트림 이슈는 관련 항목을 블로커로 표시해 이러한 관계를 이해하는 데 도움이 되도록 해야 합니다.

샤딩 가이드라인

GitLab v19.4
원문 보기

요약

샤딩 이니셔티브는 대부분의 GitLab 데이터베이스 테이블을 직접 또는 간접적으로 Organization에 연결할 수 있도록 만드는 장기 프로젝트입니다. 다음 gitlab_schema를 가진 모든 테이블은 organization 레벨로 간주됩니다:

샤딩 이니셔티브는 대부분의 GitLab 데이터베이스 테이블을 직접 또는 간접적으로 Organization에 연결할 수 있도록 만드는 장기 프로젝트입니다. 이 작업에는 테이블에 organization_id, namespace_id, project_id 칼럼을 추가하고 NOT NULL 폴백 데이터를 백필하는 일이 포함됩니다. 이 작업은 Cells와 Organizations를 제공하는 데 중요합니다. 자세한 내용은 Organizations의 설계 목표를 참고합니다.

샤딩 원칙#

다음 gitlab_schema를 가진 모든 테이블은 organization 레벨로 간주됩니다:

  • gitlab_main_org
  • gitlab_ci
  • gitlab_sec
  • gitlab_main_user
  • gitlab_shared_org

그 외의 모든 테이블은 cell 로컬로 간주됩니다. cell 로컬 테이블의 데이터는 cell 사이에서 마이그레이션되지 않으므로 샤딩 키를 두면 안 됩니다.

새로 생성되는 organization 레벨 테이블은 모두 해당 테이블의 db/docs/ 파일에 sharding_key가 정의되어 있어야 합니다.

샤딩 키의 목적은 Organization isolation blueprint에 문서화되어 있지만, 간단히 말하면 이 칼럼은 데이터베이스의 특정 행을 어느 Organization이 소유하는지 판단하는 표준 방법을 제공하는 데 사용됩니다.

올바른 샤딩 키 선택#

모든 행에는 샤딩 키가 정확히 1개 있어야 하며, 가능한 한 구체적이어야 합니다. 대형 테이블에는 예외를 둘 수 없습니다.

외래 키의 실제 이름은 무엇이든 될 수 있지만 projects 또는 namespaces의 행을 참조해야 합니다.

유효한 샤딩 키의 예시는 다음과 같습니다:

  • 테이블 항목이 프로젝트에만 속하는 경우:

    sharding_key:
      project_id: projects
    
  • 테이블 항목이 프로젝트에 속하고 외래 키가 target_project_id인 경우:

    sharding_key:
      target_project_id: projects
    
  • 테이블 항목이 네임스페이스/그룹에만 속하는 경우:

    sharding_key:
      namespace_id: namespaces
    
  • 테이블 항목이 네임스페이스/그룹에만 속하고 외래 키가 group_id인 경우:

    sharding_key:
      group_id: namespaces
    
  • (gitlab_main_user에만 해당) 테이블 항목이 사용자에게만 속하는 경우:

    sharding_key:
      user_id: users
    

샤딩 키는 null을 허용하지 않아야 합니다#

선택한 sharding_key는 null을 허용하지 않아야 합니다. 각 행을 일관되게 organization에 귀속시킬 수 있어야 하고, organization을 다른 cell로 마이그레이션한 후 데이터를 잃지 않아야 합니다.

또한 Org Mover의 행 필터링을 설정하려면 REPLICA IDENTITY에 샤딩 키 칼럼이 포함되어야 합니다. 이 REPLICA IDENTITY에는 null이 아닌 칼럼만 포함해야 합니다.

여러 개의 샤딩 키 칼럼#

테이블이 서로 다른 여러 상위 엔터티에 속할 수 있는 드문 경우(예: 프로젝트와 네임스페이스 양쪽)에는 sharding_key를 여러 칼럼으로 정의할 수 있습니다. 이는 테이블의 한 행에서 샤딩 키 칼럼 중 정확히 하나만 null이 아니어야 한다는 점을 올바르게 보장하는 검사 제약 조건이 테이블에 있는 경우에만 허용됩니다. 이러한 제약 조건을 만드는 방법은 여러 칼럼에 대한 NOT NULL 제약 조건을 참고합니다.

  • 테이블 항목이 네임스페이스 또는 프로젝트에 속하는 경우:

    sharding_key:
      project_id: projects
      namespace_id: namespaces
    

예를 들어:

  • cell 사이에서 organization을 이동하려면 모든 테이블의 모든 행에 organization_id가 필요합니다.
  • 그러나 실제로는 최상위 그룹(또는 그 하위 그룹이나 프로젝트)이 소유하는 행에 organization_id를 두면 (organization_id 재작성 때문에) 최상위 그룹 전송이 비효율적이어서 실용성이 없어집니다.
  • 절충안: 모든 테이블의 모든 행에 organization_id 또는 namespace_id를 추가합니다.
  • 그러나 실제로는 프로젝트가 소유하는 테이블의 행에 namespace_id를 두면 (namespace_id 재작성 때문에) 프로젝트 전송(및 일부 하위 그룹 전송)이 비효율적이어서 실용성이 없어집니다.
  • 절충안: 모든 테이블의 모든 행에 organization_id, namespace_id, project_id 중 가장 구체적인 것을 추가합니다.
Warning

샤딩 키 칼럼이 여러 개인 테이블은 cell 사이의 효율적인 데이터 마이그레이션과 격리를 지원하기 위해 향후 별도의 테이블로 분리해야 할 수 있습니다. 꼭 필요한 경우가 아니라면 샤딩 키 칼럼이 여러 개인 새 테이블은 설계하지 않습니다.

샤딩 키는 변경 불가능해야 합니다#

sharding_key는 항상 변경 불가능한 것을 선택해야 합니다. 샤딩 키 칼럼이 계획 중인 Org Mover의 인덱스로 사용되고, organization 데이터의 격리 시행에도 사용되기 때문입니다. sharding_key를 변경하면 일관성 없는 데이터를 읽게 될 수 있습니다.

따라서 기능이 프로젝트 사이 또는 그룹/네임스페이스 사이로 데이터를 옮길 수 있는 사용자 경험을 요구한다면, 새 행을 만드는 방식으로 이동 기능을 다시 설계해야 할 수도 있습니다. 그 예는 이슈 이동 기능에서 볼 수 있습니다. 이 기능은 기존 issues 행의 project_id 칼럼을 실제로 바꾸지 않고 새 issues 행을 만들고 원래 issues 행에서 이어지는 링크를 데이터베이스에 만듭니다. 데이터 이동을 허용해야 하는 특히 까다로운 기존 기능이 있다면, 초기에 Tenant Scale 팀에 연락해 샤딩 키를 관리하는 방법에 관한 선택지를 논의해야 합니다.

샤딩 키 값이 상위 테이블에서 오는 경우#

새 샤딩 키 칼럼에서 대상 테이블(projects, namespaces, organizations, users)로 직접 외래 키를 추가하기 전에, 그 테이블이 이미 같은 샤딩 키를 가진 상위 테이블을 참조하고 있는지 확인합니다. 참조하고 있다면 desired_sharding_key.backfill_via.parent를 사용해 그 상위 테이블에서 샤딩 키를 채우고, 상위 테이블의 외래 키에 의존합니다. 이 칼럼은 여전히 일반적인 샤딩 키이며 NOT NULL 제약 조건과 변경 불가능성 같은 다른 모든 요구 사항을 그대로 유지합니다. 생략되는 것은 중복된 외래 키 하나뿐입니다.

중복된 외래 키는 업그레이드를 망가뜨릴 수 있습니다. 상위 테이블이 대상 테이블을 참조하는 부분이 loose foreign key로 관리되면 정리가 최종적으로만 일관되므로, 상위 행이 이미 삭제된 행을 정상적으로 참조할 수 있습니다. 그 값을 하드 외래 키로 보호된 칼럼에 복사하는 백필은 외래 키 위반으로 실패하고 업그레이드를 막습니다 (이슈 605940).

중복된 외래 키는 대상 테이블에 쌓이기도 하며, 이는 마이그레이션의 락 경합을 더 심하게 만듭니다 (이슈 599943).

다음 경우에만 대상 테이블에 직접 외래 키를 추가합니다:

  • 테이블에 샤딩 키를 이미 가진 상위 테이블이 없는 경우, 또는
  • 직접 참조가 상위 테이블을 통해 도달할 수 있는 엔터티와 의도적으로 다른 엔터티인 경우(예: 네임스페이스 간 공유 대상, 템플릿 프로젝트, 사용자 지정 템플릿 네임스페이스, 미러 소스). 이 경우 직접 외래 키는 의미 있는 비정규화이므로 그대로 두어야 합니다.

이러한 요구 사항은 spec/lib/gitlab/organizations/sharding_key_spec.rb가 강제하며, 이 spec은 기본적으로 직접 외래 키를 요구합니다. 테이블이 이미 외래 키나 loose foreign key로 같은 대상을 참조하는 상위 테이블에서 샤딩 키 값이 오는 경우, spec이 상위 체인을 감지해 직접 외래 키 요구 사항을 대신 면제해 줍니다. 칼럼을 예외 목록에 추가할 필요는 없습니다.

namespace_id를 샤딩 키로 사용#

namespaces 테이블에는 Group, ProjectNamespace, UserNamespace를 참조할 수 있는 행이 있습니다. UserNamespace 유형은 개인 네임스페이스라고도 합니다.

namespace_id를 샤딩 키로 사용하는 것은 좋은 선택이지만, namespace_id가 UserNamespace를 참조할 때는 예외입니다. 사용자에게 관련된 namespace 레코드가 반드시 있는 것은 아니므로 이 샤딩 키는 NULL이 될 수 있습니다. 샤딩 키에는 NULL 값이 있으면 안 됩니다.

프로젝트와 네임스페이스에 같은 샤딩 키 사용#

개발자는 테이블이 사용하는 기능이 Consolidating Groups and Projects blueprint에 따라 개발되는 경우, 프로젝트에 속할 수 있는 테이블에도 namespace_id만 사용하도록 선택할 수 있습니다. 이 경우 namespace_id는 네임스페이스가 속한 그룹이 아니라 ProjectNamespace의 ID여야 합니다.

organization_id를 샤딩 키로 사용#

일반적으로 project_id 또는 namespace_id가 가장 흔한 샤딩 키입니다. 그러나 테이블이 프로젝트나 네임스페이스에 속하지 않는 경우도 있습니다.

그런 경우에는 아래 지침을 따르는 한 organization_id를 샤딩 키로 선택할 수 있습니다:

  • sharding_key 칼럼은 여전히 변경 불가능해야 합니다.
  • organization_id는 루트 레벨 모델(예: namespaces)에만 추가하고, 리프 레벨 모델(예: issues)에는 추가하지 않습니다.
  • 그러한 테이블에 그룹이나 프로젝트와 관련된 데이터(또는 그룹이나 프로젝트에 속한 레코드)가 들어 있지 않도록 합니다. 대신 project_id 또는 namespace_id를 사용합니다.
  • 행이 많은 테이블은 좋은 후보가 아닙니다. 엔터티를 다른 organization으로 옮길 때 모든 행을 다시 써야 하고 비용이 클 수 있습니다.
  • 이 테이블을 참조하는 다른 테이블이 있는 경우, 참조하는 테이블의 레코드가 다른 organization으로 옮겨져도 애플리케이션이 계속 동작해야 합니다.

organization_id가 샤딩 키로 가장 좋은 선택이라고 판단되면 Tenant Scale 그룹의 승인을 받습니다. 이는 데이터 마이그레이션에 영향을 주고 샤딩 키 선택을 다시 검토해야 할 수 있으므로 매우 중요합니다.

예시로, 기존 테이블에 organization_id를 샤딩 키로 추가한 이 이슈를 참고합니다.

organization_id로 테이블 샤딩#

organization_id로 샤딩되도록 새 테이블을 추가하거나 기존 테이블을 수정할 때는 다음을 수행해야 합니다:

  1. 전송 서비스 지원을 추가합니다. 그룹이나 사용자가 새 organization으로 전송될 때 레코드의 organization_id를 업데이트합니다.
  2. 팩토리에서 공통 organization을 사용합니다. RSpec 팩토리가 공통 organization과 자동으로 연결되도록 합니다. Namespaces 팩토리의 after build 블록을 참고합니다.

크로스 스키마 참조#

Cells 아키텍처에서는 organization 데이터를 cell 사이에서 안전하게 마이그레이션할 수 있어야 합니다. 크로스 스키마 참조는 일반적으로 허용되지 않습니다.

핵심 원칙: organization 데이터는 마이그레이션할 수 있어야 합니다#

organization이 다른 cell로 이동하면 organization 레벨 테이블에 저장된 모든 데이터가 전송되어야 합니다. 이는 다음을 의미합니다:

  • organization 데이터는 cell 로컬 데이터에 의존할 수 없습니다. 단, 그 의존성이 일관되거나 자가 복구되는 경우는 예외입니다.
  • cell 로컬 데이터는 organization 데이터를 참조할 수 있습니다. organization 데이터는 안정적이고 organization과 함께 이동하기 때문입니다.

허용되는 패턴#

다음 크로스 스키마 참조는 허용됩니다:

From To Why
gitlab_main_cell_local gitlab_main_org cell 로컬 데이터는 org 데이터를 안전하게 참조할 수 있습니다. org 데이터는 organization과 함께 이동합니다.
gitlab_ci_cell_local gitlab_ci CI/CD cell 로컬 데이터는 CI/CD org 데이터를 참조할 수 있습니다.

구현 지침#

organization 데이터가 cell 로컬 데이터를 참조해야 하는 경우:

마이그레이션이 차단되지 않도록 Loose Foreign Key를 사용합니다:

# config/gitlab_loose_foreign_keys.yml
org_table:
  - table: cell_local_table
    column: cell_local_id
    on_delete: async_delete

다만 마이그레이션 후 참조를 자가 복구하거나 다시 생성하는 애플리케이션 로직도 구현해야 합니다. 참조된 cell 로컬 데이터는 대상 cell에 존재하지 않거나 ID가 다를 수 있습니다. 애플리케이션은 다음 중 하나를 해야 합니다:

  • 진실 공급원에서 데이터를 다시 계산하거나 다시 가져와 참조를 다시 생성합니다
  • 누락되었거나 오래된 참조를 적절히 처리합니다
  • 마이그레이션 과정의 일부로 참조를 검증하고 복구합니다

cell 로컬 데이터가 organization 데이터를 참조해야 하는 경우:

일반 외래 키를 사용합니다.

class AddForeignKeyToCellLocalTable < Gitlab::Database::Migration[2.2]
  disable_ddl_transaction!

  def up
    add_foreign_key :cell_local_table, :org_table,
      column: :org_table_id,
      on_delete: :cascade
  end

  def down
    remove_foreign_key :cell_local_table, :org_table
  end
end

검증#

spec/lib/gitlab/database/no_cross_db_foreign_keys_spec.rb 테스트가 이러한 원칙을 강제합니다. 크로스 데이터베이스 외래 키 오류로 실패하면 다음 중 하나를 수행합니다:

  1. Loose Foreign Key를 사용합니다(org에서 cell 로컬로 향하는 참조에 권장).
  2. 이슈 번호와 함께 allowed_cross_database_foreign_keys에 추가합니다(기존 FK만 해당).

교훈: organization 데이터에서 불안정한 식별자 피하기#

organization 데이터가 외부 소스(예: Gitaly)를 참조할 때는 cell 사이에서 일관되지 않을 수 있는 식별자를 저장하지 않습니다.

예시: programming_languages 테이블은 Gitaly에서 데이터를 받습니다. 한 cell에서 생성된 ID는 다음 이유로 다른 cell과 다를 수 있습니다:

  • cell마다 초기 언어 세트가 다릅니다
  • 새 언어는 런타임에 발견됩니다
  • cell 사이에서 삽입 순서가 다릅니다

organization 데이터(예: repository_languages)가 이러한 불안정한 ID를 저장하면 데이터가 cell 사이에서 일관성을 잃고 안정적으로 마이그레이션할 수 없습니다.

해결책:

  1. 전역적으로 안정적인 식별자 사용: organization 데이터가 외부 데이터를 참조해야 한다면 모든 cell에서 일관된 식별자를 사용합니다(예: 사전 정의된 목록의 식별자).
  2. 계산된 데이터는 저장하지 않기: 데이터가 즉석에서 계산되고 organization과 함께 이동할 필요가 없다면 organization 테이블에 ID를 저장하지 않습니다.
  3. 참조를 자가 복구 가능하게 만들기: cell 로컬 데이터에 대한 참조를 저장해야 한다면 마이그레이션 후 다시 생성하거나 검증할 수 있게 합니다.
  4. Loose Foreign Key 사용: organization 데이터에서 cell 로컬 데이터로 향하는 참조에는 마이그레이션이 차단되지 않도록 Loose Foreign Key를 사용합니다.

자세한 사례 연구는 이슈 519895를 참고합니다.

샤딩 키 구현#

테이블에 샤딩 키를 추가하려면 다음 단계를 따릅니다. 샤딩 키가 없는 수백 개의 테이블에 sharding_key를 백필해야 합니다. 반복 작업을 최소화하기 위해 gitlab-housekeeper를 사용해 sharding_key를 백필하는 방법을 선언적으로 기술하는 방식을 도입했고, 이를 통해 수동으로 처리하는 대신 원하는 변경 사항이 담긴 MR을 생성할 수 있습니다.

애플리케이션 레벨에서 샤딩 키 존재 보장#

샤딩 키를 정의할 때는 애플리케이션 레벨에서 값이 채워지도록 해야 합니다. 모든 ApplicationRecord 모델에는 populate_sharding_key 헬퍼가 포함되어 있어 샤딩 키 로직을 정의하는 편리한 방법을 제공하며, 샤딩 키 로직을 테스트하는 대응 matcher도 함께 제공됩니다. 예를 들어:

# in model.rb
populate_sharding_key :project_id, source: :merge_request, field: :target_project_id

# in model_spec.rb
it { is_expected.to populate_sharding_key(:project_id).from(:merge_request, :target_project_id) }

더 많은 헬퍼 예시와 RSpec matcher 예시를 참고합니다.

desired_sharding_key 구성 정의#

백필 과정을 자동화하려면 테이블의 YAML 구성에 desired_sharding_key를 정의합니다. 예시는 이 MR에 추가되었습니다:

--- # db/docs/security_findings.yml
table_name: security_findings
classes:
- Security::Finding

# ...

desired_sharding_key:
  project_id:
    references: projects
    backfill_via:
      parent:
        foreign_key: scanner_id
        table: vulnerability_scanners
        table_primary_key: id # Optional. Defaults to 'id'
        sharding_key: project_id
        belongs_to: scanner

이 YAML은 배치 백그라운드 마이그레이션에서 백필할 상위 테이블과 그 테이블의 sharding_key를 지정합니다. 또한 모델에 추가되어 before_save에서 sharding_key를 채우는 belongs_to 관계도 지정합니다.

상위 테이블에도 desired_sharding_key가 있는 경우

상위 테이블에도 desired_sharding_key 구성이 있고 그 테이블 자체가 백필을 기다리고 있다면 awaiting_backfill_on_parent 필드를 포함합니다:

desired_sharding_key:
  project_id:
    references: projects
    backfill_via:
      parent:
        foreign_key: package_file_id
        table: packages_package_files
        table_primary_key: id # Optional. Defaults to 'id'
        sharding_key: project_id
        belongs_to: package_file
    awaiting_backfill_on_parent: true

이 desired_sharding_key 구조가 sharding_key 백필에 적합하지 않은 예외 사례도 있습니다. 그런 경우에는 테이블을 소유한 팀이 필요한 머지 리퀘스트를 직접 만들어야 합니다.

칼럼, 트리거, 인덱스, 외래 키 추가#

이 단계에서는 샤딩 키 칼럼과 인덱스, 외래 키, 필요한 트리거를 추가합니다.

1. 설정 단계:

  1. Housekeeper에 필요한 키를 설정합니다: export HOUSEKEEPER_TARGET_PROJECT_ID=278964(GitLab 프로젝트의 프로젝트 ID).

  2. 자신의 PAT를 새로 만듭니다: export HOUSEKEEPER_GITLAB_API_TOKEN=<your-pat>.

  3. 로컬 master 브랜치를 업데이트합니다: git checkout master && git pull origin master --rebase.

  4. 다음 명령으로 sharding-key-backfill-keeps 브랜치로 전환합니다:

    git checkout sharding-key-backfill-keeps
    

    이 브랜치는 MR에서도 찾을 수 있습니다.

  5. 이 브랜치를 master 위로 리베이스하고 변경 사항을 origin에 다시 푸시합니다. 이렇게 하면 이 브랜치가 master의 변경 사항을 반영합니다:

    git pull origin master --rebase
    
  6. 다음 명령을 실행해 리베이스된 변경 사항을 브랜치에 다시 푸시하고, LEFTHOOK=0은 생략합니다(그러지 않으면 RuboCop이 실패합니다):

    LEFTHOOK=0 git push --force-with-lease -o ci.skip
    
  • bundle install과 마이그레이션을 실행합니다.

이 브랜치에는 어떤 변경 사항도 푸시하지 않습니다. 계속 리베이스만 합니다.

2. 자동화된 MR 생성 단계:

소형 테이블과 대형 테이블의 샤딩 키 keep은 keeps 디렉터리에 저장합니다. 파일 이름은 backfill_desired_sharding_key_*.rb로 시작합니다.

소형 테이블 keep을 살펴봅니다:

데이터베이스 항목을 순회하며 샤딩 키를 추가하는 Housekeeper Keep 클래스 코드.

이 keep 파일에는 다음을 수행하는 코드가 들어 있습니다:

  • 소형 테이블에서 desired sharding key를 백필하는 Housekeeper::Keep 클래스를 정의합니다
  • 변경 유형에 ::Keeps::DesiredShardingKey::CHANGE_TYPES를 포함하도록 설정합니다
  • database_yaml_entries의 항목을 순회합니다
  • 각 항목에 대해 필요하면 인덱스, 트리거, 외래 키를 포함해 샤딩 키 칼럼을 추가합니다
  1. keep 파일을 열고 next unless entry.table_name == 'table name'을 추가합니다. 여기서 테이블 이름은 마이그레이션을 만들려는 테이블의 이름입니다.

  2. 테이블의 desired_sharding_key 구성을 기준으로 빠르게 점검합니다. 구성이 올바른지, 상위 테이블의 샤딩 키에 기대한 대로 NOT NULL 제약 조건이 있는지 확인합니다. 그렇지 않다면 그 테이블은 건너뛰고 다른 테이블로 넘어갑니다. 테이블에 문제가 없으면 계속 진행할 수 있습니다.

  3. 테이블의 기본 키를 확인합니다. 터미널에서 다음 명령을 실행합니다:

    • gdk psql
    • \d <table_name>
  4. 위 명령을 실행하면 인덱스, pk 등 테이블에 관한 유용한 정보를 얻을 수 있습니다. 예를 들어 security_scans 테이블은 다음과 같습니다:

    security_scans 테이블의 칼럼, 기본 키, 인덱스, 외래 키 관계를 보여 주는 데이터베이스 스키마 출력.

    출력에 표시되는 내용입니다:

    • 테이블: public.security_scans
    • 칼럼: id(bigint, not null), created_at(timestamp), updated_at(timestamp), build_id(bigint, not null), scan_type(smallint, not null) 및 기타 필드
    • 기본 키: security_scans_pkey(id에 대한 btree)
    • 인덱스: index_security_scans_on_build_id와 index_security_scans_on_project_id 포함
    • 외래 키: ci_builds와 projects에 대한 참조 포함
  5. 기본 키가 복합 키이거나 유일하지 않은 경우가 많아 keep에서 수동 수정이 필요하므로 이 확인은 중요합니다.

  6. 실행을 드라이런합니다. 드라이런은 생성될 변경 사항을 보여 주고 아무것도 커밋하지 않습니다:

    • bundle exec gitlab-housekeeper -k Keeps::BackfillDesiredShardingKeySmallTable -d
  7. 드라이런 결과가 괜찮으면 -d 플래그 없이 같은 명령을 실행합니다:

    • bundle exec gitlab-housekeeper -k Keeps::BackfillDesiredShardingKeySmallTable

    • 위 명령을 실행하면 변경 사항이 담긴 MR이 생성됩니다

대형 테이블에도 같은 방법을 따르고 대형 테이블 keep을 사용합니다. 유일한 차이는 성능 때문에 테이블에 FK를 두지 않는다는 점입니다.

유용한 요령 몇 가지:

1. :id가 아닌 기본 키를 가진 테이블

  1. 첫 번째 diff, 두 번째 diff, 세 번째 diff에서 :id를 ID가 아닌 기본 키로 바꿉니다.

  2. 이 diff에서 이 줄을 주석 처리합니다.

  3. 이 예시에서 한 것처럼 이 파일에 let(:batch_column) 줄을 추가합니다.

    예시 MR: !165940 (merged). 테이블이 gitlab_ci db를 사용한다면 마이그레이션 파일에 migration: :gitlab_ci를 지정해야 합니다.

2. 복합 기본 키(둘 이상)를 가진 테이블

  1. 테이블 정보를 가져와 기본 키 칼럼 중 하나에 UNIQUE 인덱스가 정의되어 있는지 확인하고, 정의되어 있다면 위에서 한 것처럼 그 칼럼을 기본 키이자 배치 칼럼으로 사용합니다.

  2. 어느 칼럼도 유일하지 않다면 변경 사항을 직접 추가해야 합니다.

  3. deployment_merge_requests 테이블을 예로 듭니다. 이 테이블은 유일하지 않은 복합 기본 키 "deployment_merge_requests_pkey" PRIMARY KEY, btree (deployment_id, merge_request_id)를 가진 테이블입니다.

  4. 커서 기반 배치 처리를 사용했습니다.

  5. 먼저 keep으로 변경 사항을 생성한 후 그 변경 사항을 편집합니다.

  6. 큐 백필 post migrate 파일을 열고 모든 변경 사항을 제거한 후 새로 추가합니다. 예를 들어:

    deployment_id와 merge_request_id 칼럼을 사용하는 커서 기반 배치 처리 마이그레이션 코드.

    예시 MR: !183738 (merged)

  7. 위 변경 방식은 이런 특성을 가진 다른 테이블에도 사용할 수 있습니다.

  8. lib/gitlab/background_migration/backfill_*.rb를 열고 keep이 생성한 모든 변경 사항을 제거한 후 다음을 추가합니다:

    커서 기반 순회로 샤딩 키를 업데이트하는 백그라운드 마이그레이션 job.

    !183738을 참고합니다.

  9. 테이블이 대형이면 schema_spec.rb의 무시 FK 목록 :ignored_fk_columns_map에 샤딩 키를 추가합니다.

  10. spec도 반드시 함께 업데이트합니다.

    추가 예시: !183047 (merged), !176714 (merged).

3. 다른 데이터베이스에 있는 테이블

  • 테이블은 ci db에 있고 샤딩 키는 main db에 있는 경우가 있을 수 있습니다.

  • 예를 들어 dast_site_profiles_builds는 sec db에 있고 샤딩 키 테이블 projects는 main db에 있습니다.

  • 이 경우 LFK(loose foreign key)를 추가해야 할 수 있습니다. 예: housekeep이 만든 MR, 그 뒤에 LFK를 추가했습니다.

  • 백필 spec과 큐 spec에 migration: :gitlab_sec를 반드시 추가합니다.

  • 서로 다른 db에 있으므로 일반 FK는 동작하지 않습니다.

  • 상위 테이블 dast_site_profiles에는 projects에 대한 LFK가 있습니다.

  • dast_site_profiles_builds 테이블이 상위 테이블 dast_site_profiles에 CASCADE 삭제가 설정된 FK 관계를 가지고 있으면, 연관된 dast_site_profiles 레코드가 삭제될 때 레코드도 삭제됩니다.

  • 다만 dast_site_profiles_builds에도 LFK 항목을 추가하는 것이 좋습니다.

     dast_site_profiles_builds:
       - table: projects
         column: project_id
         on_delete: async_delete
    

파이널라이제이션 마이그레이션#

칼럼이 추가되고 백필이 끝나면 마이그레이션을 파이널라이즈해야 합니다. 큐에 들어간 마이그레이션의 상태는 #chat-ops-test Slack 채널에서 확인할 수 있습니다.

  • 특정 job의 상태를 확인하려면 /chatops gitlab run batched_background_migrations list --job-class-name=<desired_sharding_key_migration_job_name>을 사용합니다

  • 출력은 다음과 같습니다:

    진행률과 배치 개수를 포함해 배치 백그라운드 마이그레이션 상태를 보여 주는 ChatOps 응답.

    ChatOps 출력에 표시되는 내용입니다:

    • job 클래스 이름
    • 테이블 이름
    • 상태(예: finished, active, paused)
    • 진행률
  1. 100%가 되면 master에서 새 브랜치를 만들고 다음을 실행합니다: bundle exec rails g post_deployment_migration finalize_<table><sharding_key>

    이 명령은 배포 후 마이그레이션 파일을 만듭니다. 그 파일을 편집합니다. 예를 들어 subscription_user_add_on_assignments 테이블의 경우 다음과 같습니다:

    class FinalizeBackfillSubscriptionUserAddOnAssignmentsOrganizationId < Gitlab::Database::Migration[2.2]
      milestone '17.6'
      disable_ddl_transaction!
    
      restrict_gitlab_migration gitlab_schema: :gitlab_main_org
    
      def up
        ensure_batched_background_migration_is_finished(
          job_class_name: 'BackfillSubscriptionUserAddOnAssignmentsOrganizationId',
          table_name: :subscription_user_add_on_assignments,
          column_name: :id,
          job_arguments: [:organization_id, :subscription_add_on_purchases, :organization_id, :add_on_purchase_id],
          finalize: true
        )
      end
    
      def down; end
    end
    
  2. job_class_name, table_name, column_name, job_arguments를 제외하면 다른 모든 테이블에서도 비슷합니다. job 인자가 올바른지 확인합니다. 샤딩 키 추가 및 백필 MR에서 job 인자를 대조할 수 있습니다.

  3. 작업이 끝나면 bin/rails db:migrate를 실행하고 db/docs의 finalized_by 키를 업데이트합니다. 예시 MR: !169834.

  • 여기까지입니다. git commit 후 MR을 만듭니다.

NOT NULL 제약 조건 추가#

마지막 단계는 샤딩 키에 NOT NULL 제약 조건이 있는지 확인하는 것입니다.

소형 테이블

  1. bundle exec rails g post_deployment_migration <table_name>_not_null로 배포 후 마이그레이션을 만듭니다

    예를 들어 subscription_user_add_on_assignments 테이블의 경우:

    class AddSubscriptionUserAddOnAssignmentsOrganizationIdNotNull < Gitlab::Database::Migration[2.2]
      milestone '17.6'
      disable_ddl_transaction!
    
      def up
        add_not_null_constraint :subscription_user_add_on_assignments, :organization_id
        end
    
      def down
        remove_not_null_constraint :subscription_user_add_on_assignments, :organization_id
      end
    end
    
  2. bin/rails db:migrate를 실행합니다.

  3. 해당 db/docs.*.yml 파일, 이 경우 db/docs/subscription_user_add_on_assignments.yml을 열고 desired_sharding_key와 desired_sharding_key_migration_job_name 구성을 제거한 후 sharding_key를 추가합니다.

    sharding_key:
      organization_id: organizations
    

대형 테이블 또는 런타임을 초과하는 테이블

이 경우 샤딩 키를 추가하기 전에 비동기 검증을 추가해야 합니다. MR 2개로 진행하는 과정입니다. packages_package_files 테이블을 예로 듭니다.

1단계(MR 1): packages_package_files의 샤딩 키에 NOT NULL 추가:

  1. validate: false로 not null 제약 조건을 추가하는 배포 후 마이그레이션을 만듭니다.

    비동기 검증을 위해 project_id에 검증되지 않은 not null 제약 조건을 추가하는 마이그레이션.

    class AddPackagesPackageFilesProjectIdNotNull < Gitlab::Database::Migration[2.2]
      milestone '17.11'
      disable_ddl_transaction!
    
      def up
        add_not_null_constraint :packages_package_files, :project_id, validate: false
      end
    
      def down
        remove_not_null_constraint :packages_package_files, :project_id
      end
    end
    
  2. 비동기 제약 조건 검증을 준비하는 또 다른 배포 후 마이그레이션을 만듭니다.

    class PreparePackagesPackageFilesProjectIdNotNullValidation < Gitlab::Database::Migration[2.2]
      disable_ddl_transaction!
      milestone '17.11'
    
      CONSTRAINT_NAME = :check_43773f06dc
    
      def up
        prepare_async_check_constraint_validation :packages_package_files, name: CONSTRAINT_NAME
      end
    
      def down
        unprepare_async_check_constraint_validation :packages_package_files, name: CONSTRAINT_NAME
      end
    end
    
  3. bin/rails db:migrate를 실행하고 변경 사항으로 MR을 만듭니다.

2단계(MR 2): packages_package_files에서 project_id NOT NULL 검증:

  1. 1단계의 MR이 머지되면 준비가 되도록 며칠 기다립니다. 상태는 https://console.postgres.ai/에서 확인할 수 있으며, joe 인스턴스 봇에 테이블 정보를 요청하면 됩니다. Check constraints를 확인합니다.

    • 샤딩 키 project_id가 NOT VALID로 표시됩니다.
    Check constraints:
      "check_43773f06dc" CHECK (project_id IS NOT NULL) NOT VALID
    
  2. 표시되면 not null 제약 조건을 검증하는 새 배포 후 마이그레이션을 만들 수 있습니다. down 마이그레이션은 no-op입니다.

  3. bin/rails db:migrate를 실행하고 structure.sql에서 다음 add constraint를 제거한 후 테이블 정의에 추가합니다:

    • 제거:
    ALTER TABLE packages_package_files
         ADD CONSTRAINT check_43773f06dc CHECK ((project_id IS NOT NULL)) NOT VALID;
    
    • 추가:
    CREATE TABLE packages_package_files (
        .
        .
        CONSTRAINT check_43773f06dc CHECK ((project_id IS NOT NULL)),
    );
    
  4. 해당 db/docs.*.yml 파일, 이 경우 db/docs/packages_package_files.yml을 열고 desired_sharding_key와 desired_sharding_key_migration_job_name 구성을 제거한 후 sharding_key를 추가합니다.

  5. 이 마이그레이션을 되돌리는 것은 #no-op으로 의도된 것이므로 pipeline:skip-check-migrations 레이블을 붙여 MR을 만듭니다.

Note

파이프라인이 FK 누락을 문제로 삼을 수 있습니다. FK를 sharding_key_spec.rb의 allowed_to_be_missing_foreign_key에 추가해야 합니다. FK 생략이 허용되는 경우에 관한 지침은 샤딩 키 칼럼에서 외래 키를 생략하는 경우를 참고합니다.

샤딩 키 칼럼에서 외래 키를 생략하는 경우#

샤딩 키 칼럼은 외래 키 제약 조건으로 상위 테이블(projects, namespaces, organizations)을 참조해야 합니다. 시간 기반 파티션 관리(partitioned_by의 retain_for로 구성)를 통해 고정된 보존 기간이 지난 데이터를 테이블이 자동으로 삭제하는 경우에는 외래 키를 생략할 수 있습니다. 오래된 파티션이 전체 단위로 삭제되므로, 참조 무결성은 연쇄 FK 제약 조건이 아니라 보존 정책으로 유지됩니다. sliding_list 파티셔닝 전략을 사용하는 테이블도 마찬가지이며, 이 경우 모든 행이 오래된 것으로 간주되면 파티션이 분리되고 삭제됩니다.

예시 1: retain_for를 사용한 고정 보존

web_hook_logs_daily는 일별로 파티셔닝되며 7일보다 오래된 파티션을 삭제합니다:

partitioned_by :created_at, strategy: :daily, retain_for: 7.days

오래된 파티션이 자동으로 삭제되므로 projects를 참조하는 web_hook_logs_daily.project_id의 외래 키는 필요하지 않습니다.

예시 2: sliding list 파티셔닝

security_findings는 sliding_list 전략을 사용하며, 파티션의 모든 findings가 제거된 스캔과 연관되고 security_scan_stale_after_days보다 오래되면 그 파티션을 분리합니다 (이 값은 구성할 수 있고 기본값은 3개월입니다):

partitioned_by :partition_number,
  strategy: :sliding_list,
  next_partition_if: ->(partition) { partition_full?(partition) || oldest_record_stale?(partition) },
  detach_partition_if: ->(partition) { detach_partition?(partition.value) }

오래된 파티션이 분리되고 결국 삭제되므로, projects를 참조하는 security_findings.project_id의 외래 키는 필요하지 않습니다.

이 이유로 외래 키를 생략할 때는 보존 동작을 설명하는 주석과 함께 spec/lib/gitlab/organizations/sharding_key_spec.rb의 allowed_to_be_missing_foreign_key에 칼럼을 추가합니다:

# No LFK needed: daily partitions are dropped after 7 days via retain_for
'web_hook_logs_daily.project_id', # https://gitlab.com/gitlab-org/gitlab/-/issues/524820

# No LFK needed: sliding_list partitions are detached once findings are stale and purged
'security_findings.project_id', # https://gitlab.com/gitlab-org/gitlab/-/work_items/588191

전송 서비스 지원 추가#

  1. 테이블이 organization_id로 샤딩되면 config/organizations/transfer_support.yml에 전송 지원 상태도 등록해야 합니다. 이 파일은 organization 전송(사용자나 그룹이 organization 사이를 이동할 때) 중에 각 테이블이 처리되는지 여부를 추적합니다.

    • {,ee/}app/services/**/organizations/transfer/*_service.rb의 전송 서비스 중 하나에 전송 로직을 구현했다면 supported로 설정합니다.
    • organization 전송에 변경이 필요하지 않은 테이블이면 no_work_needed로 설정합니다.
    • 전송 지원이 아직 구현되지 않은 기존 테이블은 https://gitlab.com/gitlab-org/gitlab/-/issues/<id> 또는 /-/work_items/<id> 형식의 추적 이슈 URL로 설정합니다. 새 테이블은 반드시 supported를 사용해야 합니다.

    알파벳 순서로 항목을 추가합니다:

    # config/organizations/transfer_support.yml
    your_table_name: supported
    
  2. update_organization_id_for 헬퍼를 사용해 적절한 전송 서비스에 테이블을 추가합니다:

    # app/services/organizations/transfer/users_service.rb
    def update_associated_organization_ids(user_ids)
      update_organization_id_for(PersonalAccessToken) { |relation| relation.for_users(user_ids) }
      update_organization_id_for(YourModel) { |relation| relation.where(user_id: user_ids) }
    end
    

팩토리에서 공통 organization 사용#

organization_id로 샤딩된 모델의 RSpec 팩토리는 공통 organization과 자동으로 연결되어야 합니다. 이렇게 하면 명시적인 organization 설정 없이도 테스트가 올바르게 동작합니다.

# spec/factories/your_models.rb
factory :your_model do
  organization { association(:common_organization) }
  # or derive from a related model
  organization { user&.organization || association(:common_organization) }
end

실패 디버깅#

Kibana 사용

백필 job을 큐에 넣은 후 실패 알림을 받는 경우가 있습니다. 한 가지 방법은 Kibana 로그를 사용하는 것입니다.

참고: Kibana 로그는 7일만 보관합니다

최근의 BackfillPushEventPayloadsProjectId BBM 실패를 예로 듭니다.

  • 실패는 백필된 원래 MR의 댓글로도 보고됩니다. 예: MR !183123

    배치 백그라운드 마이그레이션 실패 알림을 보여 주는 머지 리퀘스트 댓글.

  • #chat-ops-test Slack 채널에서 /chatops gitlab run batched_background_migrations list --job-class-name=<desired_sharding_key_migration_job_name>으로 job 상태를 확인할 수도 있습니다.

    배치 백그라운드 마이그레이션이 실패한 상태를 보여 주는 ChatOps 출력.

  • Kibana 대시보드로 실패 원인을 파악합니다.

  1. 데이터 뷰가 pubsub-sidekiq-inf-gprd*로 설정되어 있는지 확인합니다.

    pubsub Sidekiq 인덱스 패턴이 표시된 Kibana 데이터 뷰 선택기.

  2. 왼쪽에서 사용 가능한 모든 필드를 볼 수 있습니다. 필요한 것은 json.job_class_name, 즉 desired sharding key 마이그레이션 job 이름과 json.new_state: failed뿐입니다.

    job_class_name과 new_state를 포함해 사용 가능한 로그 필드를 보여 주는 Kibana 필드 패널.

  3. 원하는 로그를 얻기 위해 그 필터를 추가합니다.

    검색 조건을 추가할 준비가 된 Kibana 필터 인터페이스.

  4. 이 경우 json.job_class_name을 BackfillPushEventPayloadsProjectId로, json.new_state를 failed로 설정하고 필터를 적용합니다.

    job 클래스 이름과 실패 상태 파라미터를 설정하는 Kibana 필터 구성.

  5. 올바른 기간을 선택합니다. 이 마이그레이션은 며칠 전에 실패로 보고되었으므로 최근 7일만 표시하도록 필터링합니다.

    최근 7일의 로그를 표시하도록 설정된 Kibana 시간 선택기.

  6. 그러면 추가한 필터가 적용된 원하는 로그가 표시됩니다.

    실패한 마이그레이션 job의 필터링 결과를 보여 주는 Kibana 로그 화면.

  7. 로그를 펼쳐 json.exception_message를 찾습니다.

    예외 메시지와 오류 세부 정보가 드러난 펼쳐진 Kibana 로그 항목.

  • 보시다시피 이 BBM은 Sidekiq::Shutdown 때문에 실패했습니다.
  • 이를 해결하려면 마이그레이션을 다시 큐에 넣으면 됩니다.

Grafana 사용

로그는 7일까지만 보관하므로 Kibana에서 아무것도 찾지 못할 때가 있습니다. 이 경우 Grafana 대시보드를 사용할 수 있습니다.

최근의 BackfillApprovalMergeRequestRulesUsersProjectId BBM 실패를 예로 듭니다.

  • 원래 MR에서 태그됩니다.

    마이그레이션 실패에 관해 팀원을 태그하는 머지 리퀘스트 댓글.

  1. #chat-ops-test Slack 채널에서 /chatops gitlab run batched_background_migrations list --job-class-name=<desired_sharding_key_migration_job_name>으로 job 상태를 확인할 수도 있습니다.

    실패한 마이그레이션 상태와 진행 세부 정보를 보여 주는 ChatOps 명령 출력.

  2. Kibana 대시보드를 확인합니다. 이 job에는 로그가 없습니다.

  3. Grafana 대시보드로 이동합니다.

    내비게이션 옵션과 Explore 기능이 있는 Grafana 홈페이지.

  4. Explore를 클릭하고 새 쿼리를 추가합니다.

    메트릭과 기간을 위한 쿼리 빌더가 있는 Grafana Explore 화면.

  5. 샤딩 키 실패를 디버깅하는 가장 쉬운 방법은 테이블 크기 이상을 확인하는 것입니다.

    테이블 크기 메트릭과 레이블 필터를 보여 주는 Grafana 메트릭 브라우저.

  • 메트릭: gitlab_component_utilization:pg_table_size_bytes:1h.
  • 레이블 필터:
    • env: gprd.
    • type: patroni.
    • relname: approval_merge_request_rules_users.
  1. 기간: job 생성 날짜보다 최소 며칠 앞선 시점부터 선택합니다. MR에서 실패가 2025-03-31에 보고되었고 job은 2025-03-11에 생성된 것을 볼 수 있습니다. 기간은 2025-03-01부터 2025-04-02까지로 선택했습니다. 상황에 맞게 조정할 수 있습니다.

  2. 쿼리를 실행하면 선택한 기간에 대한 그래프가 생성됩니다.

    2025년 3월 초부터 90 GB 기준선을 보여 주는 Grafana 테이블 크기 그래프.

  3. 이 그래프를 해석합니다. 백필 job은 2025-03-11에 시작되었습니다. 이 날짜부터 테이블 크기가 조금씩 증가하는 것을 볼 수 있습니다.

    백필이 시작된 2025년 3월 11일부터 테이블 크기가 점진적으로 증가하는 그래프.

    이는 매우 정상적인 현상입니다.

  4. post 마이그레이션에 추가한 변경 사항을 살펴봅니다. 먼저 prepare_async 인덱스를 추가했습니다. postgres.ai에서 크기를 확인합니다. 크기는 10 GB입니다. 그래프의 급증에서 볼 수 있듯이 2025-03-15 00:00에 생성되었습니다.

    비동기 인덱스 생성으로 2025년 3월 15일에 10 GB가 증가한 급격한 상승.

  5. 인덱스가 생성되면 백필이 시작됩니다.

    인덱스 생성 후 테이블 크기가 계속 증가해 110 GB에 가까워지는 그래프.

  6. BBM은 2025-03-29에 실패합니다. 그래프에서 이 시점에 테이블 크기가 줄어든 것을 볼 수 있습니다.

    마이그레이션 실패와 롤백을 나타내는 2025년 3월 29일의 급격한 테이블 크기 감소.

  • 인덱스와 칼럼 백필로 테이블 크기가 백필 이전보다 약 20 GB 늘었고, 이는 약 90 GB에서 약 110 GB로 테이블 크기가 약 22% 증가한 것입니다.
  • 모든 테이블을 100 GB 미만으로 유지하는 것이 목표입니다.

미해결 상태로 종료된 이슈 업데이트#

데이터베이스 YAML 문서에 링크된 이슈 중 일부는 종료되었고, 새 이슈로 대체된 경우도 있지만 YAML 파일은 여전히 원래 URL을 가리킵니다. 진행 상황을 정확하게 측정하려면 이러한 링크가 올바른 항목을 가리키도록 업데이트해야 합니다.

샤딩 이슈에 더 많은 정보 추가#

모든 샤딩 이슈에는 담당자와 연관된 마일스톤이 있어야 하고, 해당하는 경우 블로커에 링크해야 합니다. 이는 작업을 계획하고 완료 날짜를 추정하는 데 도움이 됩니다. 또한 문제나 우려 사항이 있을 때 연락할 사람을 각 이슈에 지정하게 합니다. 또한 블로커 이슈를 강조해 프로젝트 작업을 시각화하는 데 도움이 되므로 블로커 해결을 도울 수 있습니다.

블로커는 의존성일 수 있습니다. 예를 들어 notes 테이블은 다른 테이블이 진행되기 전에 완전히 마이그레이션되어야 합니다. 다운스트림 이슈는 관련 항목을 블로커로 표시해 이러한 관계를 이해하는 데 도움이 되도록 해야 합니다.