



InfoGrab DocsInfoGrab Docs

Google Kubernetes Engine에서 GitLab Runner 플릿 설계 및 구성

요약

이 권장 사항을 사용하여 CI/CD 빌드 요구 사항을 분석하고, Google Kubernetes Engine(GKE)에서 호스팅되는 GitLab Runner 플릿을 설계, 구성, 검증합니다. 다음 다이어그램은 러너 플릿 구현 여정의 경로를 보여줍니다.

이 권장 사항을 사용하여 CI/CD 빌드 요구 사항을 분석하고, Google Kubernetes Engine(GKE)에서 호스팅되는 GitLab Runner 플릿을 설계, 구성, 검증합니다.

다음 다이어그램은 러너 플릿 구현 여정의 경로를 보여줍니다. 이 가이드는 다음 단계를 따릅니다.
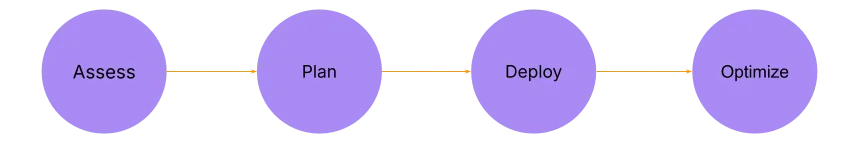
러너 플릿 단계 다이어그램

이 프레임워크를 사용하여 단일 그룹 또는 조직 전체를 지원하는 GitLab 인스턴스의 러너 배포를 계획할 수 있습니다.

이 프레임워크는 다음 단계로 구성됩니다.

  1. 예상 CI/CD 워크로드 평가
  2. 러너 플릿 구성 계획
  3. GKE에 러너 배포
  4. 최적화

예상 CI/CD 워크로드 평가#

이 단계에서는 지원 대상 개발팀의 CI/CD 빌드 요구 사항을 수집합니다. 해당하는 경우 사용 중인 프로그래밍, 스크립팅, 마크업 언어의 목록을 작성합니다.

여러 개발팀, 다양한 프로그래밍 언어, 빌드 요구 사항을 지원하고 있을 수 있습니다. 첫 번째 심층 분석에서는 한 팀, 한 프로젝트, 한 세트의 CI/CD 빌드 요구 사항으로 시작합니다.

예상 CI/CD 워크로드를 평가하려면 다음을 수행합니다.

  • 지원할 것으로 예상되는 CI/CD job 수요를 추정합니다(시간별, 일별, 주별).
  • 특정 프로젝트의 대표 샘플 CI/CD job에 필요한 CPU 및 RAM 리소스 요구 사항을 추정합니다. 이 추정치는 지원할 수 있는 다양한 프로필을 식별하는 데 도움이 됩니다. 이러한 프로필의 특성은 요구 사항을 지원하는 데 필요한 적절한 GKE 클러스터를 식별하는 데 중요합니다. CPU 및 RAM 요구 사항을 결정하는 방법은 다음 예시를 참고합니다.
  • 그룹 또는 프로젝트별로 특정 러너에 대한 접근을 분리해야 하는 보안 또는 정책 요구 사항이 있는지 확인합니다.

CI/CD job의 CPU 및 RAM 요구 사항 추정#

CPU 및 RAM 리소스 요구 사항은 프로그래밍 언어 유형이나 CI/CD job 유형(빌드, 통합 테스트, 단위 테스트, 보안 스캔)과 같은 요인에 따라 달라집니다. 다음 섹션에서는 CI/CD job의 CPU 및 리소스 요구 사항을 수집하는 방법을 설명합니다. 이 접근 방식을 자신의 필요에 맞게 채택하고 발전시킬 수 있습니다.

예를 들어 FastAPI 프로젝트 포크인 ra-group/fastapi에 정의된 것과 유사한 CI/CD job을 실행하는 경우를 살펴봅니다. 이 예시의 job은 Python 이미지를 사용해 프로젝트의 필요 패키지를 다운로드하고 기존 단위 테스트를 실행합니다. 이 job의 .gitlab-ci.yml은 다음과 같습니다.

tests:
  image: python:3.11.10-bookworm
  parallel: 25
  script:
  - pip install -r requirements.txt
  - pytest

필요한 컴퓨팅 및 RAM 리소스를 식별하려면 Docker를 사용하여 다음을 수행합니다.

  • FastAPI 포크와 CI/CD job 스크립트를 entrypoint로 사용하는 특정 이미지를 생성합니다.
  • 빌드한 이미지로 컨테이너를 실행하고 리소스 사용량을 모니터링합니다.

필요한 컴퓨팅 및 RAM 리소스를 식별하려면 다음 단계를 완료합니다.

  1. 모든 CI 명령이 포함된 스크립트 파일을 프로젝트에 생성합니다. 이 스크립트 파일의 이름은 entrypoint.sh입니다.

    #!/bin/bash
    cd /fastapi || exit
    pip install -r requirements.txt
    pytest
    
  2. entrypoint.sh 파일이 CI 스크립트를 실행하는 이미지를 생성하도록 Dockerfile을 작성합니다.

    FROM python:3.11.10-bookworm
    RUN mkdir /fastapi
    COPY . /fastapi
    RUN chmod +x /fastapi/entrypoint.sh
    CMD [ "bash", "/fastapi/entrypoint.sh" ]
    
  3. 이미지를 빌드합니다. 프로세스를 단순화하려면 빌드, 저장, 이미지 실행과 같은 모든 작업을 로컬에서 수행합니다. 이 방식을 사용하면 이미지를 풀·푸시하기 위한 온라인 레지스트리가 필요하지 않습니다.

    ❯ docker build . -t my-project_dir/fastapi:testing
    ...
    Successfully tagged my-project_dir/fastapi:testing
    
  4. 빌드한 이미지로 컨테이너를 실행하면서 컨테이너 실행 중 리소스 사용량을 동시에 모니터링합니다. 다음 명령으로 metrics.sh라는 이름의 스크립트를 생성합니다.

    #! /bin/bash
    
    container_id=$(docker run -d --rm my-project_dir/fastapi:testing)
    
    while true; do
        echo "Collecting metrics..."
        metrics=$(docker stats --no-trunc --no-stream --format "table {}\t{}\t{}" | grep "$container_id")
        if [ -z "$metrics" ]; then
            exit 0
        fi
        echo "Saving metrics..."
        echo "$metrics" >> metrics.log
        sleep 1
    done
    

    이 스크립트는 빌드한 이미지로 detached 컨테이너를 실행합니다. 그런 다음 컨테이너 ID를 사용해 컨테이너가 정상적으로 종료될 때까지 CPU 및 Memory 사용량을 수집합니다. 수집된 메트릭은 metrics.log라는 파일에 저장됩니다.

    [!note] 이 예시에서는 CI/CD job이 단기간 실행되므로 컨테이너 폴링 간 sleep 값을 1초로 설정합니다. 필요에 따라 이 값을 조정합니다.

  5. metrics.log 파일을 분석해 테스트 컨테이너의 최대 사용량을 식별합니다.

    이 예시에서 최대 CPU 사용량은 107.50%, 최대 메모리 사용량은 303.1Mi입니다.

    223e93dd05c6   94.98%    83.79MiB / 15.58GiB
    223e93dd05c6   28.27%    85.4MiB / 15.58GiB
    223e93dd05c6   53.92%    121.8MiB / 15.58GiB
    223e93dd05c6   70.73%    171.9MiB / 15.58GiB
    223e93dd05c6   20.78%    177.2MiB / 15.58GiB
    223e93dd05c6   26.19%    180.3MiB / 15.58GiB
    223e93dd05c6   77.04%    224.1MiB / 15.58GiB
    223e93dd05c6   97.16%    226.5MiB / 15.58GiB
    223e93dd05c6   98.52%    259MiB / 15.58GiB
    223e93dd05c6   98.78%    303.1MiB / 15.58GiB
    223e93dd05c6   100.03%   159.8MiB / 15.58GiB
    223e93dd05c6   103.97%   204MiB / 15.58GiB
    223e93dd05c6   107.50%   207.8MiB / 15.58GiB
    223e93dd05c6   105.96%   215.7MiB / 15.58GiB
    223e93dd05c6   101.88%   226.2MiB / 15.58GiB
    223e93dd05c6   100.44%   226.7MiB / 15.58GiB
    223e93dd05c6   100.20%   226.9MiB / 15.58GiB
    223e93dd05c6   100.60%   227.6MiB / 15.58GiB
    223e93dd05c6   100.46%   228MiB / 15.58GiB
    

수집된 메트릭 분석#

수집된 메트릭을 기반으로 이 job 프로필의 경우 Kubernetes executor job을 1 CPU와 ~304 Mi의 메모리로 제한할 수 있습니다. 이 결론이 정확하더라도 모든 사용 사례에 실용적이지 않을 수 있습니다.

e2-standard-4 노드 3개로 구성된 노드 풀이 있는 클러스터에서 job을 실행하는 경우 1 CPU 제한으로 동시에 실행할 수 있는 job은 12개뿐입니다(e2-standard-4 노드는 4 vCPU와 16GB 메모리를 제공합니다). 추가 job은 실행 중인 job이 완료되어 리소스가 확보될 때까지 대기합니다.

Kubernetes는 클러스터에 설정되거나 사용 가능한 제한보다 더 많은 메모리를 사용하는 Pod를 종료하므로 요청한 메모리 값이 중요합니다. 반면 CPU 제한은 더 유연하지만 job 소요 시간에 영향을 미칩니다. CPU 제한을 낮게 설정하면 job 완료에 걸리는 시간이 늘어납니다. 앞선 예시에서 CPU 제한을 1 대신 250m(또는 0.25)로 설정하면 job 소요 시간이 4배 늘어납니다(약 2분에서 8~10분으로).

메트릭 수집 방식이 폴링 메커니즘을 사용하므로 식별된 최대 사용량은 올림 처리해야 합니다. 예를 들어 메모리 사용량은 303 Mi 대신 400 Mi로 올림 처리합니다.

앞선 예시에서 중요하게 고려할 사항은 다음과 같습니다.

  • 이 메트릭은 Google Kubernetes Engine 클러스터와 CPU 구성이 다른 로컬 머신에서 수집되었습니다. 다만 e2-standard-4 노드가 있는 Kubernetes 클러스터에서 모니터링하여 이 메트릭을 검증했습니다.
  • 이러한 메트릭을 정확하게 파악하려면 평가 단계에서 설명한 테스트를 Google Compute Engine VM에서 실행합니다.

러너 플릿 구성 계획#

계획 단계에서는 조직에 적합한 러너 플릿 구성을 설계합니다. 다음을 기준으로 러너 스코프(인스턴스, 그룹, 프로젝트)와 Kubernetes 클러스터 구성을 고려합니다.

  • CI/CD job 리소스 수요 평가 결과
  • CI/CD job 유형 목록

러너 스코프#

러너 스코프를 계획하려면 다음 질문을 고려합니다.

  • 프로젝트 소유자와 그룹 소유자가 직접 러너를 생성하고 관리하도록 할지 검토합니다.

    • 기본적으로 프로젝트 및 그룹 소유자는 러너 구성을 생성하고 GitLab의 프로젝트 또는 그룹에 러너를 등록할 수 있습니다.
    • 이 설계를 사용하면 개발자가 빌드 환경을 빠르게 생성할 수 있습니다. 이 방식은 GitLab CI/CD를 처음 시작할 때 개발자가 겪는 마찰을 줄여줍니다. 다만 대규모 조직에서는 이 방식으로 인해 환경 전반에 활용도가 낮거나 사용되지 않는 러너가 많아질 수 있습니다.
  • 특정 유형의 러너에 대한 접근을 특정 그룹이나 프로젝트로 분리해야 하는 보안 또는 기타 정책이 조직에 있는지 확인합니다.

GitLab Self-Managed 환경에서 러너를 배포하는 가장 간단한 방법은 인스턴스용으로 생성하는 것입니다. 인스턴스로 스코프가 지정된 러너는 기본적으로 모든 그룹과 프로젝트에서 사용할 수 있습니다.

인스턴스 러너만으로 조직의 모든 요구 사항을 충족할 수 있다면 이 배포 패턴이 가장 효율적입니다. 이 패턴을 사용하면 대규모 CI/CD 빌드 플릿을 효율적이고 비용 효과적으로 운영할 수 있습니다.

특정 러너에 대한 접근을 특정 그룹이나 프로젝트로 분리해야 하는 요구 사항이 있다면 이를 계획 프로세스에 반영합니다.

러너 플릿 구성 예시 - 인스턴스 러너#

표의 구성은 조직의 러너 플릿을 구성할 때 활용할 수 있는 유연성을 보여줍니다. 이 예시는 인스턴스 크기와 job 태그가 서로 다른 여러 러너를 사용합니다. 이러한 러너를 사용하면 CPU 및 RAM 리소스 요구 사항이 각기 다른 여러 유형의 CI/CD job을 지원할 수 있습니다. 다만 Kubernetes를 사용할 때는 가장 효율적인 패턴이 아닐 수 있습니다.

러너 유형 러너 태그 스코프 제공할 러너 유형 수 러너 워커 사양 러너 호스트 환경 환경 구성
인스턴스 ci-runner-small 기본적으로 모든 그룹과 프로젝트에서 CI/CD job을 실행할 수 있습니다. 5 2 vCPU, 8 GB RAM Kubernetes → 노드 3개
→ 러너 워커 컴퓨팅 노드 = e2-standard-2
인스턴스 ci-runner-medium 기본적으로 모든 그룹과 프로젝트에서 CI/CD job을 실행할 수 있습니다. 2 4 vCPU, 16 GB RAM Kubernetes → 노드 3개
→ 러너 워커 컴퓨팅 노드 = e2-standard-4
인스턴스 ci-runner-large 기본적으로 모든 그룹과 프로젝트에서 CI/CD job을 실행할 수 있습니다. 1 8 vCPU, 32 GB RAM Kubernetes → 노드 3개
→ 러너 워커 컴퓨팅 노드 = e2-standard-8

이 러너 플릿 구성 예시에는 총 3개의 러너 구성과 CI/CD job을 실행 중인 러너 8개가 있습니다.

Kubernetes executor를 사용하면 Kubernetes 스케줄러를 활용하고 컨테이너 리소스를 오버라이트할 수 있습니다. 이론적으로는 적절한 리소스를 갖춘 Kubernetes 클러스터에 단일 GitLab Runner를 배포할 수 있습니다. 그런 다음 컨테이너 리소스를 오버라이트하여 각 CI/CD job에 적합한 컴퓨팅 유형을 선택할 수 있습니다. 이 패턴을 구현하면 배포하고 운영해야 하는 개별 러너 구성 수를 줄일 수 있습니다.

모범 사례#

  • 항상 러너 매니저 전용 노드 풀을 지정합니다.
    • 로그 처리와 캐시 또는 아티팩트 관리는 CPU를 많이 사용할 수 있습니다.
  • config.toml 파일에 항상 기본 제한(Build/Helper/Service 컨테이너의 CPU/Memory)을 설정합니다.
  • config.toml 파일에서 리소스에 대해 항상 최대 오버라이트를 허용합니다.
  • job 정의(.gitlab-ci.yml)에 job에 필요한 적절한 제한을 지정합니다.
    • 지정하지 않으면 config.toml 파일에 설정된 기본값이 사용됩니다.
    • 컨테이너가 메모리 제한을 초과하면 시스템이 OOM(Out of Memory) kill 프로세스를 사용해 컨테이너를 자동으로 종료합니다.
  • 기능 플래그 FF_PRINT_POD_EVENTS와 print_pod_warning_events 설정을 사용합니다. 자세한 내용은 기능 플래그 문서와 러너 API 권한 구성 문서를 참고합니다.

GKE에 러너 배포#

Google Kubernetes 클러스터에 GitLab Runner를 설치할 준비가 되면 다양한 옵션을 사용할 수 있습니다. GKE에 클러스터를 이미 생성했다면 GitLab Runner Helm Chart 또는 Operator를 사용해 클러스터에 러너를 설치할 수 있습니다.

GKE에 클러스터를 아직 설정하지 않았다면 GitLab에서 제공하는 GitLab Runner Infrastructure Toolkit(GRIT)을 사용해 다음을 동시에 수행할 수 있습니다.

  • 멀티 노드 풀 GKE 클러스터(Standard edition, standard mode)를 생성합니다.
  • GitLab Runner Kubernetes operator를 사용해 클러스터에 GitLab Runner를 설치합니다.

다음 예시는 GRIT을 사용해 Google Kubernetes 클러스터와 GitLab Runner Manager를 배포합니다.

클러스터와 GitLab Runner를 올바르게 구성하려면 다음 정보를 고려합니다.

  • 다뤄야 하는 job 유형이 몇 가지인지 확인합니다.
    • 이 정보는 평가 단계에서 도출됩니다. 평가 단계는 메트릭을 집계하고 조직의 제약 조건을 고려하여 결과 그룹의 수를 식별합니다. "job 유형"은 평가 단계에서 식별된 분류된 job의 집합입니다. 이 분류는 job에 필요한 최대 리소스를 기준으로 합니다.
  • 실행해야 하는 GitLab Runner Manager 수를 확인합니다.
    • 이 정보는 계획 단계에서 도출됩니다. 조직이 프로젝트를 개별적으로 관리한다면 이 프레임워크를 프로젝트마다 개별적으로 적용합니다. 이 접근 방식은 여러 job 프로필이 식별되고(조직 전체 또는 특정 프로젝트에 대해), 이를 개별 또는 여러 GitLab Runner로 구성된 플릿이 모두 처리하는 경우에만 관련이 있습니다. 기본 구성에서는 일반적으로 GKE 클러스터당 GitLab Runner Manager 1개를 사용합니다.
  • 예상되는 최대 동시 CI/CD job 수를 확인합니다.
    • 이 정보는 특정 시점에 실행되는 최대 동시 CI/CD job 수의 추정치를 나타냅니다. 이 정보는 GitLab Runner Manager를 구성할 때 필요하며, 가용 리소스가 제한된 노드에서 job pod를 스케줄링하는 Prepare 단계에서 대기하는 시간을 결정하는 데 사용됩니다.

FastAPI 포크의 실제 적용 사례#

FastAPI 포크의 경우 다음 정보를 고려합니다.

  • 다뤄야 하는 job 프로필이 몇 개인지 확인합니다.
    • job 프로필은 1 CPU와 303 Mi 메모리라는 특성을 가진 1개입니다. 수집된 메트릭 분석 섹션에서 설명한 대로 이 원시 값은 다음과 같이 변경됩니다.
      • 메모리 제한으로 인한 job 실패를 방지하기 위해 메모리 제한을 303 Mi 대신 400 Mi로 설정합니다.
      • CPU는 1 CPU 대신 0.20으로 설정합니다. 이 예시에서는 작업을 완료할 때 속도보다 정확성과 품질을 우선시합니다.
  • 실행해야 하는 GitLab Runner Manager 수를 확인합니다.
    • 테스트에는 GitLab Runner Manager 1개면 충분합니다.
  • 예상 워크로드를 확인합니다.
    • 언제든지 최대 20개의 job을 동시에 실행하려고 합니다.

이 입력값을 기준으로 다음 최소 특성을 충족하는 GKE 클러스터라면 충분합니다.

  • 최소 CPU: (0.20 + helper CPU 사용량) * 동시 실행 job 수. 이 예시에서는 helper 컨테이너 제한을 0.15 CPU로 설정하면 7 vCPU가 됩니다.
  • 최소 메모리: (400Mi + helper 메모리 사용량) * 동시 실행 job 수. 이 예시에서는 helper 제한을 100 Mi로 설정하면 최소 10 Gi가 필요합니다.

필요한 최소 스토리지와 같은 다른 특성도 고려해야 하지만, 이 예시에서는 다루지 않습니다.

GKE 클러스터에 가능한 구성은 다음과 같습니다(두 구성 모두 20개를 초과하는 job을 동시에 실행할 수 있습니다).

  • e2-standard-4 노드 3개로 구성된 노드 풀을 사용하는 GKE 클러스터(총 12 vCPU, 48 GiB 메모리)
  • e2-standard-8 노드 1개로만 구성된 노드 풀을 사용하는 GKE 클러스터(총 8 vCPU, 32 GiB 메모리)

이 예시에서는 첫 번째 구성을 사용합니다. GitLab Runner Manager의 로그 처리가 전체 로그 처리에 영향을 미치지 않도록 GitLab Runner를 설치하는 전용 노드 풀을 사용합니다.

GKE GRIT 구성#

결과로 생성되는 GRIT의 GKE 구성은 다음과 유사합니다.

google_project     = "GCLOUD_PROJECT"
google_region      = "GCLOUD_REGION"
google_zone        = "GCLOUD_ZONE"
name               = "my-grit-gke-cluster"
node_pools = {
  "runner-manager" = {
    node_count = 1,
    node_config = {
      machine_type = "e2-standard-2",
      image_type   = "cos_containerd",   #Linux OS container only. Change to windows_ltsc_containerd for Windows OS container
      disk_size_gb = 50,
      disk_type    = "pd-balanced",
      labels = {
        "app" = "gitlab-runner",
      }
    },
  },
  "worker-pool" = {
    node_count = 3,
    node_config = {
      machine_type = "e2-standard-4",    #4 vCPU, 16 GB each
      image_type   = "cos_containerd",   #Linux OS container only. Change to windows_ltsc_containerd for Windows OS container
      disk_size_gb = 150,
      disk_type    = "pd-balanced",
      labels = {
        "app" = "gitlab-runner-job"
      }
    },
  },
}

앞선 구성에서:

  • runner-manager 블록은 GitLab Runner가 설치되는 노드 풀을 가리킵니다. 이 예시에서는 e2-standard-2면 충분합니다.
  • runner-manager 블록의 labels 섹션은 GitLab Runner를 설치할 때 유용합니다. operator 구성을 통해 노드 셀렉터를 설정하여 GitLab Runner가 이 노드 풀의 노드에 설치되도록 합니다.
  • worker-pool 블록은 CI/CD job pod가 생성되는 노드 풀을 가리킵니다. 제공된 구성은 job pod를 호스팅하기 위해 "app" = "gitlab-runner-job" 레이블이 지정된 e2-standard-4 노드 3개로 구성된 노드 풀을 생성합니다.
  • image_type 매개변수를 사용해 노드에서 사용하는 이미지를 설정할 수 있습니다. 워크로드가 주로 Windows 이미지에 의존하는 경우 windows_ltsc_containerd로 설정할 수 있습니다.

이 구성을 보여주는 그림은 다음과 같습니다.
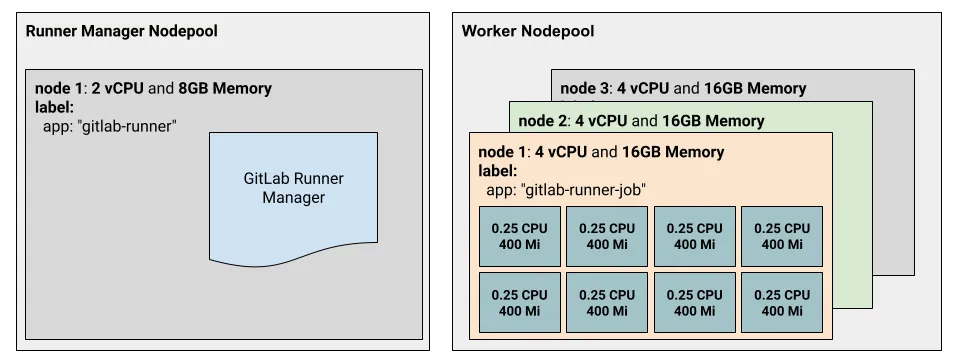
클러스터 구성 그림

GitLab Runner GRIT 구성#

결과로 생성되는 GRIT의 GitLab Runner 구성은 다음과 유사합니다.

gitlab_pat         = "glpat-REDACTED"
gitlab_project_id  = GITLAB_PROJECT_ID
runner_description = "my-grit-gitlab-runner"
runner_image       = "registry.gitlab.com/gitlab-org/ci-cd/gitlab-runner-ubi-images/gitlab-runner-ocp:amd64-v17.3.1"
helper_image       = "registry.gitlab.com/gitlab-org/ci-cd/gitlab-runner-ubi-images/gitlab-runner-helper-ocp:x86_64-v17.3.1"
concurrent     = 20
check_interval = 1
runner_tags    = ["my-custom-tag"]
config_template    = <

앞선 구성에서:

  • pod_spec 매개변수를 사용하면 GitLab Runner를 실행하는 pod의 노드 셀렉터를 설정할 수 있습니다. 이 구성에서는 GitLab Runner가 runner-manager 노드 풀에 설치되도록 노드 셀렉터를 "app" = "gitlab-runner"로 설정합니다.
  • config_template 매개변수는 GitLab Runner Manager가 실행하는 모든 job에 기본 제한을 제공합니다. 또한 설정된 값이 기본값을 초과하지 않는 한 이러한 제한의 오버라이트를 허용합니다.
  • job 실패 시 디버깅을 쉽게 하기 위해 기능 플래그 FF_PRINT_POD_EVENTS와 print_pod_warning_events 설정도 지정합니다. 자세한 내용은 기능 플래그 문서와 러너 API 권한 구성 문서를 참고합니다.

가상 사용 사례의 실제 적용#

다음 정보를 고려합니다.

  • 다뤄야 하는 job 프로필이 몇 개인지 확인합니다.
    • 프로필 2개(제공된 사양은 helper 제한을 반영합니다):
      • 중간 규모 job: 300m CPU, 200 MiB
      • CPU 집약적 job: 1 CPU, 1 GiB
  • 실행해야 하는 GitLab Runner Manager 수를 확인합니다.
    • 1개.
  • 예상 워크로드를 확인합니다.
    • 중간 규모 job 최대 50개 동시 실행
    • CPU 집약적 job 최대 25개 동시 실행

GKE 구성#

  • 중간 규모 job에 필요한 리소스:
    • CPU: 300m * 50 = 5 CPU(근사치)
    • 메모리: 200 MiB * 50 = 10 GiB
  • CPU 집약적 job에 필요한 리소스:
    • CPU: 1 * 25 = 25
    • 메모리: 1 GiB * 25 = 25 GiB

GKE 클러스터는 다음을 갖춰야 합니다.

  • GitLab Runner Manager용 노드 풀(로그 처리 부담이 크지 않다고 가정): e2-standard-2 노드 1개
  • 중간 규모 job용 노드 풀: e2-standard-4 노드 3개
  • CPU 집약적 job용 노드 풀: e2-highcpu-32 노드 1개(32 vCPU, 32 GiB 메모리)
google_project     = "GCLOUD_PROJECT"
google_region      = "GCLOUD_REGION"
google_zone        = "GCLOUD_ZONE"
name               = "my-grit-gke-cluster"
node_pools = {
  "runner-manager" = {
    node_count = 1,
    node_config = {
      machine_type = "e2-standard-2",
      image_type   = "cos_containerd",   #Linux OS container only. Change to windows_ltsc_containerd for Windows OS container
      disk_size_gb = 50,
      disk_type    = "pd-balanced",
      labels = {
        "app" = "gitlab-runner",
      }
    },
  },
  "medium-pool" = {
    node_count = 3,
    node_config = {
      machine_type = "e2-standard-4",    #4 vCPU, 16 GB each
      image_type   = "cos_containerd",   #Linux OS container only. Change to windows_ltsc_containerd for Windows OS container
      disk_size_gb = 150,
      disk_type    = "pd-balanced",
      labels = {
        "app" = "gitlab-runner-job"
      }
    },
  },
  "cpu-intensive-pool" = {
    node_count = 1,
    node_config = {
      machine_type = "e2-highcpu-32", #32 vCPU, 32 GB each
      image_type   = "cos_containerd",
      disk_size_gb = 150,
      disk_type    = "pd-balanced",
      labels = {
        "app" = "gitlab-runner-job"
      }
    },
  },
}

GitLab Runner 구성#

현재 GRIT 구현은 한 번에 하나 이상의 러너를 설치할 수 없습니다. 제공된 config_template은 앞선 예시처럼 node_selection이나 다른 제한과 같은 구성을 설정하지 않습니다. 간단한 구성은 CPU 집약적 job에 허용되는 최대 오버라이트 값을 허용하고 .gitlab-ci.yml 파일에 올바른 값을 설정합니다. 결과로 생성되는 GitLab Runner 구성은 다음과 유사합니다.

gitlab_pat         = "glpat-REDACTED"
gitlab_project_id  = GITLAB_PROJECT_ID
runner_description = "my-grit-gitlab-runner"
runner_image       = "registry.gitlab.com/gitlab-org/ci-cd/gitlab-runner-ubi-images/gitlab-runner-ocp:amd64-v17.3.1"
helper_image       = "registry.gitlab.com/gitlab-org/ci-cd/gitlab-runner-ubi-images/gitlab-runner-helper-ocp:x86_64-v17.3.1"
concurrent     = 100
check_interval = 1
runner_tags    = ["my-custom-tag"]
config_template    = <

.gitlab-ci.yml 파일은 다음과 유사합니다.

  • 중간 규모 job의 경우:

    variables:
      KUBERNETES_CPU_LIMIT: "200m"
      KUBERNETES_MEMORY_LIMIT: "100Mi"
      KUBERNETES_HELPER_CPU_LIMIT: "100m"
      KUBERNETES_HELPER_MEMORY_LIMIT: "100Mi"
    
    tests:
      image: some-image:latest
      script:
      - command_1
      - command_2
      # ...
      - command_n
      tags:
        - my-custom-tag
    
  • CPU 집약적 job의 경우:

    variables:
      KUBERNETES_CPU_LIMIT: "0.75"
      KUBERNETES_MEMORY_LIMIT: "900Mi"
      KUBERNETES_HELPER_CPU_LIMIT: "150m"
      KUBERNETES_HELPER_MEMORY_LIMIT: "100Mi"
    
    tests:
      image: custom-cpu-intensive-image:latest
      script:
      - cpu_intensive_command_1
      - cpu_intensive_command_2
      # ...
      - cpu_intensive_command_n
      tags:
        - my-custom-tag
    
Note

구성을 더 쉽게 하려면 job 프로필마다 클러스터당 GitLab Runner 1개를 사용합니다. GitLab이 동일한 클러스터에 여러 GitLab Runner를 설치하거나 config.toml 템플릿에 여러 [[runners]] 섹션을 지원할 때까지는 이 방식을 권장합니다.

모니터링 및 옵저버빌리티 설정#

배포 단계의 마지막 단계로 러너 호스트 환경과 GitLab Runner를 모니터링하는 솔루션을 구축해야 합니다. 인프라 수준, 러너, CI/CD job 메트릭은 CI/CD 빌드 인프라의 효율성과 안정성에 대한 인사이트를 제공합니다. 또한 Kubernetes 클러스터, GitLab Runner, CI/CD job 구성을 조정하고 최적화하는 데 필요한 인사이트도 제공합니다.

모니터링 모범 사례#

  • job 수준 메트릭(job 소요 시간, job 성공률 및 실패율)을 모니터링합니다.
    • job 수준 메트릭을 분석하려면 어떤 CI/CD job이 가장 자주 실행되고 전체적으로 가장 많은 컴퓨팅 및 RAM 리소스를 소비하는지 파악합니다. 이 job 프로필은 최적화 기회를 평가하기 위한 좋은 출발점입니다.
  • Kubernetes 클러스터 리소스 사용률을 모니터링합니다.
    • CPU 사용률
    • 메모리 사용률
    • 네트워크 사용률
    • 디스크 사용률

진행 방법에 대한 자세한 내용은 GitLab Runner 전용 모니터링 페이지를 참고합니다.

최적화#

CI/CD 빌드 환경을 최적화하는 작업은 지속적인 프로세스입니다. CI/CD job의 유형과 양이 끊임없이 변화하므로 지속적인 관여가 필요합니다.

CI/CD 및 CI/CD 빌드 인프라에 대해 조직 고유의 목표가 있을 것입니다. 따라서 첫 번째 단계는 최적화 요구 사항과 정량화 가능한 목표를 정의하는 것입니다.

다음은 고객 전반에서 확인한 최적화 요구 사항의 예시입니다.

  • CI/CD job 시작 시간
  • CI/CD job 소요 시간
  • CI/CD job 안정성
  • CI/CD 컴퓨팅 비용 최적화

다음 단계는 Kubernetes 클러스터의 인프라 메트릭과 함께 CI/CD 메트릭을 분석하는 것입니다. 분석해야 할 핵심 상관관계는 다음과 같습니다.

  • Kubernetes 네임스페이스별 CPU 사용률
  • Kubernetes 네임스페이스별 메모리 사용률
  • 노드별 CPU 사용률
  • 노드별 메모리 사용률
  • CI/CD job 실패율

일반적으로 Kubernetes에서 높은 CI/CD job 실패율은(불안정한 테스트로 인한 실패는 제외) Kubernetes 클러스터의 리소스 제약에서 비롯됩니다. 이러한 메트릭을 분석하여 Kubernetes 클러스터 구성에서 CI/CD job 시작 시간, job 소요 시간, job 안정성, 인프라 리소스 사용률 간 최적의 균형을 달성합니다.

모범 사례#

  • 조직 전체에서 CI/CD job을 job 유형별로 분류하는 프로세스를 수립합니다.
  • Kubernetes에서 GitLab CI/CD 빌드 인프라와 CI/CD job 유형을 최적화하는 접근 방식과 모니터링 구성을 모두 단순화하는 job 유형 분류 프레임워크를 수립합니다.
  • 각 job 유형에 클러스터에서 전용 노드를 할당하면 CI/CD job 성능, job 안정성, 인프라 사용률 간 최상의 균형을 얻을 수 있습니다.

CI/CD 빌드 환경의 인프라 스택으로 Kubernetes를 사용하면 상당한 이점을 얻을 수 있습니다. 다만 Kubernetes 인프라를 지속적으로 모니터링하고 최적화해야 합니다. 옵저버빌리티 및 최적화 프레임워크를 구축하면 월 수백만 건의 CI/CD job을 지원할 수 있습니다. 리소스 경합을 없애고, 결정론적인 CI/CD job 실행과 최적의 리소스 사용을 달성할 수 있습니다. 이러한 개선은 운영 효율성과 비용 최적화로 이어집니다.

다음 단계#

더 나은 사용자 경험을 제공하려면 다음 단계를 수행합니다.

  • 동일한 클러스터에 여러 GitLab Runner를 설치하는 기능을 지원합니다. 이를 통해 여러 job 프로필을 처리해야 하는 시나리오를 더 잘 관리할 수 있습니다(리소스 오남용을 방지하도록 GitLab Runner를 적절히 구성할 수 있습니다).
  • GKE 노드 오토스케일링을 지원합니다. 이를 통해 GKE가 워크로드에 따라 확장 및 축소되어 비용을 절감할 수 있습니다.
  • job 메트릭 모니터링을 활성화합니다. 이를 통해 관리자가 실제 사용량을 기반으로 클러스터와 GitLab Runner를 더 잘 최적화할 수 있습니다.

Google Kubernetes Engine에서 GitLab Runner 플릿 설계 및 구성

GitLab v19.4
Tier: Free, Premium, Ultimate
Offering: GitLab.com, GitLab Self-Managed
원문 보기

요약

이 권장 사항을 사용하여 CI/CD 빌드 요구 사항을 분석하고, Google Kubernetes Engine(GKE)에서 호스팅되는 GitLab Runner 플릿을 설계, 구성, 검증합니다. 다음 다이어그램은 러너 플릿 구현 여정의 경로를 보여줍니다.

이 권장 사항을 사용하여 CI/CD 빌드 요구 사항을 분석하고, Google Kubernetes Engine(GKE)에서 호스팅되는 GitLab Runner 플릿을 설계, 구성, 검증합니다.

다음 다이어그램은 러너 플릿 구현 여정의 경로를 보여줍니다. 이 가이드는 다음 단계를 따릅니다.

러너 플릿 단계 다이어그램

이 프레임워크를 사용하여 단일 그룹 또는 조직 전체를 지원하는 GitLab 인스턴스의 러너 배포를 계획할 수 있습니다.

이 프레임워크는 다음 단계로 구성됩니다.

  1. 예상 CI/CD 워크로드 평가
  2. 러너 플릿 구성 계획
  3. GKE에 러너 배포
  4. 최적화

예상 CI/CD 워크로드 평가#

이 단계에서는 지원 대상 개발팀의 CI/CD 빌드 요구 사항을 수집합니다. 해당하는 경우 사용 중인 프로그래밍, 스크립팅, 마크업 언어의 목록을 작성합니다.

여러 개발팀, 다양한 프로그래밍 언어, 빌드 요구 사항을 지원하고 있을 수 있습니다. 첫 번째 심층 분석에서는 한 팀, 한 프로젝트, 한 세트의 CI/CD 빌드 요구 사항으로 시작합니다.

예상 CI/CD 워크로드를 평가하려면 다음을 수행합니다.

  • 지원할 것으로 예상되는 CI/CD job 수요를 추정합니다(시간별, 일별, 주별).
  • 특정 프로젝트의 대표 샘플 CI/CD job에 필요한 CPU 및 RAM 리소스 요구 사항을 추정합니다. 이 추정치는 지원할 수 있는 다양한 프로필을 식별하는 데 도움이 됩니다. 이러한 프로필의 특성은 요구 사항을 지원하는 데 필요한 적절한 GKE 클러스터를 식별하는 데 중요합니다. CPU 및 RAM 요구 사항을 결정하는 방법은 다음 예시를 참고합니다.
  • 그룹 또는 프로젝트별로 특정 러너에 대한 접근을 분리해야 하는 보안 또는 정책 요구 사항이 있는지 확인합니다.

CI/CD job의 CPU 및 RAM 요구 사항 추정#

CPU 및 RAM 리소스 요구 사항은 프로그래밍 언어 유형이나 CI/CD job 유형(빌드, 통합 테스트, 단위 테스트, 보안 스캔)과 같은 요인에 따라 달라집니다. 다음 섹션에서는 CI/CD job의 CPU 및 리소스 요구 사항을 수집하는 방법을 설명합니다. 이 접근 방식을 자신의 필요에 맞게 채택하고 발전시킬 수 있습니다.

예를 들어 FastAPI 프로젝트 포크인 ra-group/fastapi에 정의된 것과 유사한 CI/CD job을 실행하는 경우를 살펴봅니다. 이 예시의 job은 Python 이미지를 사용해 프로젝트의 필요 패키지를 다운로드하고 기존 단위 테스트를 실행합니다. 이 job의 .gitlab-ci.yml은 다음과 같습니다.

tests:
  image: python:3.11.10-bookworm
  parallel: 25
  script:
  - pip install -r requirements.txt
  - pytest

필요한 컴퓨팅 및 RAM 리소스를 식별하려면 Docker를 사용하여 다음을 수행합니다.

  • FastAPI 포크와 CI/CD job 스크립트를 entrypoint로 사용하는 특정 이미지를 생성합니다.
  • 빌드한 이미지로 컨테이너를 실행하고 리소스 사용량을 모니터링합니다.

필요한 컴퓨팅 및 RAM 리소스를 식별하려면 다음 단계를 완료합니다.

  1. 모든 CI 명령이 포함된 스크립트 파일을 프로젝트에 생성합니다. 이 스크립트 파일의 이름은 entrypoint.sh입니다.

    #!/bin/bash
    cd /fastapi || exit
    pip install -r requirements.txt
    pytest
    
  2. entrypoint.sh 파일이 CI 스크립트를 실행하는 이미지를 생성하도록 Dockerfile을 작성합니다.

    FROM python:3.11.10-bookworm
    RUN mkdir /fastapi
    COPY . /fastapi
    RUN chmod +x /fastapi/entrypoint.sh
    CMD [ "bash", "/fastapi/entrypoint.sh" ]
    
  3. 이미지를 빌드합니다. 프로세스를 단순화하려면 빌드, 저장, 이미지 실행과 같은 모든 작업을 로컬에서 수행합니다. 이 방식을 사용하면 이미지를 풀·푸시하기 위한 온라인 레지스트리가 필요하지 않습니다.

    ❯ docker build . -t my-project_dir/fastapi:testing
    ...
    Successfully tagged my-project_dir/fastapi:testing
    
  4. 빌드한 이미지로 컨테이너를 실행하면서 컨테이너 실행 중 리소스 사용량을 동시에 모니터링합니다. 다음 명령으로 metrics.sh라는 이름의 스크립트를 생성합니다.

    #! /bin/bash
    
    container_id=$(docker run -d --rm my-project_dir/fastapi:testing)
    
    while true; do
        echo "Collecting metrics..."
        metrics=$(docker stats --no-trunc --no-stream --format "table {}\t{}\t{}" | grep "$container_id")
        if [ -z "$metrics" ]; then
            exit 0
        fi
        echo "Saving metrics..."
        echo "$metrics" >> metrics.log
        sleep 1
    done
    

    이 스크립트는 빌드한 이미지로 detached 컨테이너를 실행합니다. 그런 다음 컨테이너 ID를 사용해 컨테이너가 정상적으로 종료될 때까지 CPU 및 Memory 사용량을 수집합니다. 수집된 메트릭은 metrics.log라는 파일에 저장됩니다.

    [!note] 이 예시에서는 CI/CD job이 단기간 실행되므로 컨테이너 폴링 간 sleep 값을 1초로 설정합니다. 필요에 따라 이 값을 조정합니다.

  5. metrics.log 파일을 분석해 테스트 컨테이너의 최대 사용량을 식별합니다.

    이 예시에서 최대 CPU 사용량은 107.50%, 최대 메모리 사용량은 303.1Mi입니다.

    223e93dd05c6   94.98%    83.79MiB / 15.58GiB
    223e93dd05c6   28.27%    85.4MiB / 15.58GiB
    223e93dd05c6   53.92%    121.8MiB / 15.58GiB
    223e93dd05c6   70.73%    171.9MiB / 15.58GiB
    223e93dd05c6   20.78%    177.2MiB / 15.58GiB
    223e93dd05c6   26.19%    180.3MiB / 15.58GiB
    223e93dd05c6   77.04%    224.1MiB / 15.58GiB
    223e93dd05c6   97.16%    226.5MiB / 15.58GiB
    223e93dd05c6   98.52%    259MiB / 15.58GiB
    223e93dd05c6   98.78%    303.1MiB / 15.58GiB
    223e93dd05c6   100.03%   159.8MiB / 15.58GiB
    223e93dd05c6   103.97%   204MiB / 15.58GiB
    223e93dd05c6   107.50%   207.8MiB / 15.58GiB
    223e93dd05c6   105.96%   215.7MiB / 15.58GiB
    223e93dd05c6   101.88%   226.2MiB / 15.58GiB
    223e93dd05c6   100.44%   226.7MiB / 15.58GiB
    223e93dd05c6   100.20%   226.9MiB / 15.58GiB
    223e93dd05c6   100.60%   227.6MiB / 15.58GiB
    223e93dd05c6   100.46%   228MiB / 15.58GiB
    

수집된 메트릭 분석#

수집된 메트릭을 기반으로 이 job 프로필의 경우 Kubernetes executor job을 1 CPU와 ~304 Mi의 메모리로 제한할 수 있습니다. 이 결론이 정확하더라도 모든 사용 사례에 실용적이지 않을 수 있습니다.

e2-standard-4 노드 3개로 구성된 노드 풀이 있는 클러스터에서 job을 실행하는 경우 1 CPU 제한으로 동시에 실행할 수 있는 job은 12개뿐입니다(e2-standard-4 노드는 4 vCPU와 16GB 메모리를 제공합니다). 추가 job은 실행 중인 job이 완료되어 리소스가 확보될 때까지 대기합니다.

Kubernetes는 클러스터에 설정되거나 사용 가능한 제한보다 더 많은 메모리를 사용하는 Pod를 종료하므로 요청한 메모리 값이 중요합니다. 반면 CPU 제한은 더 유연하지만 job 소요 시간에 영향을 미칩니다. CPU 제한을 낮게 설정하면 job 완료에 걸리는 시간이 늘어납니다. 앞선 예시에서 CPU 제한을 1 대신 250m(또는 0.25)로 설정하면 job 소요 시간이 4배 늘어납니다(약 2분에서 8~10분으로).

메트릭 수집 방식이 폴링 메커니즘을 사용하므로 식별된 최대 사용량은 올림 처리해야 합니다. 예를 들어 메모리 사용량은 303 Mi 대신 400 Mi로 올림 처리합니다.

앞선 예시에서 중요하게 고려할 사항은 다음과 같습니다.

  • 이 메트릭은 Google Kubernetes Engine 클러스터와 CPU 구성이 다른 로컬 머신에서 수집되었습니다. 다만 e2-standard-4 노드가 있는 Kubernetes 클러스터에서 모니터링하여 이 메트릭을 검증했습니다.
  • 이러한 메트릭을 정확하게 파악하려면 평가 단계에서 설명한 테스트를 Google Compute Engine VM에서 실행합니다.

러너 플릿 구성 계획#

계획 단계에서는 조직에 적합한 러너 플릿 구성을 설계합니다. 다음을 기준으로 러너 스코프(인스턴스, 그룹, 프로젝트)와 Kubernetes 클러스터 구성을 고려합니다.

  • CI/CD job 리소스 수요 평가 결과
  • CI/CD job 유형 목록

러너 스코프#

러너 스코프를 계획하려면 다음 질문을 고려합니다.

  • 프로젝트 소유자와 그룹 소유자가 직접 러너를 생성하고 관리하도록 할지 검토합니다.

    • 기본적으로 프로젝트 및 그룹 소유자는 러너 구성을 생성하고 GitLab의 프로젝트 또는 그룹에 러너를 등록할 수 있습니다.
    • 이 설계를 사용하면 개발자가 빌드 환경을 빠르게 생성할 수 있습니다. 이 방식은 GitLab CI/CD를 처음 시작할 때 개발자가 겪는 마찰을 줄여줍니다. 다만 대규모 조직에서는 이 방식으로 인해 환경 전반에 활용도가 낮거나 사용되지 않는 러너가 많아질 수 있습니다.
  • 특정 유형의 러너에 대한 접근을 특정 그룹이나 프로젝트로 분리해야 하는 보안 또는 기타 정책이 조직에 있는지 확인합니다.

GitLab Self-Managed 환경에서 러너를 배포하는 가장 간단한 방법은 인스턴스용으로 생성하는 것입니다. 인스턴스로 스코프가 지정된 러너는 기본적으로 모든 그룹과 프로젝트에서 사용할 수 있습니다.

인스턴스 러너만으로 조직의 모든 요구 사항을 충족할 수 있다면 이 배포 패턴이 가장 효율적입니다. 이 패턴을 사용하면 대규모 CI/CD 빌드 플릿을 효율적이고 비용 효과적으로 운영할 수 있습니다.

특정 러너에 대한 접근을 특정 그룹이나 프로젝트로 분리해야 하는 요구 사항이 있다면 이를 계획 프로세스에 반영합니다.

러너 플릿 구성 예시 - 인스턴스 러너#

표의 구성은 조직의 러너 플릿을 구성할 때 활용할 수 있는 유연성을 보여줍니다. 이 예시는 인스턴스 크기와 job 태그가 서로 다른 여러 러너를 사용합니다. 이러한 러너를 사용하면 CPU 및 RAM 리소스 요구 사항이 각기 다른 여러 유형의 CI/CD job을 지원할 수 있습니다. 다만 Kubernetes를 사용할 때는 가장 효율적인 패턴이 아닐 수 있습니다.

러너 유형 러너 태그 스코프 제공할 러너 유형 수 러너 워커 사양 러너 호스트 환경 환경 구성
인스턴스 ci-runner-small 기본적으로 모든 그룹과 프로젝트에서 CI/CD job을 실행할 수 있습니다. 5 2 vCPU, 8 GB RAM Kubernetes → 노드 3개
→ 러너 워커 컴퓨팅 노드 = e2-standard-2
인스턴스 ci-runner-medium 기본적으로 모든 그룹과 프로젝트에서 CI/CD job을 실행할 수 있습니다. 2 4 vCPU, 16 GB RAM Kubernetes → 노드 3개
→ 러너 워커 컴퓨팅 노드 = e2-standard-4
인스턴스 ci-runner-large 기본적으로 모든 그룹과 프로젝트에서 CI/CD job을 실행할 수 있습니다. 1 8 vCPU, 32 GB RAM Kubernetes → 노드 3개
→ 러너 워커 컴퓨팅 노드 = e2-standard-8

이 러너 플릿 구성 예시에는 총 3개의 러너 구성과 CI/CD job을 실행 중인 러너 8개가 있습니다.

Kubernetes executor를 사용하면 Kubernetes 스케줄러를 활용하고 컨테이너 리소스를 오버라이트할 수 있습니다. 이론적으로는 적절한 리소스를 갖춘 Kubernetes 클러스터에 단일 GitLab Runner를 배포할 수 있습니다. 그런 다음 컨테이너 리소스를 오버라이트하여 각 CI/CD job에 적합한 컴퓨팅 유형을 선택할 수 있습니다. 이 패턴을 구현하면 배포하고 운영해야 하는 개별 러너 구성 수를 줄일 수 있습니다.

모범 사례#

  • 항상 러너 매니저 전용 노드 풀을 지정합니다.
    • 로그 처리와 캐시 또는 아티팩트 관리는 CPU를 많이 사용할 수 있습니다.
  • config.toml 파일에 항상 기본 제한(Build/Helper/Service 컨테이너의 CPU/Memory)을 설정합니다.
  • config.toml 파일에서 리소스에 대해 항상 최대 오버라이트를 허용합니다.
  • job 정의(.gitlab-ci.yml)에 job에 필요한 적절한 제한을 지정합니다.
    • 지정하지 않으면 config.toml 파일에 설정된 기본값이 사용됩니다.
    • 컨테이너가 메모리 제한을 초과하면 시스템이 OOM(Out of Memory) kill 프로세스를 사용해 컨테이너를 자동으로 종료합니다.
  • 기능 플래그 FF_PRINT_POD_EVENTS와 print_pod_warning_events 설정을 사용합니다. 자세한 내용은 기능 플래그 문서와 러너 API 권한 구성 문서를 참고합니다.

GKE에 러너 배포#

Google Kubernetes 클러스터에 GitLab Runner를 설치할 준비가 되면 다양한 옵션을 사용할 수 있습니다. GKE에 클러스터를 이미 생성했다면 GitLab Runner Helm Chart 또는 Operator를 사용해 클러스터에 러너를 설치할 수 있습니다.

GKE에 클러스터를 아직 설정하지 않았다면 GitLab에서 제공하는 GitLab Runner Infrastructure Toolkit(GRIT)을 사용해 다음을 동시에 수행할 수 있습니다.

  • 멀티 노드 풀 GKE 클러스터(Standard edition, standard mode)를 생성합니다.
  • GitLab Runner Kubernetes operator를 사용해 클러스터에 GitLab Runner를 설치합니다.

다음 예시는 GRIT을 사용해 Google Kubernetes 클러스터와 GitLab Runner Manager를 배포합니다.

클러스터와 GitLab Runner를 올바르게 구성하려면 다음 정보를 고려합니다.

  • 다뤄야 하는 job 유형이 몇 가지인지 확인합니다.
    • 이 정보는 평가 단계에서 도출됩니다. 평가 단계는 메트릭을 집계하고 조직의 제약 조건을 고려하여 결과 그룹의 수를 식별합니다. "job 유형"은 평가 단계에서 식별된 분류된 job의 집합입니다. 이 분류는 job에 필요한 최대 리소스를 기준으로 합니다.
  • 실행해야 하는 GitLab Runner Manager 수를 확인합니다.
    • 이 정보는 계획 단계에서 도출됩니다. 조직이 프로젝트를 개별적으로 관리한다면 이 프레임워크를 프로젝트마다 개별적으로 적용합니다. 이 접근 방식은 여러 job 프로필이 식별되고(조직 전체 또는 특정 프로젝트에 대해), 이를 개별 또는 여러 GitLab Runner로 구성된 플릿이 모두 처리하는 경우에만 관련이 있습니다. 기본 구성에서는 일반적으로 GKE 클러스터당 GitLab Runner Manager 1개를 사용합니다.
  • 예상되는 최대 동시 CI/CD job 수를 확인합니다.
    • 이 정보는 특정 시점에 실행되는 최대 동시 CI/CD job 수의 추정치를 나타냅니다. 이 정보는 GitLab Runner Manager를 구성할 때 필요하며, 가용 리소스가 제한된 노드에서 job pod를 스케줄링하는 Prepare 단계에서 대기하는 시간을 결정하는 데 사용됩니다.

FastAPI 포크의 실제 적용 사례#

FastAPI 포크의 경우 다음 정보를 고려합니다.

  • 다뤄야 하는 job 프로필이 몇 개인지 확인합니다.
    • job 프로필은 1 CPU와 303 Mi 메모리라는 특성을 가진 1개입니다. 수집된 메트릭 분석 섹션에서 설명한 대로 이 원시 값은 다음과 같이 변경됩니다.
      • 메모리 제한으로 인한 job 실패를 방지하기 위해 메모리 제한을 303 Mi 대신 400 Mi로 설정합니다.
      • CPU는 1 CPU 대신 0.20으로 설정합니다. 이 예시에서는 작업을 완료할 때 속도보다 정확성과 품질을 우선시합니다.
  • 실행해야 하는 GitLab Runner Manager 수를 확인합니다.
    • 테스트에는 GitLab Runner Manager 1개면 충분합니다.
  • 예상 워크로드를 확인합니다.
    • 언제든지 최대 20개의 job을 동시에 실행하려고 합니다.

이 입력값을 기준으로 다음 최소 특성을 충족하는 GKE 클러스터라면 충분합니다.

  • 최소 CPU: (0.20 + helper CPU 사용량) * 동시 실행 job 수. 이 예시에서는 helper 컨테이너 제한을 0.15 CPU로 설정하면 7 vCPU가 됩니다.
  • 최소 메모리: (400Mi + helper 메모리 사용량) * 동시 실행 job 수. 이 예시에서는 helper 제한을 100 Mi로 설정하면 최소 10 Gi가 필요합니다.

필요한 최소 스토리지와 같은 다른 특성도 고려해야 하지만, 이 예시에서는 다루지 않습니다.

GKE 클러스터에 가능한 구성은 다음과 같습니다(두 구성 모두 20개를 초과하는 job을 동시에 실행할 수 있습니다).

  • e2-standard-4 노드 3개로 구성된 노드 풀을 사용하는 GKE 클러스터(총 12 vCPU, 48 GiB 메모리)
  • e2-standard-8 노드 1개로만 구성된 노드 풀을 사용하는 GKE 클러스터(총 8 vCPU, 32 GiB 메모리)

이 예시에서는 첫 번째 구성을 사용합니다. GitLab Runner Manager의 로그 처리가 전체 로그 처리에 영향을 미치지 않도록 GitLab Runner를 설치하는 전용 노드 풀을 사용합니다.

GKE GRIT 구성#

결과로 생성되는 GRIT의 GKE 구성은 다음과 유사합니다.

google_project     = "GCLOUD_PROJECT"
google_region      = "GCLOUD_REGION"
google_zone        = "GCLOUD_ZONE"
name               = "my-grit-gke-cluster"
node_pools = {
  "runner-manager" = {
    node_count = 1,
    node_config = {
      machine_type = "e2-standard-2",
      image_type   = "cos_containerd",   #Linux OS container only. Change to windows_ltsc_containerd for Windows OS container
      disk_size_gb = 50,
      disk_type    = "pd-balanced",
      labels = {
        "app" = "gitlab-runner",
      }
    },
  },
  "worker-pool" = {
    node_count = 3,
    node_config = {
      machine_type = "e2-standard-4",    #4 vCPU, 16 GB each
      image_type   = "cos_containerd",   #Linux OS container only. Change to windows_ltsc_containerd for Windows OS container
      disk_size_gb = 150,
      disk_type    = "pd-balanced",
      labels = {
        "app" = "gitlab-runner-job"
      }
    },
  },
}

앞선 구성에서:

  • runner-manager 블록은 GitLab Runner가 설치되는 노드 풀을 가리킵니다. 이 예시에서는 e2-standard-2면 충분합니다.
  • runner-manager 블록의 labels 섹션은 GitLab Runner를 설치할 때 유용합니다. operator 구성을 통해 노드 셀렉터를 설정하여 GitLab Runner가 이 노드 풀의 노드에 설치되도록 합니다.
  • worker-pool 블록은 CI/CD job pod가 생성되는 노드 풀을 가리킵니다. 제공된 구성은 job pod를 호스팅하기 위해 "app" = "gitlab-runner-job" 레이블이 지정된 e2-standard-4 노드 3개로 구성된 노드 풀을 생성합니다.
  • image_type 매개변수를 사용해 노드에서 사용하는 이미지를 설정할 수 있습니다. 워크로드가 주로 Windows 이미지에 의존하는 경우 windows_ltsc_containerd로 설정할 수 있습니다.

이 구성을 보여주는 그림은 다음과 같습니다.

클러스터 구성 그림

GitLab Runner GRIT 구성#

결과로 생성되는 GRIT의 GitLab Runner 구성은 다음과 유사합니다.

gitlab_pat         = "glpat-REDACTED"
gitlab_project_id  = GITLAB_PROJECT_ID
runner_description = "my-grit-gitlab-runner"
runner_image       = "registry.gitlab.com/gitlab-org/ci-cd/gitlab-runner-ubi-images/gitlab-runner-ocp:amd64-v17.3.1"
helper_image       = "registry.gitlab.com/gitlab-org/ci-cd/gitlab-runner-ubi-images/gitlab-runner-helper-ocp:x86_64-v17.3.1"
concurrent     = 20
check_interval = 1
runner_tags    = ["my-custom-tag"]
config_template    = <

앞선 구성에서:

  • pod_spec 매개변수를 사용하면 GitLab Runner를 실행하는 pod의 노드 셀렉터를 설정할 수 있습니다. 이 구성에서는 GitLab Runner가 runner-manager 노드 풀에 설치되도록 노드 셀렉터를 "app" = "gitlab-runner"로 설정합니다.
  • config_template 매개변수는 GitLab Runner Manager가 실행하는 모든 job에 기본 제한을 제공합니다. 또한 설정된 값이 기본값을 초과하지 않는 한 이러한 제한의 오버라이트를 허용합니다.
  • job 실패 시 디버깅을 쉽게 하기 위해 기능 플래그 FF_PRINT_POD_EVENTS와 print_pod_warning_events 설정도 지정합니다. 자세한 내용은 기능 플래그 문서와 러너 API 권한 구성 문서를 참고합니다.

가상 사용 사례의 실제 적용#

다음 정보를 고려합니다.

  • 다뤄야 하는 job 프로필이 몇 개인지 확인합니다.
    • 프로필 2개(제공된 사양은 helper 제한을 반영합니다):
      • 중간 규모 job: 300m CPU, 200 MiB
      • CPU 집약적 job: 1 CPU, 1 GiB
  • 실행해야 하는 GitLab Runner Manager 수를 확인합니다.
    • 1개.
  • 예상 워크로드를 확인합니다.
    • 중간 규모 job 최대 50개 동시 실행
    • CPU 집약적 job 최대 25개 동시 실행

GKE 구성#

  • 중간 규모 job에 필요한 리소스:
    • CPU: 300m * 50 = 5 CPU(근사치)
    • 메모리: 200 MiB * 50 = 10 GiB
  • CPU 집약적 job에 필요한 리소스:
    • CPU: 1 * 25 = 25
    • 메모리: 1 GiB * 25 = 25 GiB

GKE 클러스터는 다음을 갖춰야 합니다.

  • GitLab Runner Manager용 노드 풀(로그 처리 부담이 크지 않다고 가정): e2-standard-2 노드 1개
  • 중간 규모 job용 노드 풀: e2-standard-4 노드 3개
  • CPU 집약적 job용 노드 풀: e2-highcpu-32 노드 1개(32 vCPU, 32 GiB 메모리)
google_project     = "GCLOUD_PROJECT"
google_region      = "GCLOUD_REGION"
google_zone        = "GCLOUD_ZONE"
name               = "my-grit-gke-cluster"
node_pools = {
  "runner-manager" = {
    node_count = 1,
    node_config = {
      machine_type = "e2-standard-2",
      image_type   = "cos_containerd",   #Linux OS container only. Change to windows_ltsc_containerd for Windows OS container
      disk_size_gb = 50,
      disk_type    = "pd-balanced",
      labels = {
        "app" = "gitlab-runner",
      }
    },
  },
  "medium-pool" = {
    node_count = 3,
    node_config = {
      machine_type = "e2-standard-4",    #4 vCPU, 16 GB each
      image_type   = "cos_containerd",   #Linux OS container only. Change to windows_ltsc_containerd for Windows OS container
      disk_size_gb = 150,
      disk_type    = "pd-balanced",
      labels = {
        "app" = "gitlab-runner-job"
      }
    },
  },
  "cpu-intensive-pool" = {
    node_count = 1,
    node_config = {
      machine_type = "e2-highcpu-32", #32 vCPU, 32 GB each
      image_type   = "cos_containerd",
      disk_size_gb = 150,
      disk_type    = "pd-balanced",
      labels = {
        "app" = "gitlab-runner-job"
      }
    },
  },
}

GitLab Runner 구성#

현재 GRIT 구현은 한 번에 하나 이상의 러너를 설치할 수 없습니다. 제공된 config_template은 앞선 예시처럼 node_selection이나 다른 제한과 같은 구성을 설정하지 않습니다. 간단한 구성은 CPU 집약적 job에 허용되는 최대 오버라이트 값을 허용하고 .gitlab-ci.yml 파일에 올바른 값을 설정합니다. 결과로 생성되는 GitLab Runner 구성은 다음과 유사합니다.

gitlab_pat         = "glpat-REDACTED"
gitlab_project_id  = GITLAB_PROJECT_ID
runner_description = "my-grit-gitlab-runner"
runner_image       = "registry.gitlab.com/gitlab-org/ci-cd/gitlab-runner-ubi-images/gitlab-runner-ocp:amd64-v17.3.1"
helper_image       = "registry.gitlab.com/gitlab-org/ci-cd/gitlab-runner-ubi-images/gitlab-runner-helper-ocp:x86_64-v17.3.1"
concurrent     = 100
check_interval = 1
runner_tags    = ["my-custom-tag"]
config_template    = <

.gitlab-ci.yml 파일은 다음과 유사합니다.

  • 중간 규모 job의 경우:

    variables:
      KUBERNETES_CPU_LIMIT: "200m"
      KUBERNETES_MEMORY_LIMIT: "100Mi"
      KUBERNETES_HELPER_CPU_LIMIT: "100m"
      KUBERNETES_HELPER_MEMORY_LIMIT: "100Mi"
    
    tests:
      image: some-image:latest
      script:
      - command_1
      - command_2
      # ...
      - command_n
      tags:
        - my-custom-tag
    
  • CPU 집약적 job의 경우:

    variables:
      KUBERNETES_CPU_LIMIT: "0.75"
      KUBERNETES_MEMORY_LIMIT: "900Mi"
      KUBERNETES_HELPER_CPU_LIMIT: "150m"
      KUBERNETES_HELPER_MEMORY_LIMIT: "100Mi"
    
    tests:
      image: custom-cpu-intensive-image:latest
      script:
      - cpu_intensive_command_1
      - cpu_intensive_command_2
      # ...
      - cpu_intensive_command_n
      tags:
        - my-custom-tag
    
Note

구성을 더 쉽게 하려면 job 프로필마다 클러스터당 GitLab Runner 1개를 사용합니다. GitLab이 동일한 클러스터에 여러 GitLab Runner를 설치하거나 config.toml 템플릿에 여러 [[runners]] 섹션을 지원할 때까지는 이 방식을 권장합니다.

모니터링 및 옵저버빌리티 설정#

배포 단계의 마지막 단계로 러너 호스트 환경과 GitLab Runner를 모니터링하는 솔루션을 구축해야 합니다. 인프라 수준, 러너, CI/CD job 메트릭은 CI/CD 빌드 인프라의 효율성과 안정성에 대한 인사이트를 제공합니다. 또한 Kubernetes 클러스터, GitLab Runner, CI/CD job 구성을 조정하고 최적화하는 데 필요한 인사이트도 제공합니다.

모니터링 모범 사례#

  • job 수준 메트릭(job 소요 시간, job 성공률 및 실패율)을 모니터링합니다.
    • job 수준 메트릭을 분석하려면 어떤 CI/CD job이 가장 자주 실행되고 전체적으로 가장 많은 컴퓨팅 및 RAM 리소스를 소비하는지 파악합니다. 이 job 프로필은 최적화 기회를 평가하기 위한 좋은 출발점입니다.
  • Kubernetes 클러스터 리소스 사용률을 모니터링합니다.
    • CPU 사용률
    • 메모리 사용률
    • 네트워크 사용률
    • 디스크 사용률

진행 방법에 대한 자세한 내용은 GitLab Runner 전용 모니터링 페이지를 참고합니다.

최적화#

CI/CD 빌드 환경을 최적화하는 작업은 지속적인 프로세스입니다. CI/CD job의 유형과 양이 끊임없이 변화하므로 지속적인 관여가 필요합니다.

CI/CD 및 CI/CD 빌드 인프라에 대해 조직 고유의 목표가 있을 것입니다. 따라서 첫 번째 단계는 최적화 요구 사항과 정량화 가능한 목표를 정의하는 것입니다.

다음은 고객 전반에서 확인한 최적화 요구 사항의 예시입니다.

  • CI/CD job 시작 시간
  • CI/CD job 소요 시간
  • CI/CD job 안정성
  • CI/CD 컴퓨팅 비용 최적화

다음 단계는 Kubernetes 클러스터의 인프라 메트릭과 함께 CI/CD 메트릭을 분석하는 것입니다. 분석해야 할 핵심 상관관계는 다음과 같습니다.

  • Kubernetes 네임스페이스별 CPU 사용률
  • Kubernetes 네임스페이스별 메모리 사용률
  • 노드별 CPU 사용률
  • 노드별 메모리 사용률
  • CI/CD job 실패율

일반적으로 Kubernetes에서 높은 CI/CD job 실패율은(불안정한 테스트로 인한 실패는 제외) Kubernetes 클러스터의 리소스 제약에서 비롯됩니다. 이러한 메트릭을 분석하여 Kubernetes 클러스터 구성에서 CI/CD job 시작 시간, job 소요 시간, job 안정성, 인프라 리소스 사용률 간 최적의 균형을 달성합니다.

모범 사례#

  • 조직 전체에서 CI/CD job을 job 유형별로 분류하는 프로세스를 수립합니다.
  • Kubernetes에서 GitLab CI/CD 빌드 인프라와 CI/CD job 유형을 최적화하는 접근 방식과 모니터링 구성을 모두 단순화하는 job 유형 분류 프레임워크를 수립합니다.
  • 각 job 유형에 클러스터에서 전용 노드를 할당하면 CI/CD job 성능, job 안정성, 인프라 사용률 간 최상의 균형을 얻을 수 있습니다.

CI/CD 빌드 환경의 인프라 스택으로 Kubernetes를 사용하면 상당한 이점을 얻을 수 있습니다. 다만 Kubernetes 인프라를 지속적으로 모니터링하고 최적화해야 합니다. 옵저버빌리티 및 최적화 프레임워크를 구축하면 월 수백만 건의 CI/CD job을 지원할 수 있습니다. 리소스 경합을 없애고, 결정론적인 CI/CD job 실행과 최적의 리소스 사용을 달성할 수 있습니다. 이러한 개선은 운영 효율성과 비용 최적화로 이어집니다.

다음 단계#

더 나은 사용자 경험을 제공하려면 다음 단계를 수행합니다.

  • 동일한 클러스터에 여러 GitLab Runner를 설치하는 기능을 지원합니다. 이를 통해 여러 job 프로필을 처리해야 하는 시나리오를 더 잘 관리할 수 있습니다(리소스 오남용을 방지하도록 GitLab Runner를 적절히 구성할 수 있습니다).
  • GKE 노드 오토스케일링을 지원합니다. 이를 통해 GKE가 워크로드에 따라 확장 및 축소되어 비용을 절감할 수 있습니다.
  • job 메트릭 모니터링을 활성화합니다. 이를 통해 관리자가 실제 사용량을 기반으로 클러스터와 GitLab Runner를 더 잘 최적화할 수 있습니다.